TL;DR
新开一个强化学习的专题, 因为最近一段时间工作上需要去做一些Agent RL相关的事情.
按照传统的方式应该从马尔可夫决策过程讲起, 然后讲Bellman方程, 接着去讲价值迭代和策略迭代, 逐渐转向无模型的蒙特卡洛方法, 紧接着阐述一些随机近似理论再谈谈一些增量的时序差分算法, 再从表格型表示转移到函数表示来介绍值函数方法, 然后过渡到策略梯度方法, 其中很多案例要么是multiarm bandit, 要么是走迷宫一类的. 我们可以把这一些内容称为传统强化学习, 直到最后讲到Actor-Critic方法才会逐渐进入LLM RL的场景, 很多人估计到此时已经早就消磨完所有的耐心.
另一方面是RL本身就是学习“做什么才能使得数值化的收益信号最大化”. 学习者本身不会被告知采取什么动作, 而是必须自己通过尝试发现哪些动作会产生丰厚的收益. 而这个过程中动作往往影响的不仅仅是即时收益, 也会影响到下一个状态, 从而影响随后的收益. 因此试错和延迟收益成了RL最重要最显著的特征.
紧接着很多迭代的算法, 在没有很好的前置数学基础时使得我们会逐渐的去怀疑, 为什么这么做了就最优了, 会不会陷入到某个局部最优. 有些算法迭代过程的中间值带入环境中又看上去不成立, 这一系列怀疑使得我们去怀疑算法的正确性. 这些背后的数学知识或许独立出来单独成为一个专题挺好的. 或者直接参考西湖大学赵老师的《强化学习的数学原理》[1]. 中英文的书/PPT和视频教程都有, 挺适合深入的去看. 然后在此基础上认真读一下Sutton的《Reinforcement Learning: An Introduction》[2]并把书中的例子都自己代码实现一下会更完整. 或者去看看王老师的《深度强化学习》[3], 也是一本很好的教材和视频课.
这些基础的内容已经有很好的资料了, 因此我们这个专题关注的是在现阶段大模型相关的RL算法和框架. 我们会从一个很简单的框架RL2: Ray Less Reinforcement Learning[4] 开始入手LLM的RL算法, 然后进一步再过渡到slime[5], 最后进一步再过渡到Agent RL的训练和推理上.
我们准备按照时间线的方式逐渐介绍:
首先是一个简单的介绍, 从 SFT 到LLM RLHF中的 PPO 算法来完成一个基础的介绍作为第一篇来回顾大模型强化学习算法的第一阶段, 本文目录如下:
1. 概述
2. 从SFT谈起
3. 拒绝采样
4. Reward Model
5. REINFORCE
6. Actor-Critic
7. PPO
7.1 重要性采样
7.2 Clip
7.3 优势函数
7.4 PPO训练过程
7.5 PPO+KL penalty
7.6 ChatGPT的训练流程
8. PPO的一些缺陷及未来演进1. 概述
当我们完成一个预训练模型后, 我们以Qwen2.5-3B为例, 通常它在预训练阶段吸收了大量的语料, 虽然知识储备非常惊人, 但是很难与用户进行流畅的对话, 例如下面是Qwen2.5-3B的Base模型输出的结果
因此我们需要进行足够的后训练任务后, LLM才会变得实用. 例如下面是Qwen2.5-3B-Instruct模型的输出:
早期的尝试是通过利用社交媒体挖掘的对话或者从特定任务数据集中合成的数据来用于微调. 前期是一些监督式微调(Supervised Finetuning, SFT). 但是从2016年OpenAI发表论文《Deep reinforcement learning from human preferences》[6]开始, 逐渐采用人类反馈和偏好的强化学习算法开始胜出, 伴随着2017年PPO算法《Proximal Policy Optimization Algorithms》[7]的出现, 再到2019年出现《Fine-Tuning Language Models from Human Preferences》[8]用于GPT2, 以及2020年的《Learning to summarize from human feedback》[9]使用RLHF用于新闻摘要任务, 此时RLHF很多效果基线已经超过了监督学习, 人类评估者更偏好RLHF生成的摘要. 接下来2023年的InstructGPT/ChatGPT确立了 SFT(有监督微调) -> RM(奖励模型训练) -> PPO(近端策略优化) 的三步走流程.
然后传统的RLHF只关注最终答案(Outcome Reward),模型可能会胡乱推理凑出正确答案, 或者无法解决复杂的数学/科学问题. 逐渐研究从ORM转移到PRM, 研究重点转向过程奖励模型(PRM). 接着通过RL训练模型在输出答案前进行隐式的“思维链”探索的范式出现. OpenAI o1的发布标志着“思考”本身成为了可以被RL优化的过程.
另一个分支是在2023年开始, 模型生成代码 -> 解释器执行 -> 错误信息反馈给模型 -> 修正的范式开始尝试用于coding任务, 接着RL和编译器结合, 开始大规模使用代码执行结果作为Reward, 这就出现了一系列coding模型, 或者对于数学类任务也具有可验证的结果, 因此通常把这类有客观可验证结果的范式称为RLVR(基于可验证结果的强化学习)
接着通过RL训练模型正确调用API, function call / tool use一类的早期的agent类模型逐渐出现. 然后随着MCP和大量Agent框架的出现, 利用Agent在环境中执行动作, 根据任务完成情况获得Reward的范式出现, 而这种范式非常接近于传统的RL算法(Agent执行的沙箱作为环境, 模型作为策略) 逐渐将任务泛化到各种各样的应用(BrowserUse, computerUse, mobileuse).
整个过程我们可以看到, RL在LLM中已经从最初的“调教语气”(对齐)进化为“锻造大脑”(推理)和“训练手脚”(Agent)
我们接下来会详细介绍RLHF中的PPO算法, 但是它需要四个模型
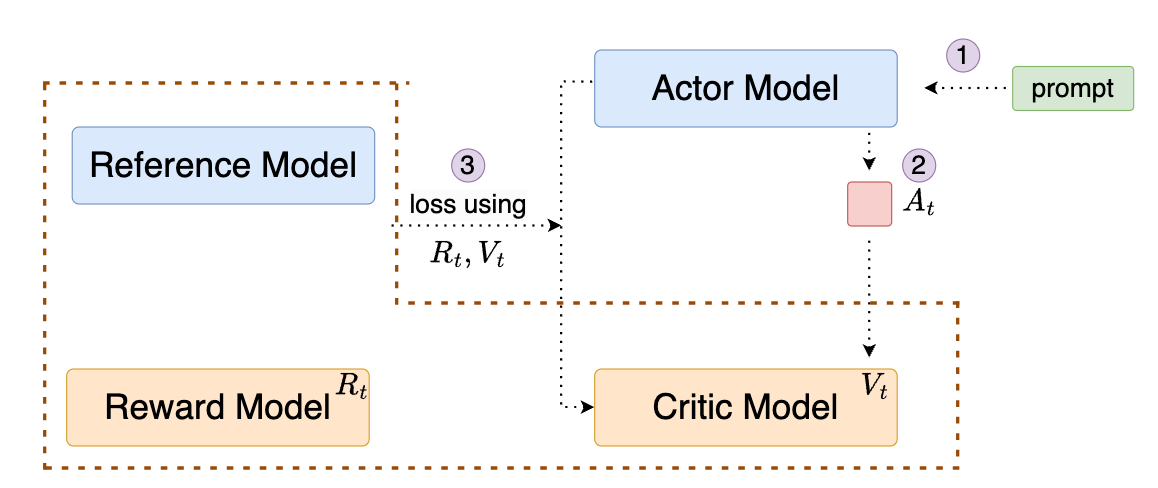
直接介绍算法本身也会比较复杂, 因此我们从SFT谈起, 然后逐渐从算法缺陷上增加Reward Model, 再演进到Actor-Critic引入Critic Model, 最后再增加Reference Model的方式来介绍.
2. 从SFT谈起
正如前一章所述, 预训练大语言模型通过在海量无标签文本数据上进行“下一个词预测”任务, 学会了关于世界的大量事实知识, 语法结构和一定的推理能力. 然而, 这时的模型像一个知识渊博但行为模式怪异的“书呆子”. 你问它 “推荐一个杭州好玩的地方?”, 它可能会回答“可以去西湖. 🆕user:你能推荐一个乌镇好玩的地方吗? 🆕assistant: 可以去西栅景区.”, 因为它只学会了模仿文本的模式, 而不是直接回答问题. 它缺乏“对话”或“执行指令”的概念.
如何让这个“书呆子”模型转变为一个乐于助人, 能够准确理解并遵循人类指令的“得力助手”? 这就是SFT要解决的核心问题. SFT的目标是 对齐 (Alignment), 即让模型的行为模式与人类的意图和期望对齐.
首先SFT需要通过人工标注/众包 或者其他更大的模型蒸馏来生产一个高质量的数据集, 然后将prompt作为指令, 将指令和回答拼接成一个完整的文本序列, 并进行特殊格式化. 例如, 使用特殊的Token来分隔指令和回答, <s>[INST] {instruction} [/INST] {response} </s>.
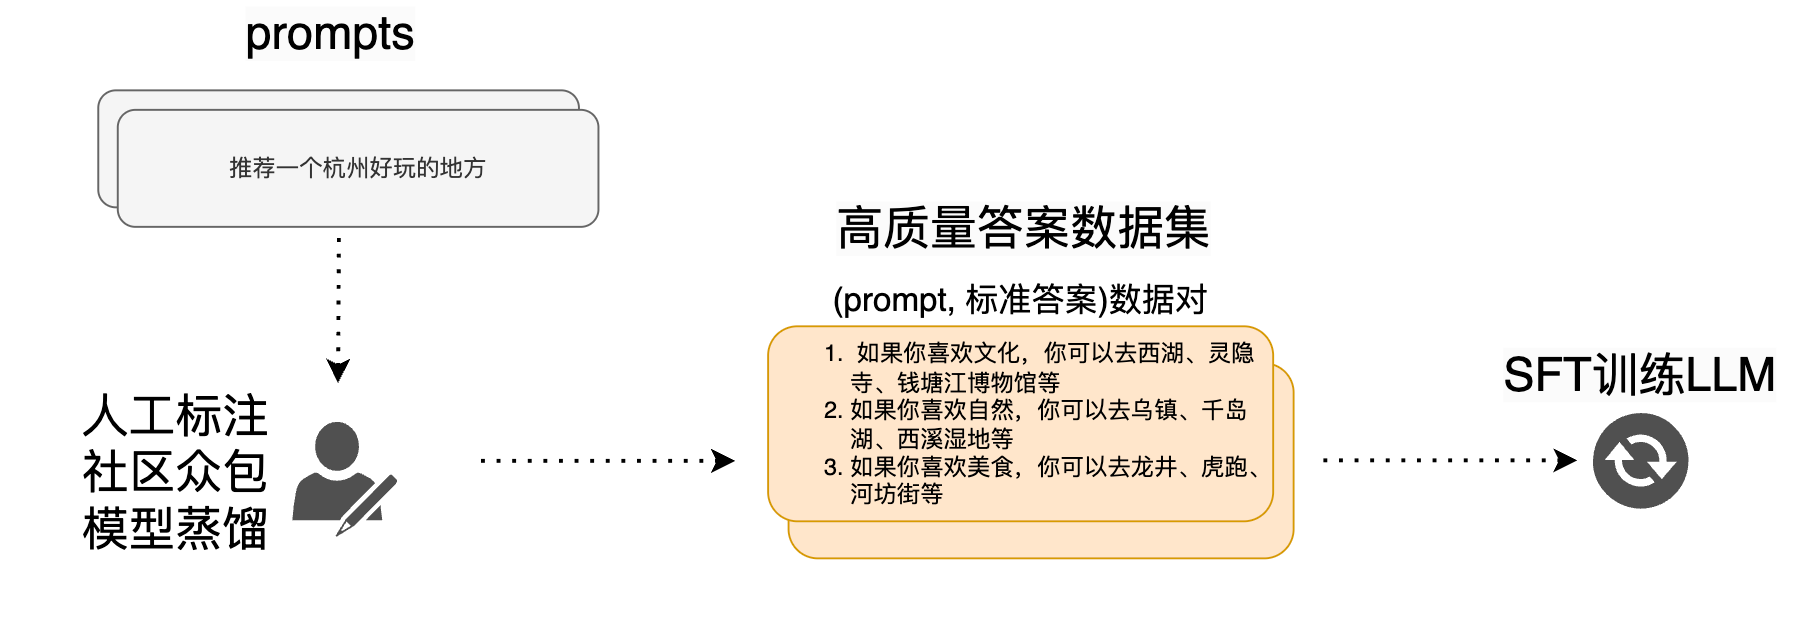
然后在SFT中, 似然 (Likelihood) 指的是, 在给定指令 (Instruction) 的情况下, 模型能够生成我们指定的那个标准答案 (Response) 的概率. 假设我们的标准答案是 , 也就是一个由 个词(token)组成的序列. 根据条件概率的链式法则, 模型生成这个完整答案的概率是:
- : 这是我们的似然函数. 它表示在给定指令 和当前模型参数 的情况下, 生成答案 的总概率.
- : 是模型在看到指令 后, 生成答案的第一个词 的概率.
- : 是模型在看到指令 和答案的第一个词 后, 生成第二个词 的概率.
- 以此类推. 似然值越高, 说明模型认为我们提供的这个标准答案“越合理”, “越可能”被生成. 在数学和计算上, 直接处理一长串小概率值的乘积 (上面的公式) 会导致数值下溢 (结果趋近于0), 非常不稳定. 因此, 我们使用一个等价的技巧: 最大化对数似然 (Maximizing the Log-Likelihood).对数似然就是对上面的概率值取对数:
最大化一个正数的对数等价于最大化这个数本身. 这样做的好处是:
- 变乘为加: 避免了数值下溢, 计算更稳定.
- 便于求导: 在反向传播中, 加法的导数比乘法的导数更容易计算.
那么实质上我们每次SFT就是需要最大化输出结果和标准答案之间的相似度:
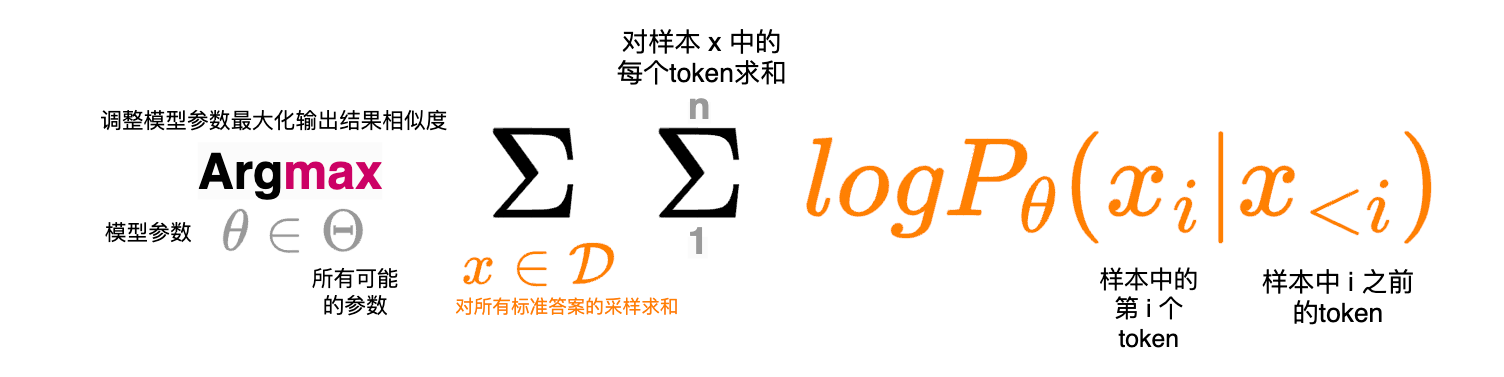
但是这样的方式本质是让模型产生的输出越来越像标准答案, 就像只给了模型一条鱼, 但没有授之以渔
因此SFT存在一个与泛化能力相关的根本缺陷. 如果让模型这样运行, 鹦鹉学舌地重复标准答案可能会导致泛化能力下降, 甚至产生幻觉.
3. 拒绝采样
在SFT中, 整个模型处于被动状态, 训练目标仅是最大化的生成token和样本的似然度. 由于 LLM 输出的是概率分布, 我们可以简单地对单个问题进行采样, 得到许多不同的答案, 这可以通过提高采样温度来实现. 现在我们得到了一大堆候选答案进行评估.
为了筛选出最佳答案, 因此我们需要对答案进行评分. 具体流程如下:
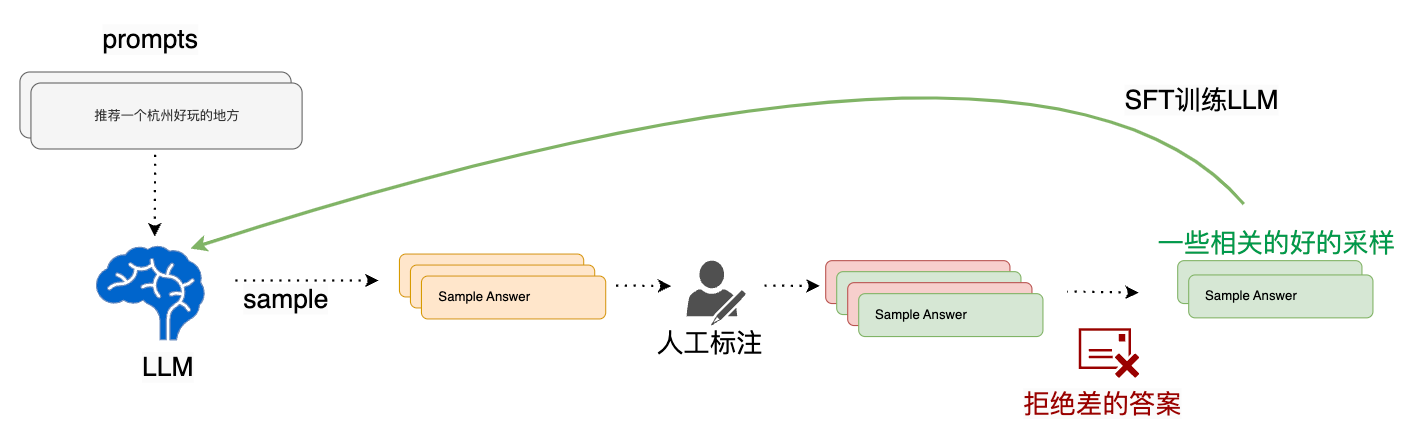
此时我们只需要对挑选出来的好的答案进行SFT即可
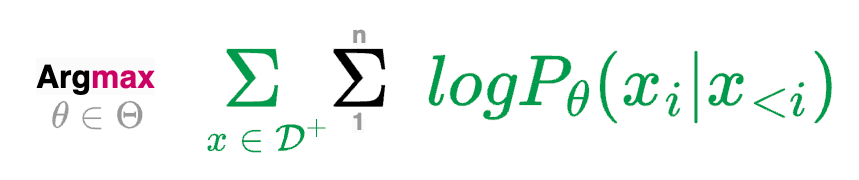
但是我们会很快发现一个问题, 整个过程的瓶颈在收集标注者的评分上, 这个过程会非常漫长影响整个模型SFT的迭代速度. 那么很自然的会想到, 能否有一个模型来实现整个流程的自动化.
4. Reward Model
对于拒绝采样中,人工标注评分的低效和差异较大的问题, 我们可以利用标注者收集的评分来训练一个模型, 让这个模型理解人类偏好, 并可以用于拒绝采样. 通常我们可以把这个模型称为奖励模型(Reward Model).
我们LLM自身就是一个很好的语言理解魔心跟, 可以成为一个很好的Reward Model, 即我们将用它来初始化一个奖励模型, 最后到词表的投影可以取消, 然后换为一个标量头用于生成最后的评分. 整个过程如下:
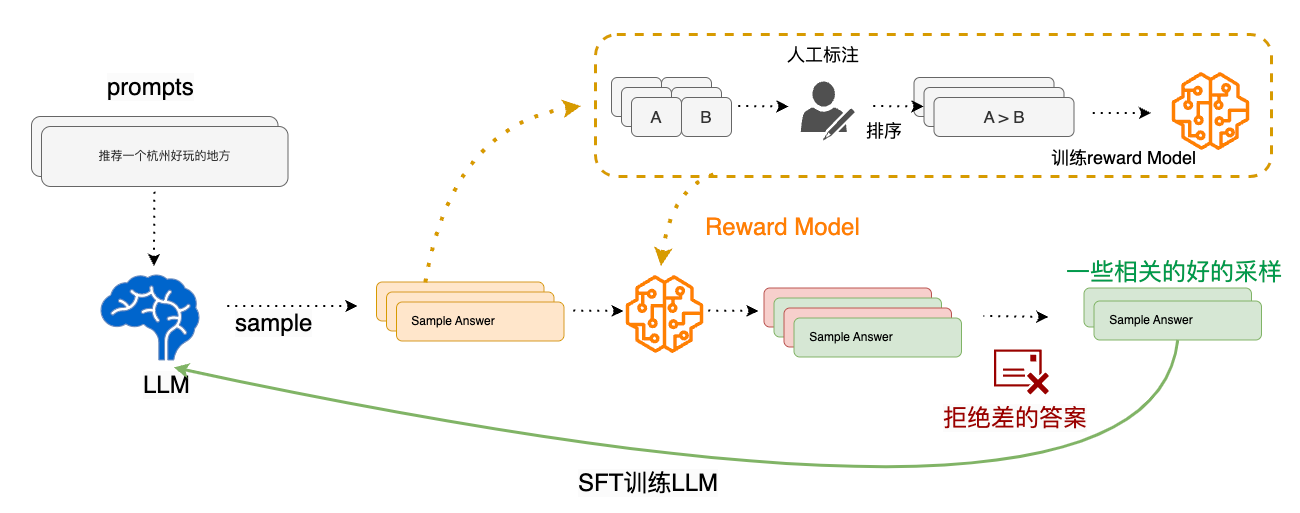
- 首先, 针对同一个指令 (Prompt) , 我们用SFT模型生成多个不同的回答, 例如 .
- 然后, 我们将这些回答两两组合, 让标注人员进行比较, 指出哪个更好. 例如, 标注员认为 比 好, 比 好.
- 最终, 我们整理出的数据集是大量的四元组: , 其中 是指令, (chosen) 是被选中的更好的回答, (rejected) 是被拒绝的较差的回答.
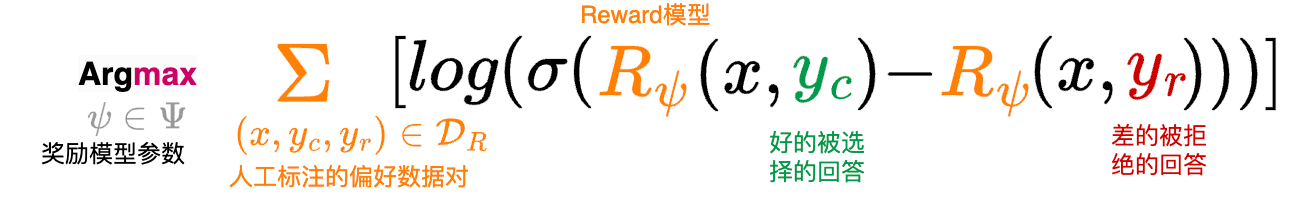
然后我们构建Reward模型的损失函数, 这个损失函数的设计借鉴 Bradley-Terry模型. 该模型假设, 两个选项被偏好的概率, 取决于它们各自内在“实力”分数的差异. 我们假设一个回答 的“好坏”可以被一个潜在的标量分数 所表示. 那么, 人类偏好 而不是 的概率, 可以用 sigmoid 函数 来建模: 这里的 符号代表“更被偏好”. 是两个回答奖励分数的差值.
- 如果RM认为 远好于 , 差值会很大, .
- 如果RM认为 远好于 , 差值会是很大的负数, .
- 如果RM认为两者差不多, 差值接近0, .
即整个奖励模型训练目标如下:
拒绝采样和奖励建模是通过改变训练样本 LLM 的数据分布来实现的, 但是也遇到一个潜在的问题, 通常生成数百万条结果中, 大概只能选出数千条, 这样做效率还是很低下.
5. REINFORCE
那么接下来, 我们是否能够考虑充分利用这些数据, 例如模型能够从错误中汲取学习信号. 我们可以通过设计奖励模型奖励好的案例, 同时对于差的案例给予一个负数的Reward, 当奖励为负数时, 能否引导模型输出的概率分布远离那些拒绝的样本? 这样就引入了强化学习模型.
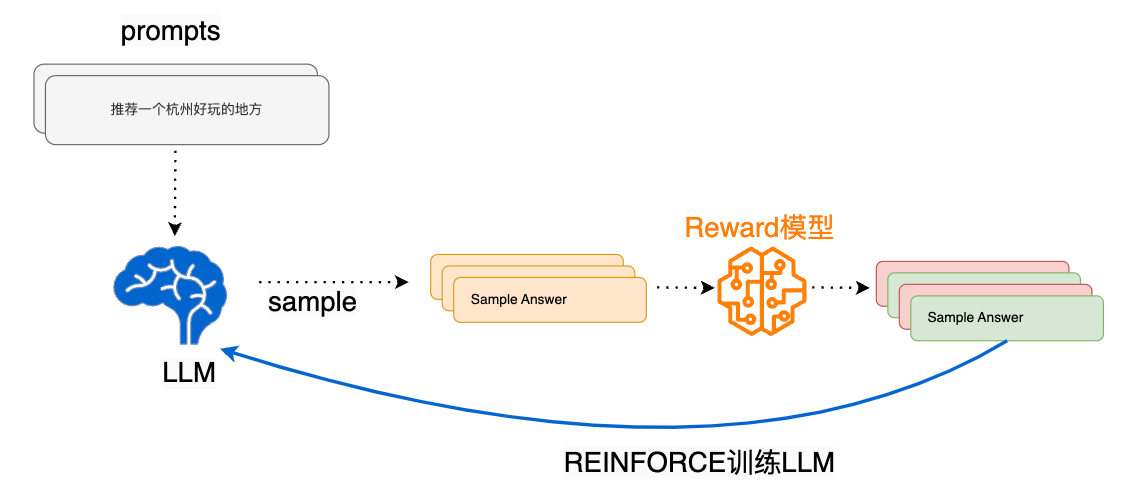
通常我们需要在这里引入策略梯度定理来进行详细阐述, 但是我们为了保证整个主线的聚焦, 先把这部分内容略去在稍后的附录中添加. 而在这里我们仅给一个结论: 可以直接使用Reward模型生成的奖励加权每个样本的对数似然来作为优化的目标函数
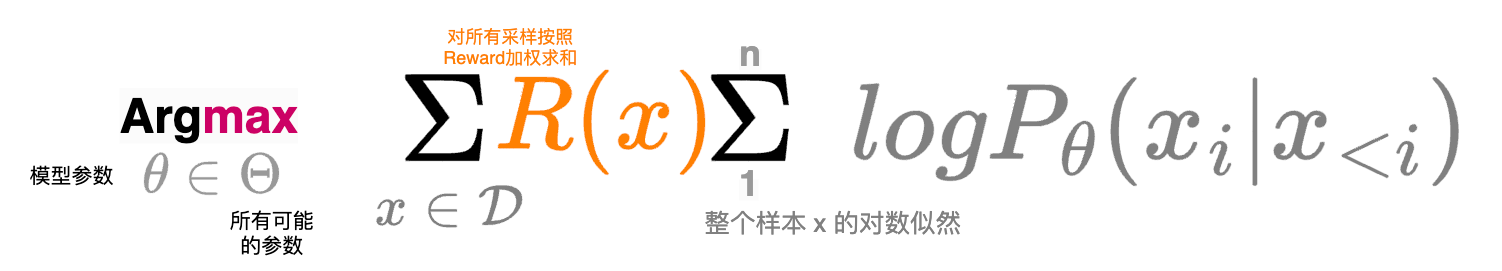
学习过程如下:
- 采样 (Rollout/Sampling):
- 从一个Prompt集合中, 使用当前的模型生成一批完整的回答. 这就构成了我们的数据集 .
- 评估 (Evaluation):
- 对于每个生成的回答 , 使用一个已经训练好的奖励模型(RM)来给它打分, 得到奖励 .
- 例如, RM给出的分数是 .
- 构建损失函数 (Loss Formulation):
- 我们的目标是最大化 .
- 在机器学习中, 最大化一个目标
J等价于最小化它的负值-J. - 因此, 对于单个样本 , 我们可以定义其损失 (Loss) 为:
- 这个损失函数可以被看作一个加权的交叉熵损失. 普通的交叉熵损失是 , 而这里我们用奖励 对整个样本的损失进行了加权.
- 梯度计算与反向传播:
- 对于一个样本 , 机器学习框架会自动计算这个 关于模型参数 的梯度 .
- 根据链式法则, 梯度 正比于 .
- 参数更新:
- 优化器(如Adam)使用计算出的梯度来更新模型的参数 :
- 由于 , 参数更新的方向会受到 的正负和大小的直接影响.
- 若 : 损失为负, 梯度指向降低损失的方向, 实际上是增加了 的方向, 使得模型更倾向于生成 .
- 若 : 损失为正, 梯度指向降低损失的方向, 实际上是减小了 的方向, 使得模型更不倾向于生成 .
6. Actor-Critic
回顾REINFORCE的更新逻辑: 它用整个轨迹的最终奖励 来“同等”地调整轨迹中所有动作的概率. 这带来了两个严重问题:
- 奖励信号的噪声极大: 假设LLM生成一个100词的回答. 最终奖励 可能是8.5分. 这个分数是对整个100词的综合评价.REINFORCE算法将这个8.5分的“功劳”或“过错”平均(或按log-prob加权)分配给了这100个词中的每一个. 但很可能, 这个回答中95个词都写得很好, 只有5个词是事实错误导致了扣分. 算法不但没有惩罚那5个坏词, 反而还用一个正奖励(8.5分)去“强化”了它们. 反之, 如果一个回答因为一句话写得特别出彩而获得高分, REINFORCE也会把这份功劳错误地分给其他平庸的词.结果: 梯度估计充满了噪声. 模型更新的方向摇摆不定, 就像在大雾中开车, 忽左忽右, 需要非常长的时间才能找到正确的道路. 这种不稳定性对于训练成本高昂的LLM是不可接受的.
- 样本效率低下 (Sample Inefficiency): 由于梯度信号噪声大, 模型需要采样海量的轨迹(生成海量的回答)才能从噪声中统计出真正有用的梯度方向. 这使得训练过程极其缓慢且昂贵.
随着我们深入强化学习算法, 我们需要引入一些强化学习相关的术语:
- 智能体 (Agent): LLM模型.
- 策略 (Policy) : 智能体(模型)的策略. 在给定状态 (Prompt) 的情况下, 采取行动 (生成一个词) 的概率. 整个模型的参数 定义了这个策略.
- 状态 (State) : 输入的指令 (Prompt).
- 行动 (Action) : 模型生成的每一个词 (token).
- 轨迹 (Trajectory) : 从开始到结束, 模型生成的一个完整回答序列. .
对于自回归模型的 State 和 Action 如下图所示:
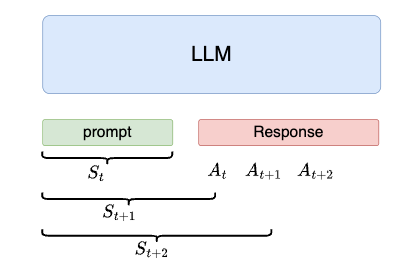
- 在 时刻,环境的状态为
- LLM作为智能体观测到 , 采取相应动作 , 即根据当前的 prompt(state) 生成一个token(action)
- LLM作为智能体采取 后, 环境状态变为 , 此时 和 产生的token构成一个新的promt(即) 然后采取相应的动作 生成一个新的token, 并构成一个新的状态
然后, 我们希望模型在每一步都能找到收益最大化的行动, 从而最终获得高回报. 而不是像前一章那样直到生成完后再给一个Reward. 我们能否像下棋那样, 不再仅仅奖励/抑制整个轨迹上的行动, 而是会奖励/抑制轨迹中的单个行动? 但是我们需要思考的是, 我们难道不能直接对未完成的任务给予奖励吗? 事实并非如此, 奖励模型关注的是任务完成的即时质量, 而非其潜在的未来质量. 同时奖励模型对于未完成的答案也会评价为一个较低的分数.
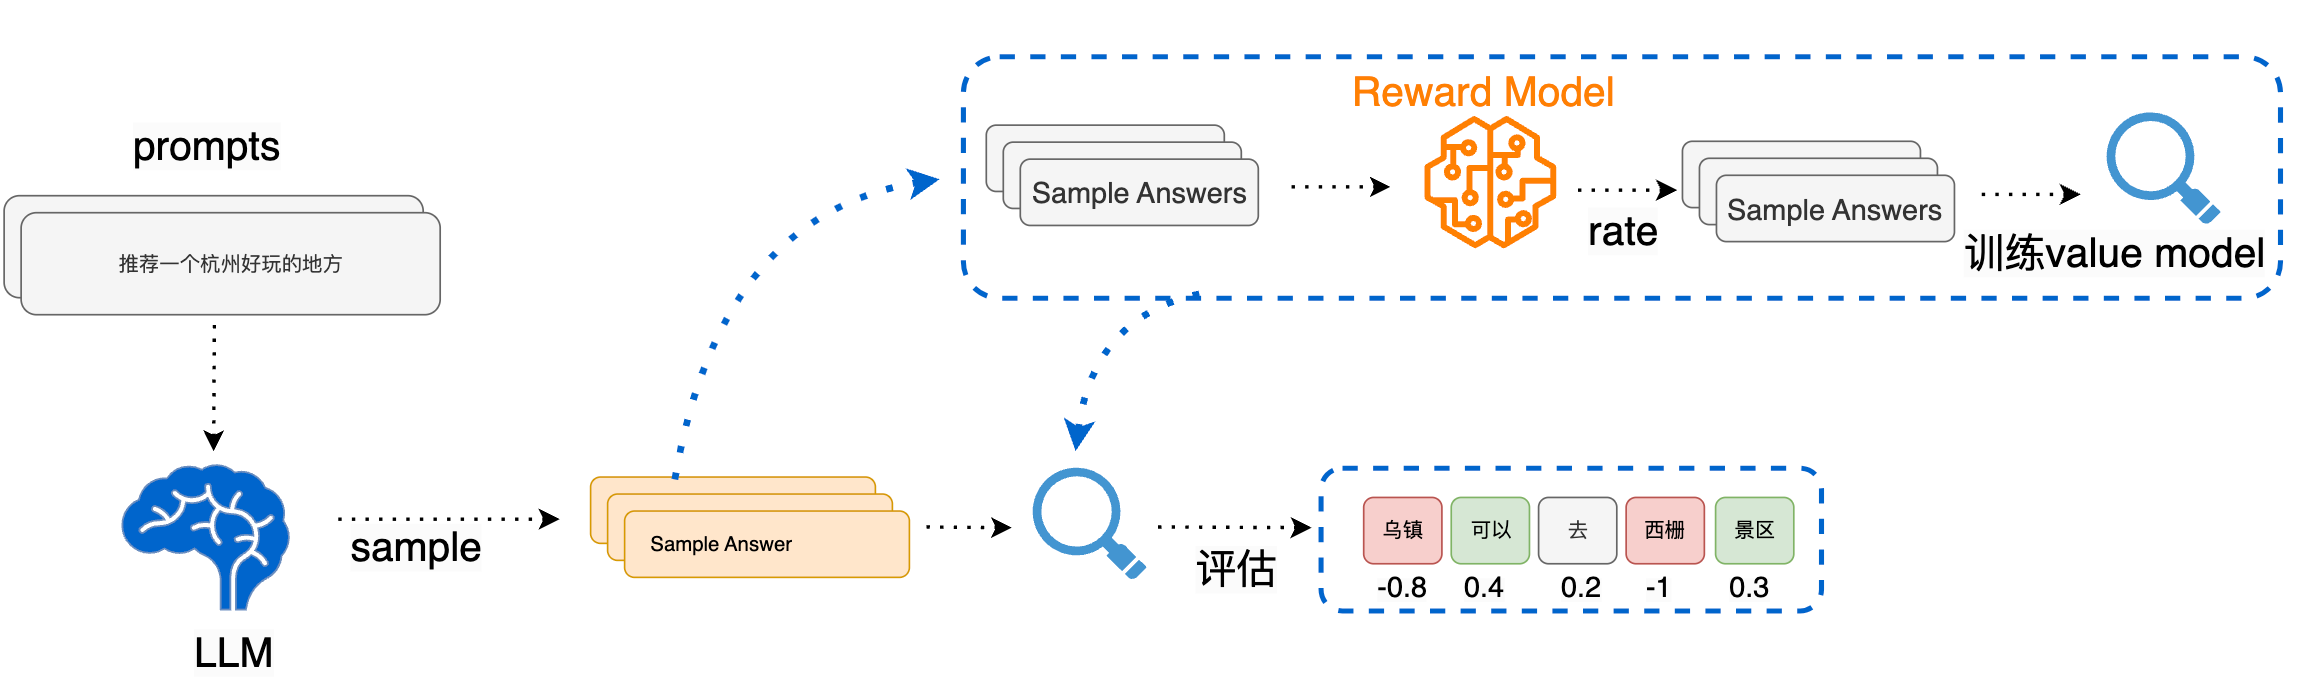
因此我们需要评估一个在当前状态 时的质量评估, 这里我们需要引入一个价值函数, 即 : 时刻的总收益, 注意这个收益蕴涵了“即时”和“未来”的概念. 为了训练价值模型, 我们将使用一个简单的回归目标. 价值模型会尝试从轨迹中的任何中间状态预测完整轨迹的奖励. 这是一个简单的监督式训练设置:我们可以通过奖励模型获取这些信息. 如下图所示:
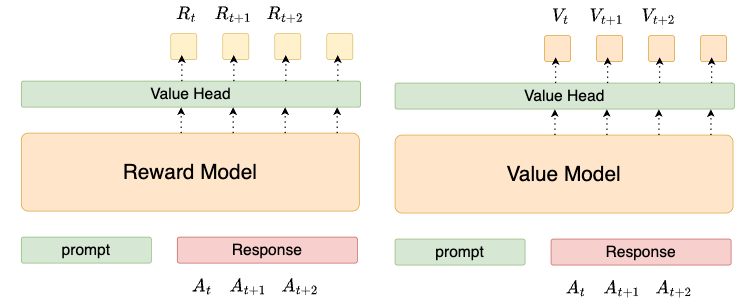
我们训练 Value 模型的目标是一个简单的回归:
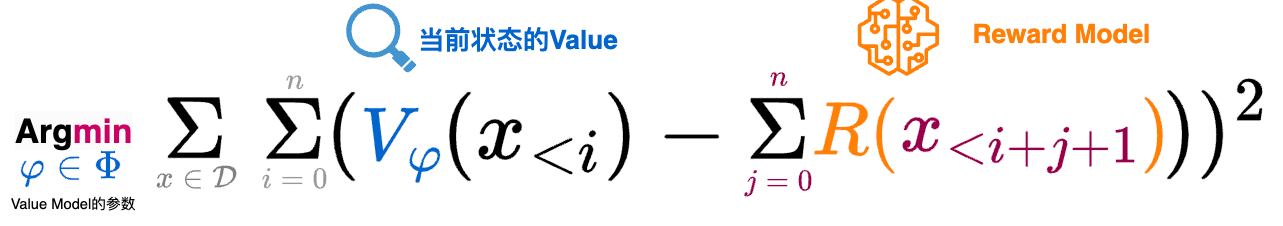
则整个价值评估的流程如下:
有了价值模型了, 我们就需要考虑如何去更新策略模型, 即我们需要训练的LLM. 我们希望根据特定动作是否能将我们带入更有价值的状态, 来调整我们对该动作的奖励/抑制程度. 为此我们需要计算该行动的优势. 优势是指我们采取该行动所获得的(或损失的)价值, 与我们多次采样该策略后预期获得的平均价值相比. 一旦我们有了价值模型和奖励模型, 我们就可以通过广义优势估计(Generalized Advantage Estimation ,GAE)来计算优势.
综合起来, 我们实现了Advantage Actor-Critic(A2C)算法, 其中Actor是我们的需要训练的LLM, Critic就是我们的价值模型.
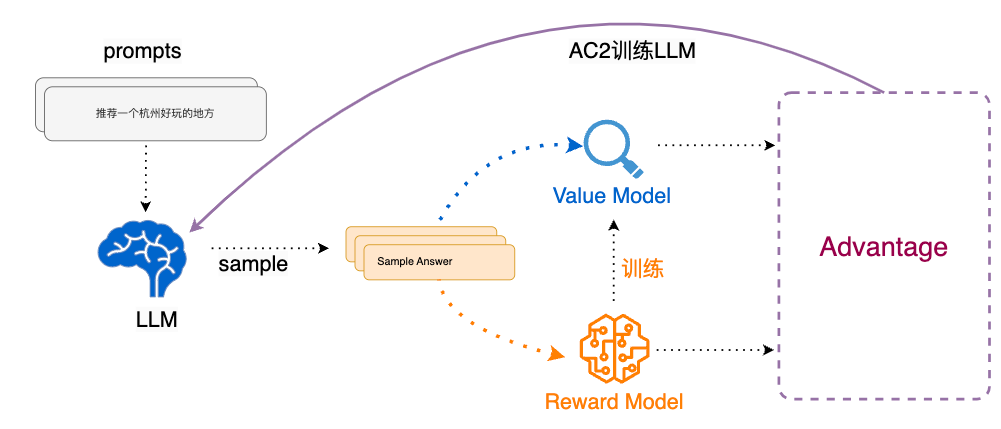
对于训练的目标我们定义如下, 具体优势函数我们将在下一章介绍.
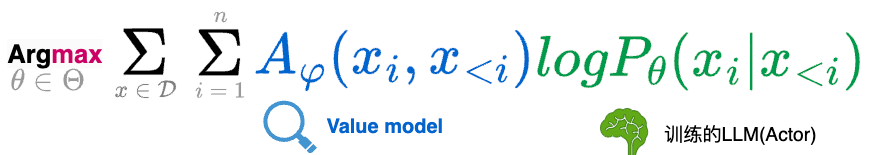
7. PPO
为了解决A2C样本效率低下的问题, 出现了近端策略优化(proximal policy optimization[10],PPO)算法. 顾名思义, 之所以称为近端策略, 是因为我们将重新使用先前的策略生成的样本(即模型在最近几个迭代生成的样本), 而非仅仅使用当前策略在线采样得到的结果.
此时, 我们将利用采样策略产生的轨迹和优势进行多步迭代, 而不是重新采样和计算新的轨迹和优势. 为了有效地将这些轨迹和优势与当前策略结合使用,PPO 目标函数采用了重要性采样.
7.1 重要性采样
在很多科学和工程领域, 我们需要计算一个函数 在某个概率分布 下的期望值.
例如, 在强化学习中, 我们想计算一个策略的期望总回报;这个积分通常很难甚至不可能直接计算. 一个常用的解决方法是蒙特卡洛积分: 从分布 中抽取大量样本 , 然后用这些样本的均值来近似期望值:
在PPO中, 我们希望复用旧策略 采集的数据, 来评估和更新当前的新策略 . 但是旧策略和新策略的概率分布是不同的.通常我们把旧策略 成为提议分布(Proposal Distribution), 当前策略成为目标分布. 对于新策略的估计:
我们可以做如下变化
观察这个新的积分形式, 它恰好是函数 在分布 下的期望值.
这个起关键修正作用的比率被称为重要性权重
直观理解:
- 如果一个样本 在目标分布 中出现的概率高于在提议分布 中的概率 (), 那么它的权重 就大于1. 这意味着这个样本被“欠采样”了, 我们需要给它更高的权重来补偿.
- 反之, 如果 , 权重 就小于1, 说明这个样本被“过采样”了, 我们需要降低它的权重.
我们想要计算的目标函数是优势函数 . 期望是: .套用重要性采样公式:
这里的 就是PPO中的概率比率 .
这就是为什么PPO的目标函数中会出现 这一项. 它正是利用重要性采样, 将基于旧策略数据的优势估计, 修正为对新策略下优势的无偏估计.
7.2 Clip
重要性采样比率 告诉我们, 对于同一个行为(生成 token ), 新策略的可能性是旧策略的多少倍. 理想情况下, 我们的优化目标是最大化 , 其中 是优势函数, 我们将在下一节展开.
但这里潜藏着巨大的危险: 不受约束的重要性采样会导致训练极其不稳定.
想象一下这个场景:
- 初始状态: 旧策略 采样得到一个轨迹, 其中某个动作 获得了很大的正优势 (比如, 回答问题时提到了一个关键点).
- 第一次更新: 模型学习到这个信号, 于是新策略 产生动作 的概率增加了. 比如, 变成了1.5. 目标函数 依然是一个很强的正向信号.
- 第二次更新: 模型继续沿着这个方向更新, 产生动作 的概率进一步大幅增加, 此时 可能飙升到5.0.
- 灾难发生: 由于优势值 是基于旧数据计算的, 始终不变, 目标函数变成了 . 这会产生一个巨大且不稳定的梯度, 导致模型参数发生剧烈抖动. 模型可能会"一步走错, 全盘皆输", 之前的学习成果可能被一次错误的巨大更新完全破坏.
为了防止上述灾难, PPO引入了其标志性的clip(裁剪)机制. 它不对概率比 本身进行限制, 而是对最终的目标函数进行限制.
PPO的裁剪目标函数是:
这里的 是一个很小的超参数 (比如0.2). 这个公式看起来复杂, 但它的作用非常直观, 就像一个"双向安全带":
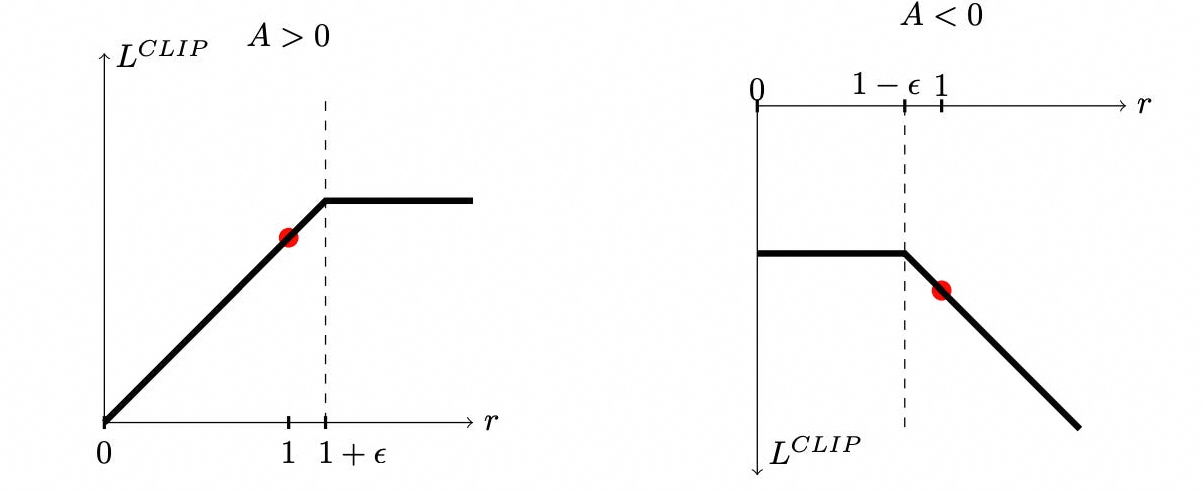
a) 当优势 为正 (这是一个好动作):
- 目标变成了 .
- 解读: 我们希望鼓励这个好动作, 但不希望"用力过猛". 一旦概率比 超过了 (意味着新策略相比旧策略已经"足够"倾向于这个动作了), min函数就会选择后面被裁剪过的项 .
- 效果: 给奖励设置了一个上限. 这就防止了模型对某个好动作产生病态的执念, 避免了"成语滥用"的情况.
b) 当优势 为负 (这是一个坏动作):
- 目标变成了 . 由于 是负数, 这等价于 .
- 解读: 我们希望惩罚这个坏动作. 一旦概率比 低于了 (意味着新策略已经开始"远离"这个坏动作), max函数就会选择后面被裁剪过的项 .
- 效果: 给惩罚设置了一个下限. 这可以防止模型因为一次错误而被过度惩罚, 导致其在未来完全不敢尝试类似的探索, 从而丧失多样性.
7.3 优势函数
如我们之前讨论的, PPO的目标是解决A2C等算法的高方差和不稳定性问题. 引入优势函数是实现这一目标的第一步
首先, 我们来看REINFORCE算法, 梯度更新依赖于总回报 .
此时的问题是方差巨大. 即使是差的轨迹, 只要 , 也会被(错误地)强化. 此时为了缩减方差, 我们想到一个简单的算法, 那就是引入一个baseline, 将回报中心化, 只关心"超出预期的回报".
其中 是基线, 举个例子:
- 如果一个回答得到了8分, 但我们本来就预期它能得8分, 那这次没什么值得特别学习的.
- 如果一个回答得到了8分, 但我们预期它只能得5分, 那么这“超出预期的3分”就是真正值得学习的信号. 我们应该强化产生这个惊喜的动作.
- 如果一个回答只得到3分, 低于预期的5分, 那么这“低于预期的-2分”就是一个强烈的惩罚信号.
但是这个“预期”或者“基线”的 怎么来的? 最理想的基线是状态 的真实价值函数 . 但我们无法知道它的精确值. 因此需要我们再训练一个独立的神经网络, 即Value Model来估计它.这个 就是我们对优势函数 最朴素的估计. 在这里我们详细展开介绍一下优势函数, 优势 指的是, 在状态 下, 采取特定动作 相比于遵循当前策略 的平均表现, 能带来多大的额外奖励.用数学语言表达就是:
我们来拆解这个核心公式:
- (State-Value Function, 状态价值函数):
- 定义: 从状态 开始, 如果一直遵循策略 继续下去, 所能获得的期望总奖励.
- 直观理解: 在状态 时, 遵循当前“平均水平”或“常规操作”能得到的分数. 这是Critic要学习和估计的目标. .
- (Action-Value Function, 动作价值函数):
- 定义: 在状态 时, 先强制采取动作 , 然后再遵循策略 继续下去, 所能获得的期望总奖励.
- 直观理解: 在状态 时, 做了某个“特定操作” 之后, 能得到的总分数.
- (Advantage Function, 优势函数):
- 定义: .
- 直观理解: "做了特定动作 之后得到的分数" 减去 "按常规操作得到的分数".
- 如果 : 说明动作 是一个优于平均的好动作, 应该被强化.
- 如果 : 说明动作 是一个劣于平均的坏动作, 应该被抑制.
- 如果 : 说明动作 是一个平庸的动作, 无所谓强化或抑制.
进一步展开, 优势函数估计通常有三种方法:
最简单的估计: 单步时序差分
我们知道 可以通过贝尔曼方程展开: . 我们将这个展开式代入优势函数的定义:
这个 被称为时序差分误差 (Temporal Difference Error, TD Error). 是在状态 采取动作 后立即获得的奖励, 是Critic对下一个状态的价值估计, 是折扣因子.
因此我们可以定义优势函数如下:
这种方法好处是, 计算简单, 只需要一步的交互数据.但是它严重依赖于Critic对下一个状态的价值估计 . 如果能够准确衡量策略价值, 那么TD Error就是优势函数的无偏估计. 但是如果Critic的估计不准, 那么整个优势的估计就会充满噪声, 优势函数是有偏的.
另外一个问题是, 我们注意到Reward Model在LLM场景中奖励 不是每一步都有的, 而是只在序列生成结束时才有一个最终奖励 . 所以这种单步TD误差的定义不直接适用.
改进的估计: 使用蒙特卡洛回报
既然我们有完整的轨迹和最终的奖励, 我们可以用整个轨迹的实际回报来估计 值. 的一个简单估计就是从 时刻开始到轨迹结束的所有奖励之和, 我们称之为回报 (Return) .在LLM场景下, 只有最终奖励 , 并且通常不设折扣因子(), 所以对于轨迹中的任何一步 , 从该步开始的回报都是同一个最终奖励 . 因此我们定义优势函数
它是对真实优势的无偏估计. 因为 是实际发生的回报, 不依赖于任何后续的价值估计, 所以没有引入由Critic估计不准带来的偏差. 但是 方差极高. 最终奖励 是一个随机变量, 它包含了从 到结尾所有随机动作的累积效应. 这种随机性导致 的值波动很大, 从而使得优势估计的方差也很大.
最佳实践: 广义优势估计 GAE
GAE (Generalized Advantage Estimation)借鉴了 算法的思路, 类似于 算法利用 因子在偏差和方差之间取得平衡. GAE也使用 达到类似的目的. 我们首先来定义GAE, 对于每条轨迹包含:
- 状态序列:
- 奖励序列: (在LLM中, 通常只有在序列结束时由奖励模型输出 )
- Critic (价值模型) 对每个状态的价值估计:
我们来看 K 步优势的计算:
- 对于 1 步优势 (TD Error):
- 对于 2 步优势: , 可以写成:
- k步优势:
因此我们定义GAE:
其中 是在 时刻的TD误差. 我们注意到两个特殊情况
- 当 : 这退化为了单步TD误差. 即估计是有偏的
- 当 : 这退化为了蒙特卡洛估计. 即估计是无偏的, 但是方差极大
对于 可以通过一个动态规划算法实现.初始化时计算最后一个时间步的优势: (因为 之后没有未来的 了), 然后回溯计算从 向前回溯到 :
最后可以输出一个优势估计序列 , 与轨迹中的每个 一一对应.
7.4 PPO训练过程
PPO的核心设计思想是提高样本利用率, 即用同一批生成的数据进行多次训练. 这个设计体现在其嵌套循环的架构上:
- 外部生成循环 (Outer generation loop): 这个循环的主要任务是生成经验数据. 它负责调用当前策略模型, 生成一批问答对, 并用奖励模型和价值模型对这批数据进行评估, 准备好所有用于训练的素材. 这个循环的频率较低, 每当内部循环把当前这批数据 "榨干" 后, 才执行一次.
- 内部优化循环 (Inner optimization loop): 这个循环的主要任务是训练和优化策略模型. 它会拿着外部循环准备好的一批"熟料", 重复进行K次梯度更新, 不断微调策略模型的参数. 这个循环的频率很高, 是真正的"训练"发生的地方.
如下图所示:
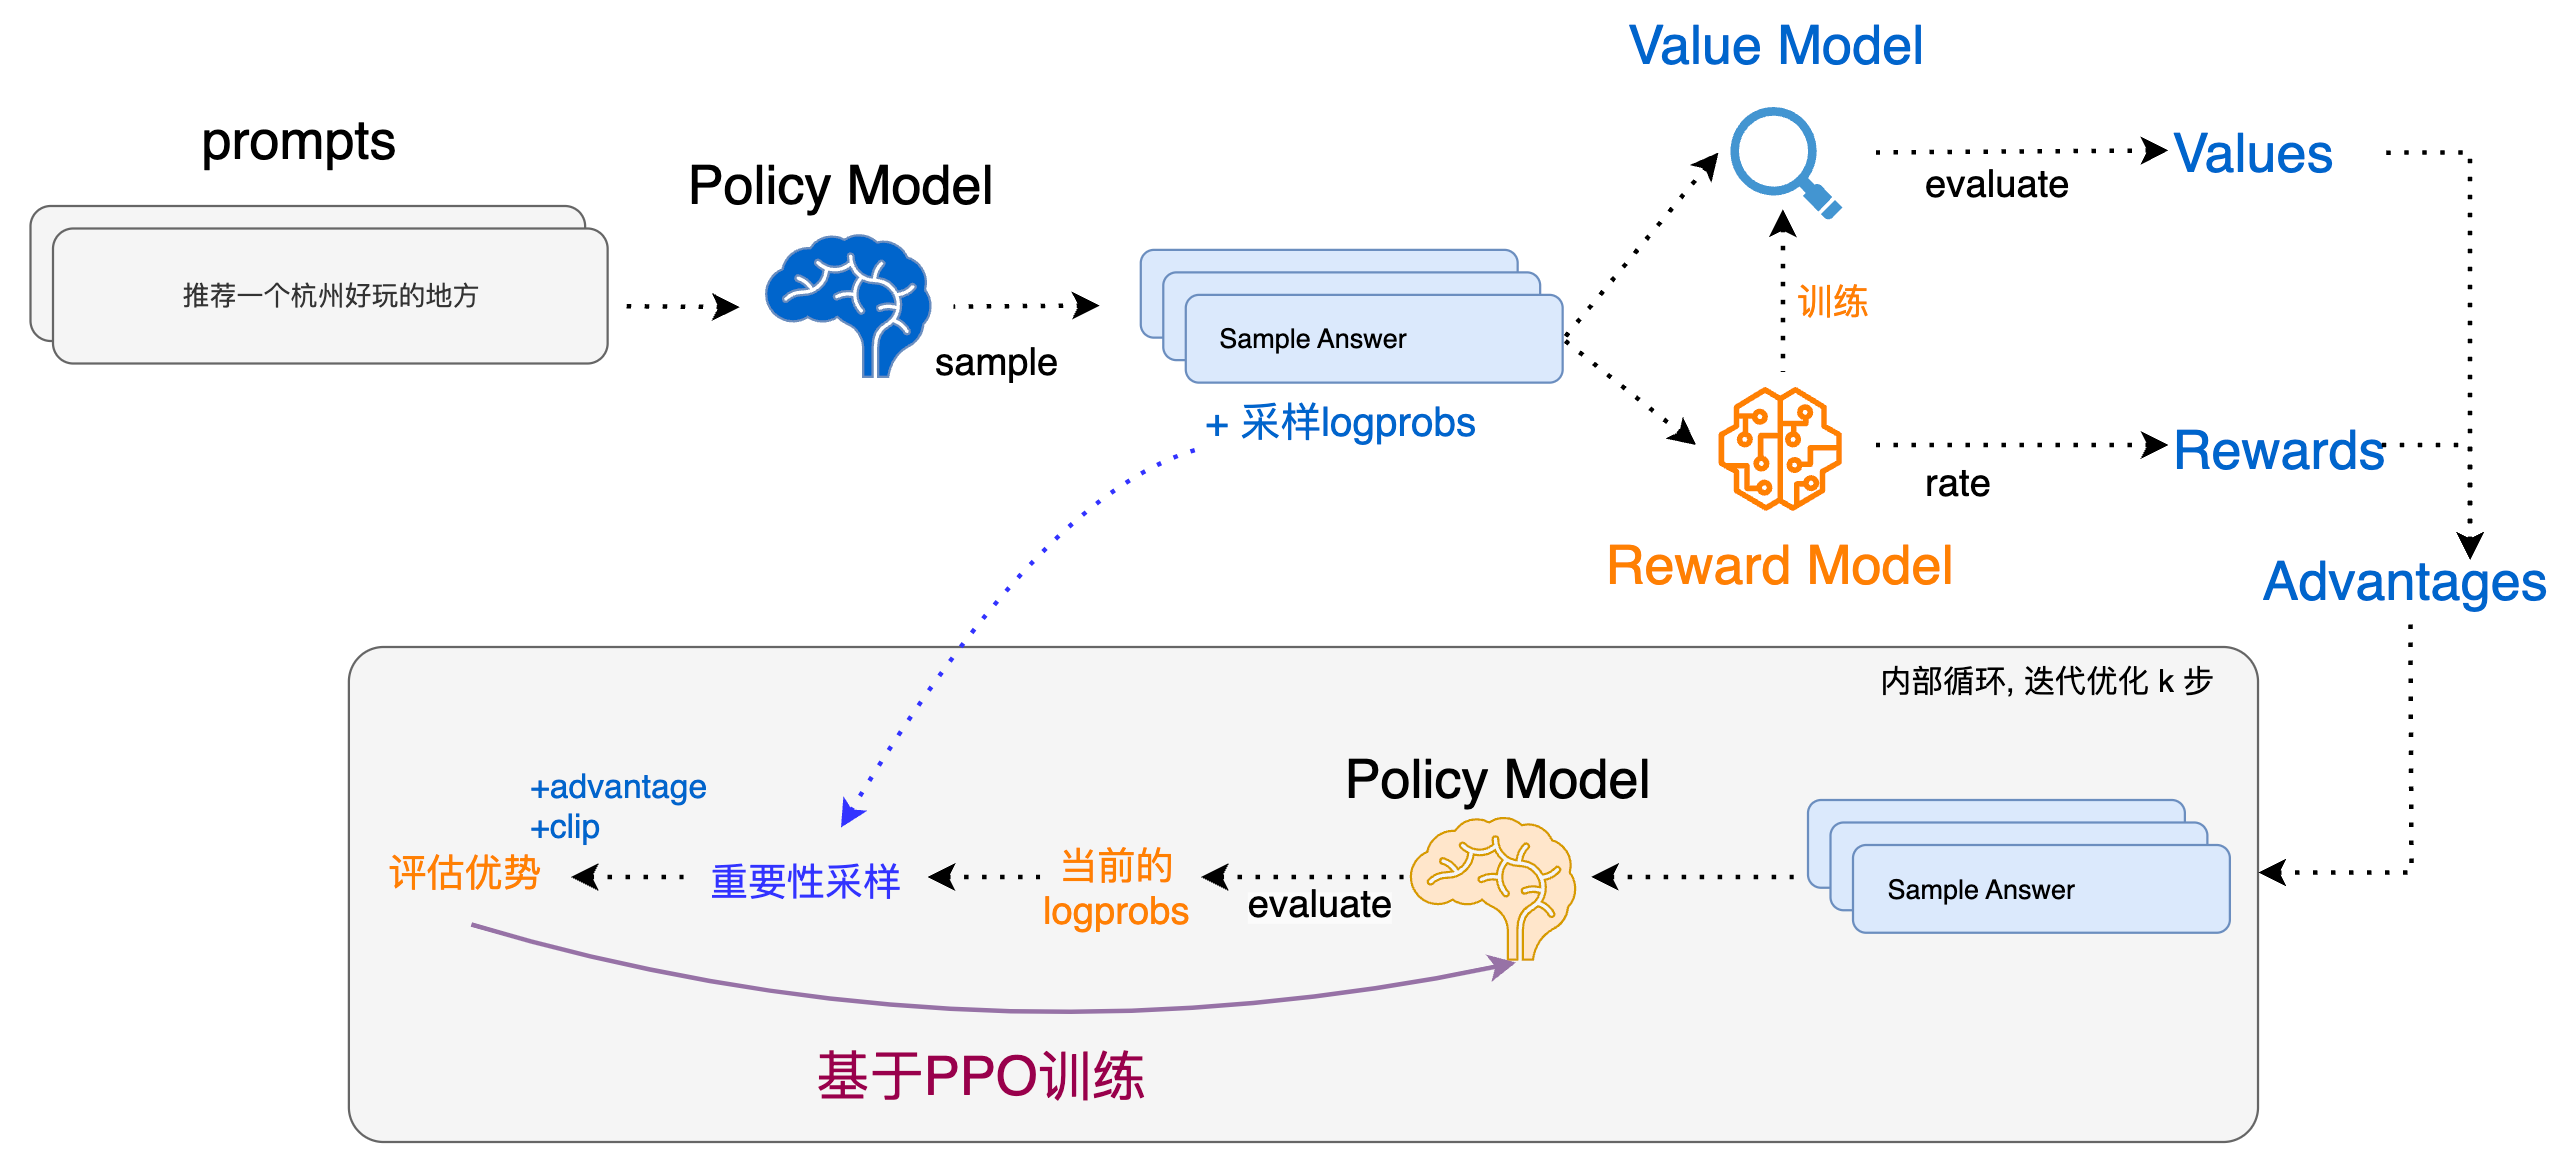
在外部生成循环中, 首先从数据集中取出一批Prompts, 例如 "推荐一个杭州好玩的地方".然后将这些Prompt喂给当前的策略模型 (Policy model). 策略模型会针对每个提示生成一个或多个答案. 这个过程是"采样", 意味着结果带有一定的随机性. 在生成这些答案的同时, 记录策略模型对每个token给出的概率的对数(logprobs). 这个值至关重要, 因为它是我们后面计算重要性采样的基准, 也就是. 此时的策略模型就是"旧"策略.
然后我们通过Value模型对生成过程中的每一个中间状态进行评估, 预测从该状态开始直到结束所能获得的累积奖励的期望值. 输出一系列. 同时Reward模型对整个回答的质量进行评分. 生成奖励 . 注意奖励只针对单个答案. 但是在实际操作中, 奖励会结合KL惩罚等因素进行调整, 并且可以被分配到每一步, 这部分内容我们将在下一节阐述.
最后通过GAE计算优势, 并输出每一步的优势
然后进入内部优化循环. 我们有来自外部循环的优势(advantages)以及来自原始策略模型的logprobs, 即来自. 然后我们对当前的正需要被训练的模型重新评估外部循环生成的同一批答案. 得到这批答案在当前策略下的logprobs. 即. 然后我们计算重要性采样:
接下来根据重要性采样比率 和 优势值 计算未裁剪的目标 , 以及裁剪后的重要性比率: , 最后输出两者最小值用于更新策略模型梯度. 即如下公式:
然后内部循环按照这个流程循环K次, 在内部优化循环(K次)全部完成后, 通常会使用这批经验数据来更新价值模型. 价值模型的训练目标通常是最小化其预测值与实际观察到的回报之间的均方误差(MSE).
当价值模型也更新完毕后, 整个PPO迭代完成了一次. 然后使用刚刚经过K次优化的新版策略模型去生成新的一批数据.
7.5 PPO+KL penalty
在前面的讨论中, PPO的优化目标是最大化奖励模型(Reward Model, RM)给出的分数. 这看起来很直接: RM代表了人类的偏好, 我们让策略模型(Policy Model)去迎合RM, 不就行了吗?
问题在于, 奖励模型并不完美, 它只是人类偏好的一个近似模型. 它在训练时见过的样本是有限的. 当策略模型在PPO的训练中不断进化时, 它可能会找到一些奖励模型训练数据中不存在的、奇怪的"漏洞"或"捷径"来获得高分. 这就是所谓的"Reward Hacking"或"过度优化 (Over-optimization)".
想象一个场景, 你想训练一个机器人写诗. 你训练了一个奖励模型, 告诉它包含"华丽辞藻"(如"璀璨", "浩瀚", "磅礴")的诗歌分数更高.
- 初期: 机器人开始学习在诗歌中恰当地使用这些词, 写出的诗质量提升了.
- 中期: 机器人发现, 只要出现这些词, 分数就高. 于是它开始更频繁地使用它们.
- 后期(Reward Hacking): 机器人彻底"悟了". 它发现获得最高分的最佳策略不是写一首有意义的诗, 而是生成一段毫无逻辑但堆满了"璀璨璀璨浩瀚磅礴璀璨..."的文本. 因为奖励模型在其有限的"认知"里, 只学会了"这些词=高分", 却没有完全学会"有意义的诗歌结构"这个更复杂的概念.
如果不加约束, 策略模型会为了最大化那个不完美的奖励分数而"走火入魔", 生成的文本可能听起来很"好"(充满了奖励模型喜欢的模式), 但实际上毫无意义、内容空洞、甚至完全偏离了自然语言的范畴.
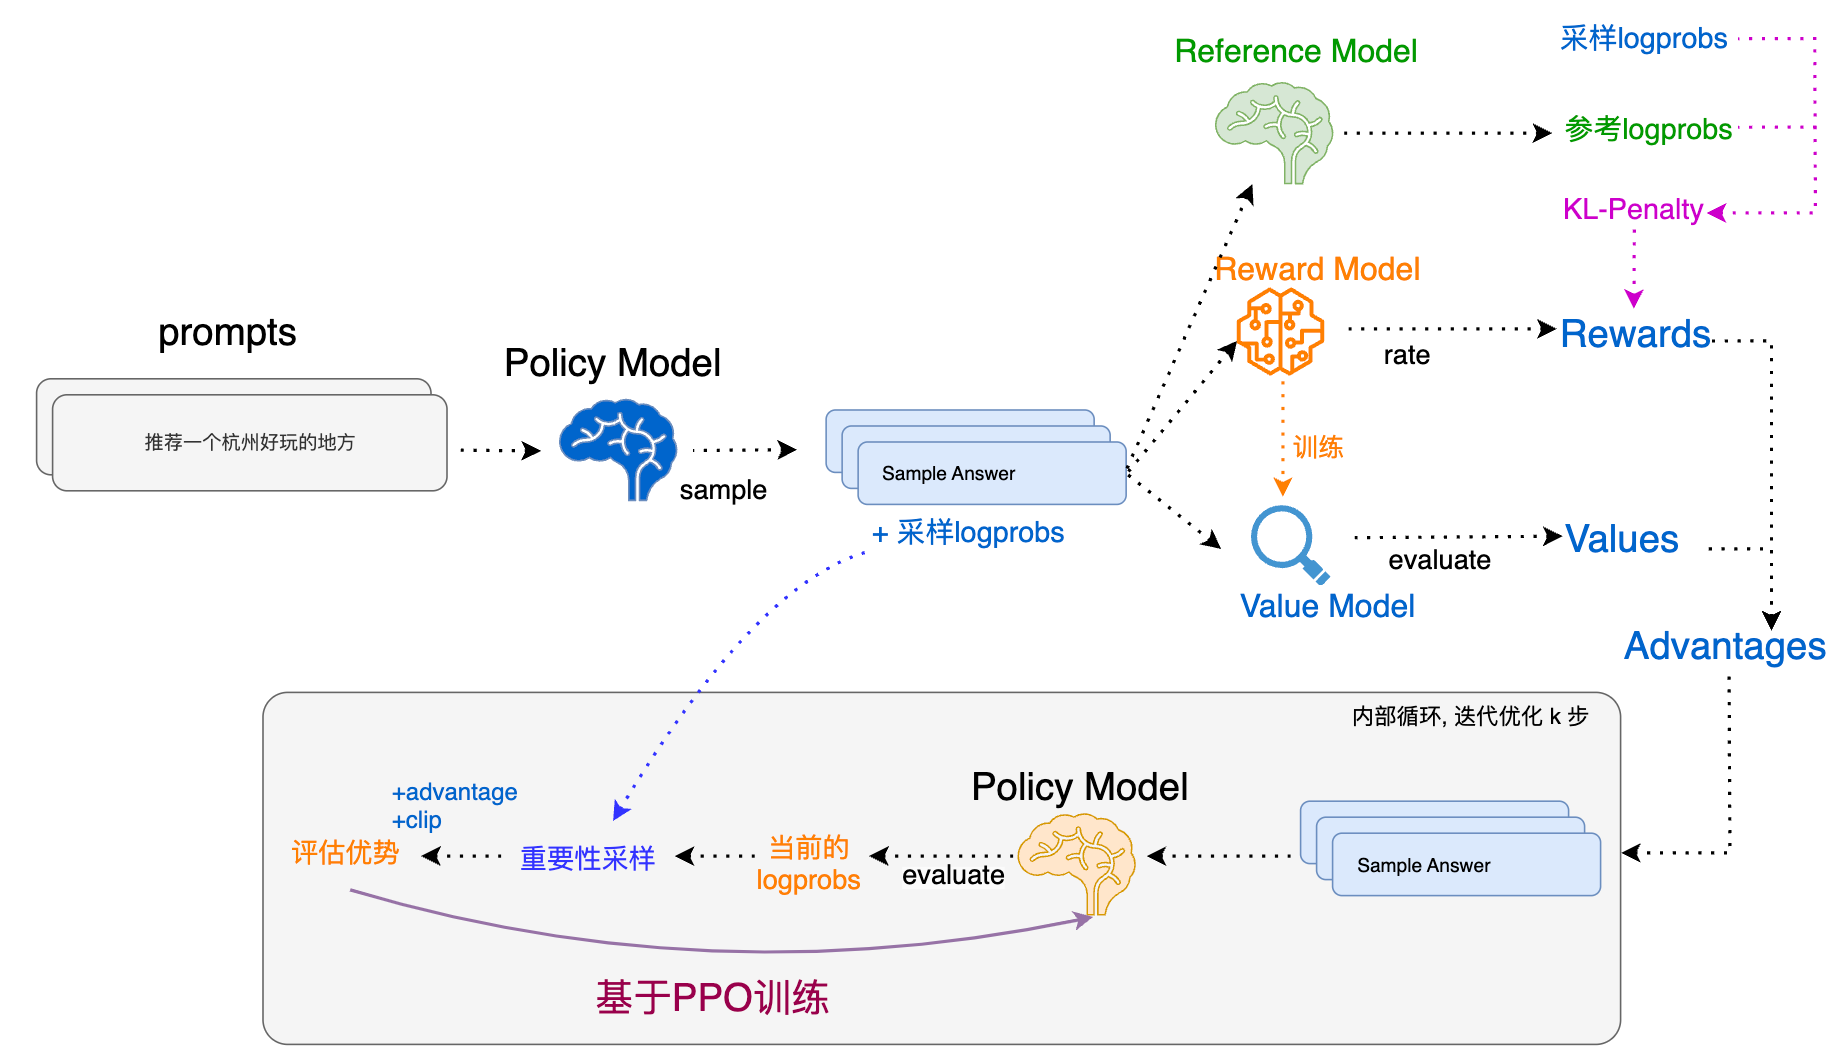
为了解决上述问题, 我们引入了 参考模型 (Reference Model) 和 KL惩罚 (KL penalty).
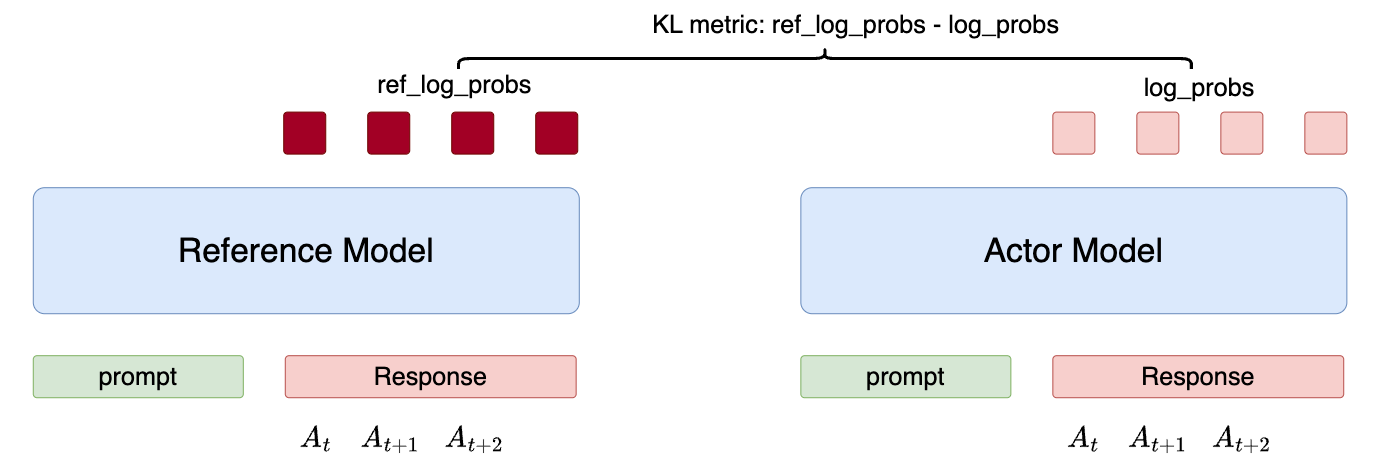
参考模型通常就是PPO训练开始前的那个策略模型. 比如, 经过SFT(监督微调)之后的初始模型. 它代表了一个"理智"的、"正常"的语言模型应该有的样子. 它的输出分布是我们不希望新模型偏离太远的一个锚点或基准. 它就像一个"紧箍咒", 时刻提醒着孙悟空(策略模型)不要乱来.
KL散度 (Kullback–Leibler divergence) 是一个衡量两个概率分布之间差异的指标. 在这里, 我们用它来衡量当前策略模型()的输出概率分布和参考模型()的输出概率分布之间的差异.
我们将这个KL散度值作为一个惩罚项, 从奖励模型给出的原始奖励中减去.
其中, 是一个超参数, 用来控制惩罚的强度. 另外我们还可以将策略模型和参考模型的KL散度用于Reward模型, 对逐token的 定义为:
对于Reward Model 我们可以定义即对未完成的答案中间状态的逐token reward值为零. 也就是说在生成token的过程中, 我们期望模型尽量的不要跑偏, 我们此时更加关心在参考模型约束下生成token. 而在生成结束后, 我们不光关心生成的答案是否遵从参考模型约束, 也关心此时的Reward .
就此整个完整的PPO训练流程就已经补齐了:
7.6 ChatGPT的训练流程
最后我们把整个流程串起来, 解释一下ChatGPT的后训练 (Post-training) 三阶段流程
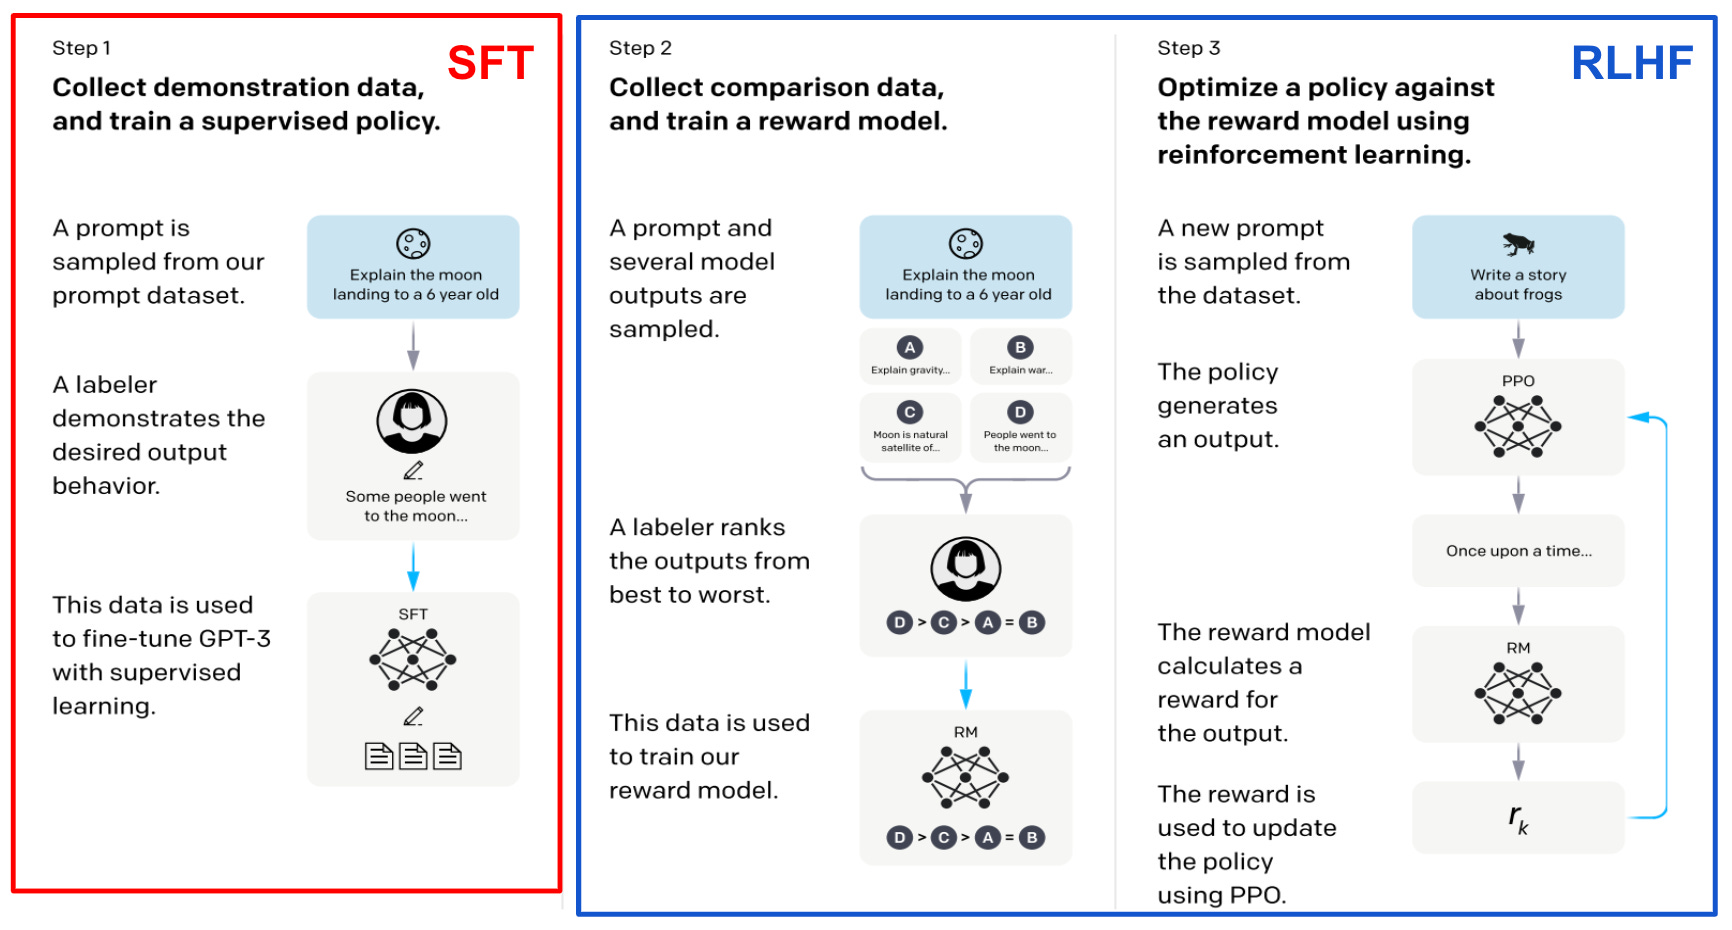
阶段一: 监督微调
主要的目标是教会模型"对话"的基本形式, 让它知道什么是"指令", 什么是"回答", 并初步具备遵循指令的能力. 整个流程如下:
- 数据收集: 首先我们收集大量各种类型的指令. 这些指令一部分来自真实的OpenAI API用户提交的请求, 另一部分由雇佣的专业标注员精心编写. 标注员会编写各种各样的指令, 包括提问、要求总结、要求创作、代码生成、追问等, 以确保数据的多样性. 然后针对每一个收集到的提示, 标注员会像一个理想的AI助手一样, 写出一个高质量、有帮助、无害的示范答案.
- 构建数据集: 将收集到的"Prompt-示范答案"对构造成一个高质量的监督学习数据集.
- 模型训练 (Fine-Tuning): 选择一个强大的预训练语言模型作为基础. 使用上一步构建的数据集对这个预训练模型进行监督微调. 训练的目标是最大化模型生成示范答案的概率, 也就是标准的语言模型损失函数 (交叉熵损失).本质上, 这是在模仿学习, 让模型模仿人类标注员的行为.
经过SFT阶段, 我们得到了一个SFT模型.这个模型已经初步具备了对话能力, 对于数据集中见过的或类似的指令, 它能给出不错的回答. 但是它还有很大的局限性: SFT模型的输出质量和多样性受限于数据集的规模和质量. 它的泛化能力有限, 并且由于是模仿学习, 它很难生成比人类标注员更高质量的答案.
阶段二: 奖励模型训练
训练一个"裁判"模型, 让它学会人类的偏好, 能够对模型生成的不同回答进行质量打分. 具体过程如下:
- 数据收集 (Data Collection):
拿一个提示(prompt) 输入到SFT模型 (阶段一的产物). 让SFT模型针对这个提示生成多个不同的回答.接着人类标注员对这些回答进行排序. 标注员不需要写新答案, 只需要根据质量(帮助性、真实性、无害性等)对模型生成的答案进行排序, 例如:
回答D > 回答B > 回答A > 回答C. - 构建数据集:
然后将排序结果构造成一个成对比较 (pairwise comparison) 的数据集. 对于上面那个例子, 我们可以构造出多个比较对:
(提示, 回答D, 回答B),(提示, 回答D, 回答A),(提示, 回答B, 回答C)等, 其中前者总是优于后者. - 模型训练 (Training):
选择一个预训练模型作为奖励模型的基础 (通常是SFT模型去掉最后的输出层, 换成一个输出标量值的线性层). 对于每一个比较对
(prompt, chosen_answer, rejected_answer), 奖励模型会分别给两个回答打分, 得到 和 . 训练的目标是最大化"好的回答得分"与"坏的回答得分"之间的差距. 这通常通过一个特定的损失函数 (如Bradley-Terry模型) 实现: 其中 是sigmoid函数. 这个损失函数会鼓励模型给"被选择的答案"打高分, 给"被拒绝的答案"打低分.
就此, 我们得到了一个奖励模型 (RM). 这个模型输入一个"提示-回答"对, 就能输出一个标量分数, 代表了这个回答的质量. 这个分数反映了人类的偏好. 它成为了下一阶段强化学习的"奖励信号".
阶段三: PPO
它利用阶段二获得的奖励模型作为指导, 通过"探索与试错"来进一步优化SFT模型, 让其生成更高质量、更符合人类偏好的回答. 这是一个迭代的强化学习循环.
- 初始化:
- 策略模型 (Policy): 将阶段一的SFT模型作为初始的策略模型.
- 参考模型 (Reference): 复制一份SFT模型, 作为固定的参考模型, 用于计算KL惩罚.
- 奖励模型 (Reward): 使用阶段二训练好的RM, 固定其参数, 作为环境的奖励函数.
- 价值模型 (Value): 通常也由SFT模型初始化, 也可以从Reward模型初始化而来, 用于PPO算法中的优势计算.
- PPO 循环:
- a. 采样 (Rollout): 从提示数据集中取一个提示, 输入给当前的策略模型, 生成一个回答. 这个过程
(提示, 回答)构成了一个轨迹 (trajectory). - b. 奖励计算:
- 将生成的
(提示, 回答)输入给奖励模型 (RM), 得到一个原始的奖励分数. - 计算当前策略模型与参考模型在此轨迹上的KL散度, 作为KL惩罚.
- 最终奖励 = 原始奖励 - KL惩罚.
- 将生成的
- c. 优势估计 (Advantage Estimation): 利用价值模型和计算出的最终奖励, 使用GAE等方法计算每一步动作的优势值.
- d. 策略更新 (Policy Update): 使用PPO算法 (包括其核心的
clip机制), 根据计算出的优势值来更新策略模型的参数. 同时, 也更新价值模型的参数. - e. 重复: 重复a-d步, 不断迭代优化策略模型.
- a. 采样 (Rollout): 从提示数据集中取一个提示, 输入给当前的策略模型, 生成一个回答. 这个过程
我们得到了最终的、经过RLHF优化的指令模型 (例如ChatGPT).这个模型不仅能理解指令, 而且其生成的内容在整体质量、帮助性、安全性和遵循复杂指令的能力上, 都显著优于SFT模型. 它学会了如何在巨大的可能性空间中, 探索并生成最能满足人类偏好的答案.
8. PPO的一些缺陷及未来演进
PPO采用的 KL 惩罚依赖于一个固定的参考模型()来防止策略模型() "跑偏".
参考模型通常是SFT结束后的模型, 它代表了训练开始时的"理智". 但随着PPO训练的进行, 策略模型的能力在不断提升, 它会探索到参考模型从未见过的、更高级、更复杂的语言空间. 随着训练的深入, 策略模型和参考模型之间的差距越来越大 (KL散度自然增大). 这会导致两种糟糕的情况:
- 过度保守: 为了避免巨大的KL惩罚, 策略模型不敢探索新的、有益的行为, 学习过程陷入停滞.
- 惩罚失效: 如果学习率或奖励信号足够强, 策略模型可能会"挣脱"KL惩罚的束缚, 进入一个与参考模型截然不同的区域. 在这个区域里, KL散度变得非常大且不稳定, 失去了作为平滑正则化项的意义, 训练可能因此崩溃.
KL惩罚是一种"软约束", 它惩罚偏离, 而不指导方向. 另一方面 KL 惩罚只在策略模型做出"出格"行为后才施加惩罚. 它并没有主动提供信息, 告诉模型在保持"正常"的同时, 应该朝哪个有益的方向去探索.另一方面无论模型是因为学习到了有益的新知识而偏离, 还是因为开始"胡言乱语"而偏离, KL惩罚都一视同仁地施加惩罚. 它无法区分"好的偏离"和"坏的偏离".
然后策略模型可能会找到一个"安全且收益不错"的表达模式或回答风格. 比如, 总是使用非常正式、客气但信息量不高的语言. 这种风格既能从奖励模型那里拿到一个不错的分数, 又因为语言模式相对常见而不会触发过高的KL惩罚. 一旦找到这样的"舒适区", 模型就没有动力去探索其他可能更好但风险(KL惩罚)也更高的回答风格, 导致生成的内容千篇一律, 缺乏创造性和趣味性. 因此尽管有KL惩罚, PPO训练的LLM仍然可能表现出多样性不足的问题.
在ChatGPT发布之后, 我们也逐渐遇到了很多问题:
- 问题1: 复杂数学/推理任务仍然很差
- 问题2: 代码生成错误率高,无法自我修正
- 问题3: 多步骤任务经常中途失败
- 问题4: 幻觉的影响, 即模型"自信地犯错"并胡言乱语
而为了解决这些问题, 在2023年~2024年模型的强化学习算法也进入了一个快速迭代的高潮, 特别是在OpenAI o1发布以及DeepSeek-R1实现了开源模型复现后, 整个模型的后训练流程进入了飞速发展的阶段. 下一篇我们将详细展开分析, 然后再后面一篇再过渡到Agentic LLM的后训练.