TL;DR
在RL102中, 我们介绍了第二代模型, 通过过程监督和推理阶段的计算, 利用PRM作为启发函数, 在推理过程中引入了一些搜索策略, 并实现了动态剪枝和选择最优路径的能力, 这样增强了对数学和逻辑相关的推理能力, 让模型更会“想”, 由此LLM的发展正从一个依赖直觉、快速回答的"System 1"系统, 向一个能够进行深思熟虑、分步推理的"System 2"系统演进.
同时在类似于Math-Shepherd这样的算法已经可以实现一些自动的标注来构建 PRM. 不过还是有很多训练数据本身需要人类标注. 那么对于第三代模型, 是否可以无须人类标注, 模型自己生成训练信号? 进一步超越人类水平,“涌现”推理能力. 这一代主要突破来自于RLVR(Reinforcement Learning from Verifiable Reward,可验证奖励的强化学习)以及RLAIF(Reinforcement Learning from AI Feedback). 这一范式彻底摆脱了对人类主观偏好(RLHF)或昂贵人类标注的依赖, 转而利用客观、可编程的验证器来提供无偏见的奖励信号. 这标志着大模型训练从“模仿人类”转向“自我进化”, 类似于 AlphaGo 通过自我博弈超越人类棋手. 例如这一代模型在IOI和IMO都有获得金牌的实力.
本文目录如下:
1. Overview
2. 数学领域
2.1 证明验证器
2.1.1 训练一个能识别问题并为证明打分的验证器
2.1.2 引入元验证来审查证明分析
2.2 证明生成器
2.2.1 训练用于定理证明的生成器
2.2.2 通过自我验证增强推理
2.3 证明验证与证明生成之间的协同作用
2.4 实验
2.4.1 单次生成
2.4.2 基于自我验证的序列化精炼
2.4.3 高算力搜索
3. 编程领域
3.1 并行生成
3.2 行为聚类
3.3 锦标赛排序
3.4 提交策略
3.5 一些补充
4. 回顾RLVR
5. GRM
5.1 不同奖励模型(RM)方法的比较
5.2 利用原则提升奖励质量
5.3 自我原则评判调优 (Self-Principled Critique Tuning, SPCT)
5.4 基于SPCT的推理时扩展
5.5 回顾GRM整个流程
6. 小结
1. Overview
在第二代模型通过 PRM 提供的相对密集的奖励信号配合推理过程中引入的一些搜索策略, 显著的增强了数学和逻辑相关的推理能力, 这也确立了通过扩大训练时期的RL后训练任务和推理时期的计算算力来提升模型整体推理能力的有效性. 但是我们可以看到这类模型在解决数学任务或者一些较难的编程竞赛任务时还有一些局限性.
数学竞赛
在基于PRM的第二代模型中, 通常解决的是例如 GSM8K 这样的定量计算的题目. 例如Math-Shpherd这样的工作, 详细可以查看RL102的第三章.
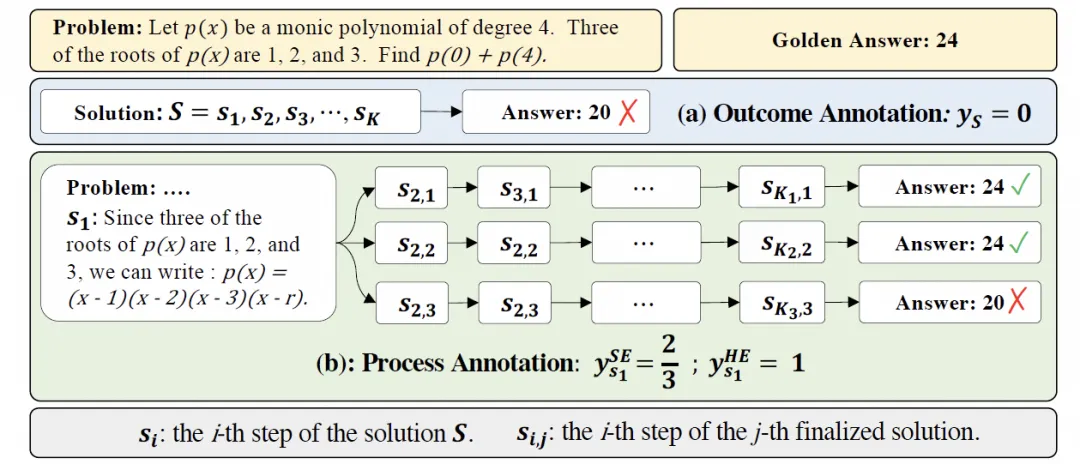
但是这样的方法对于很多数学相关的证明题是无效的. 特别是在IMO这类的题目上. 我们看到这类问题的主要原因如下:
第二代模型的强化学习极度依赖于"事后诸葛亮"式的裁判. 模型算完一道题, 系统看一眼正确答案, 如果数字一致就发奖金. 第二代虽然也尝试了过程奖励模型(PRM), 但那只不过是在每一步推导后打个分, 就像在盲人摸象的过程中偶尔喊一句"方向对了"或者"偏了".
因此第三代模型被迫走向了一条极其艰难的道路: 放弃对标准答案的执念, 转而向人类顶尖数学家学习"自我批判". 对于第三代模型需要引入了不仅能找错, 还能指出"错在哪"的语言验证器, 甚至安排了"元验证器"来监督验证器本身是否在胡说八道.
编程竞赛
另一方面针对Coding任务, 第二代模型通常会调用一个外部沙箱环境编译并运行代码, 同时执行单元测试, 然后根据编译和运行错误日志, 在思维链中回溯并设计新的探索路线. 但是在解决IOI级别的问题还是有很大难度的.
在《Competitive Programming with Large Reasoning Models》[1]详细介绍了OpenAI在参加2024年IOI时构建了一个o1-ioi的模型, 以及后续o3的改进. o1-ioi 相对于o1进行了更多的Coding相关的RL训练,但是依旧需要人类工程师介入进行子问题拆分和大量生成解答代码进行测试并实现聚类和Reward Model进行评分重排. o1-ioi 通过一套复杂的"生成-聚类-重排"管道, 硬生生把分数堆了上去. 但这种路线仍然需要人类的介入.
而o3上, 则是完全的利用了RL训练,而让模型自主涌现出更具洞察力和深思熟虑的思维链. 该模型不仅编写并执行代码以验证其解决方案是否符合公共测试用例, 它还会根据这些验证结果来完善自己的方法. 特别来说, o3 发现的一种高级测试时策略: 对于验证起来并不容易的问题, 它经常会编写简单的暴力破解解决方案——用效率换取正确性——然后将(暴力解法的)输出结果与其自身更优化的算法实现进行交叉核对. 这种自我强加的验证机制使得 o3 能够捕捉到潜在的错误并提高其解决方案的可靠性. 最终o3的能力可以在IOI达到金牌线的标准.
总体来看第三代模型的最大区别是从依赖外部反馈信号的浅层对齐,进化为具备自我批判与验证能力的深度推理, 模型角色从“听从指令的执行者”转变为“能够自我反思与进化的探索者”. 详细对比第二代模型, PRM本质上是一个代理模型, 它试图拟合人类对推理步骤的判断. 其奖励信号可以表示为:
其中 为第 步的推理状态. 这种机制存在两个无法根除的技术缺陷:
- 泛化鸿沟: 神经网络形式的PRM本质上是在做插值. 当模型遇到超越人类认知范围的复杂推理路径时, PRM无法给出准确的判断, 甚至会因为分布外数据而产生错误的奖励信号, 诱导模型走入歧途.
- 噪声传导: PRM的训练数据源于人类标注, 这本身就带有主观性和不一致性. 模型实际上是在学习“如何骗过人类评分器”, 而非“如何得到正确结果”, 这就是所谓的 Reward Hacking 的根源.
第三代RLVR彻底摒弃了神经网络作为奖励源, 转而引入确定性的验证器 . 其奖励信号是二元的、客观的:
这里的 可以是代码编译器、形式化证明器. 这种机制带来了两个质变:
- 零噪声: 只要验证通过, 逻辑就是绝对正确的. 这种无偏信号使得模型可以进行极高强度的策略更新, 而不必担心策略偏移.
- 超越人类: 验证器不需要“理解”人类思维, 只需要判定逻辑真伪. 这使得模型可以探索出人类从未见过的推理路径(如AlphaGeometry的几何证明), 只要通过验证, 就是有效的新知识.
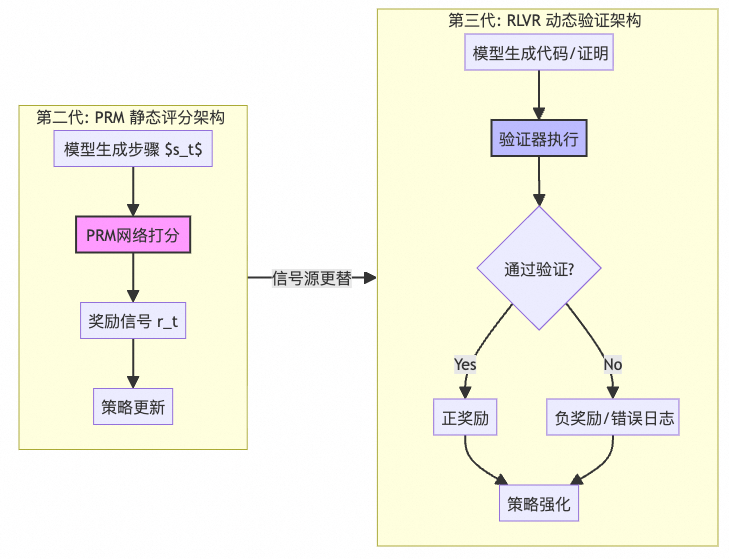
接下来我们将分两章来分别介绍第三代模型在数学领域和编程编程领域相关的工作
2. 数学领域
这一部分我们以开源的DeepSeek-Math-V2为例, 在论文《DeepSeekMath-V2: Towards Self-Verifiable Mathematical Reasoning》[2]中详细阐述了基于“生成器--验证器”的模式. 作者的方法受到几个关键观察的启发:
- 即使没有参考答案, 人类也能够识别证明中的问题——这在解决没有已知解的开放性问题时是至关重要的能力.
- 当经过扩展的验证努力后仍然无法发现任何问题时, 一个证明更可能是有效的.
- 识别有效问题所需的努力可以作为证明质量的代理指标, 这可以被用来优化证明的生成.
因此可以训练LLM在没有参考答案的情况下识别证明中的问题. 这样一个验证器将能开启一个迭代改进的循环: (1) 使用验证反馈来优化证明生成, (2) 扩展验证计算以自动标注难以验证的新证明, 从而创造训练数据来改进验证器自身, 以及 (3) 使用这个增强的验证器来进一步优化证明生成. 此外, 一个可靠的证明验证器能够教导证明生成器像验证器一样评估证明. 这使得证明生成器能够迭代地改进其证明, 直到它再也无法识别或解决任何问题为止. 本质上, 作者让模型明确地意识到它的奖励函数是什么, 并使其能够通过深思熟虑的推理而不是盲目的试错来最大化这个奖励. 相对于前一代模型, 主要改动如下:
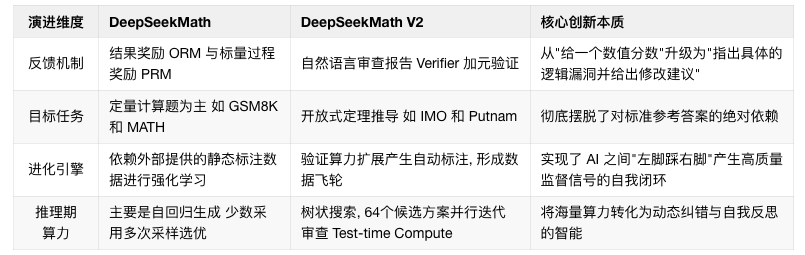
2.1 证明验证器
2.1.1 训练一个能识别问题并为证明打分的验证器
作者为证明评估制定了高层级的评分准则 , 目标是训练一个验证器, 使其能根据这些准则评估证明, 从而模仿数学专家的评估过程. 具体来说, 给定一个问题 和一个证明 , 验证器 被设计用于生成一份证明分析, 该分析首先总结发现的问题(如果有的话), 然后根据三个等级赋予一个分数: 1分代表完整且严谨, 所有逻辑步骤都清晰论证的证明; 0.5分代表整体逻辑合理但存在微小错误或细节疏漏的证明; 0分代表包含致命逻辑错误或关键缺环的根本性错误证明.
冷启动强化学习数据
作者通过以下过程构建了初始训练数据:
- 作者从 Art of Problem Solving (AoPS) 竞赛网站上爬取了问题, 优先选择了数学奥林匹克竞赛, 选拔赛, 以及2010年后明确要求证明的问题, 共计17,503个问题. 这个问集题记为 .
- 作者使用一个 DeepSeek-V3.2-Exp-Thinking 的变体来生成候选证明. 由于该模型并未针对定理证明进行优化, 倾向于产生简洁但易于出错的输出, 作者提示它在多轮中迭代地精炼其证明, 以提高完备性和严谨性.
- 作者从不同问题类型(如代数和数论)中随机抽样证明, 并让数学专家根据上述评估准则为每个证明打分.
这个过程产生了一个初始的强化学习数据集 , 其中每个元素包含一个问题 , 一个证明 , 以及一个整体的证明分数 .
强化学习目标
基于一个在数学和代码相关推理数据上进行过 SFT 的 DeepSeek-V3.2-Exp-SFT 版本, 作者使用强化学习来训练模型产出证明分析, 其中包含两个奖励组件:
- 格式奖励 : 一个指示函数, 通过检查最终回应是否包含关键短语 "Here is my evaluation of the solution:" 以及在 "Based on my evaluation, the final overall score should be:" 之后
\boxed{}中的分数, 来强制模型同时生成已识别问题的摘要和证明分数. - 分数奖励 : 基于预测分数 和标注分数 之间的接近程度给予奖励:
训练验证器的强化学习目标是:
其中 表示验证器的最终回应, 是从中提取的证明分数.
2.1.2 引入元验证来审查证明分析
前一节描述的方法通过RL训练证明验证, 以使预测的证明分数与专家标注对齐, 但并未对识别出的问题本身提供直接的监督. 这产生了一个关键的漏洞: 在训练评估有缺陷的证明(其中 )时, 验证器可以通过预测正确的分数, 同时捏造不存在的问题来获得全额奖励, 这会损害其可信度.
为了解决这个问题, 作者引入了元验证 (meta-verification): 一个二次评估过程, 用于评估验证器识别出的问题是否确实存在, 以及这些问题是否根据评估准则 在逻辑上支持其预测的证明分数. 完整的元验证准则 如下
作者使用RL训练了一个专门的元验证器 (meta-verifier) 来执行此评估. 通过将元验证器的反馈纳入验证器训练中, 可以提高验证器问题识别的忠实性 (faithfulness).
元验证器训练过程
- 首先获得了前一节中描述的初始验证器 .
- 数学专家根据 对验证器回应的质量进行评分, 创建了数据集 , 其中 是对证明 的分析, 而 是专家标注的质量分数.
- 然后训练了一个元验证器 来分析验证器的证明分析 . 元验证器会产出对该分析本身发现问题的摘要, 随后是一个衡量验证器分析的准确性和合理性的质量分数. RL目标遵循与验证器训练相同的结构, 包含格式和分数奖励.
使用训练好的元验证器 , 通过将元验证反馈整合到奖励函数中来增强验证器的训练:
其中 是来自元验证器的质量分数.
作者在验证数据集 和元验证数据集 上都训练了这个增强的验证器, 在 上使用了与训练元验证器时相同的奖励机制. 最终得到的模型可以同时执行证明验证和元验证任务.
在 的一个验证集上, 验证器的证明分析的平均质量分数(由元验证器评估)从0.85提升到了0.96, 同时在证明分数预测的准确性上保持不变.
2.2 证明生成器
2.2.1 训练用于定理证明的生成器
有了作为生成式奖励模型的验证器 , 使用以下RL目标来训练一个证明生成器 :
其中 是由验证器 产生的证明分数.
2.2.2 通过自我验证增强推理
当证明生成器无法一次性为难题(如IMO和CMO竞赛题)产出完全正确的证明时(这很常见), 迭代式的验证和精炼可以改善结果. 这涉及到用一个外部验证器来分析证明, 并提示生成器去解决已识别的问题.
然而, 作者观察到了一个关键的局限: 当被提示在一次性输出中同时生成并分析自己的证明时, 生成器倾向于声称其证明是正确的, 即使外部验证器可以轻易地发现其中的瑕疵. 换句话说, 尽管生成器能够根据外部反馈来精炼证明, 但它在评估自己的工作时, 却未能达到专用验证器那样的严谨程度.
这个观察启发了作者将真正的验证能力赋予证明生成器. 在训练期间, 作者提示生成器 产出一个证明 , 随后附上一段遵循与验证器相同格式和准则 的自我分析 . 作者将自我分析中预测的证明分数记为 .
为了确保忠实的自我评估, 作者使用验证器 来评估两个部分: 证明 获得分数 , 自我分析 获得一个元验证分数 . 奖励函数结合了这些评估:
其中 验证证明和自我分析都遵循指定格式, 奖励准确的自我评估. 作者设置 和 . 这个奖励结构创造了以下激励:
- 忠实地承认错误比虚假地声称正确更受奖励.
- 最高的奖励来自于产出正确的证明并准确地认识到其严谨性.
- 对于证明生成器来说, 获得高奖励的一个好策略是在最终确定回应之前, 识别并解决尽可能多的问题.
2.3. 证明验证与证明生成之间的协同作用
证明验证器和生成器创造了一个协同循环: 验证器改进生成器, 而随着生成器的改进, 它会产出挑战验证器当前能力的新证明. 这些验证器可能无法在单次尝试中发现问题的挑战性案例, 成为了增强验证器自身的宝贵训练数据.
为了重新训练和改进验证器, 需要为新生成的证明标注正确性数据. 手动标注虽然直接, 但随着问题变难, 错误变得更隐蔽, 会变得越来越耗时. 为了提升标注效率, 作者为每个证明生成多个验证器分析, 以便将潜在问题呈现给人类审查.
从这个AI辅助的标注过程中, 作者认识到两个事实, 使得将自动化程度再推进一步成为可能:
- 扩展验证器的采样数量会增加在有缺陷的证明中捕获到真实问题的概率.
- 审查验证器已识别出的问题, 这正是元验证, 它比从零开始识别问题更容易. 元验证对于LLM来说也更具样本效率去掌握.
基于这些观察, 作者开发了以下自动化标注流程:
- 对每个证明, 生成 个独立的验证分析.
- 对于报告了问题(分数为0或0.5)的分析, 生成 个元验证评估来验证已识别的问题. 如果大多数元评估确认其发现, 则该分析被视为有效.
- 对每个证明, 作者检查那些给出最低分数的分析. 如果至少有 个这样的分析被认为是有效的, 那么该证明就被标记为那个最低分数. 如果在所有验证尝试中都未发现合法问题, 证明就被标记为1. 否则, 证明被丢弃或转交人类专家进行标注.
在最后两次的训练迭代中, 这个完全自动化的流水线完全取代了人工标注. 质量检查证实, 自动化标签与专家判断高度一致.
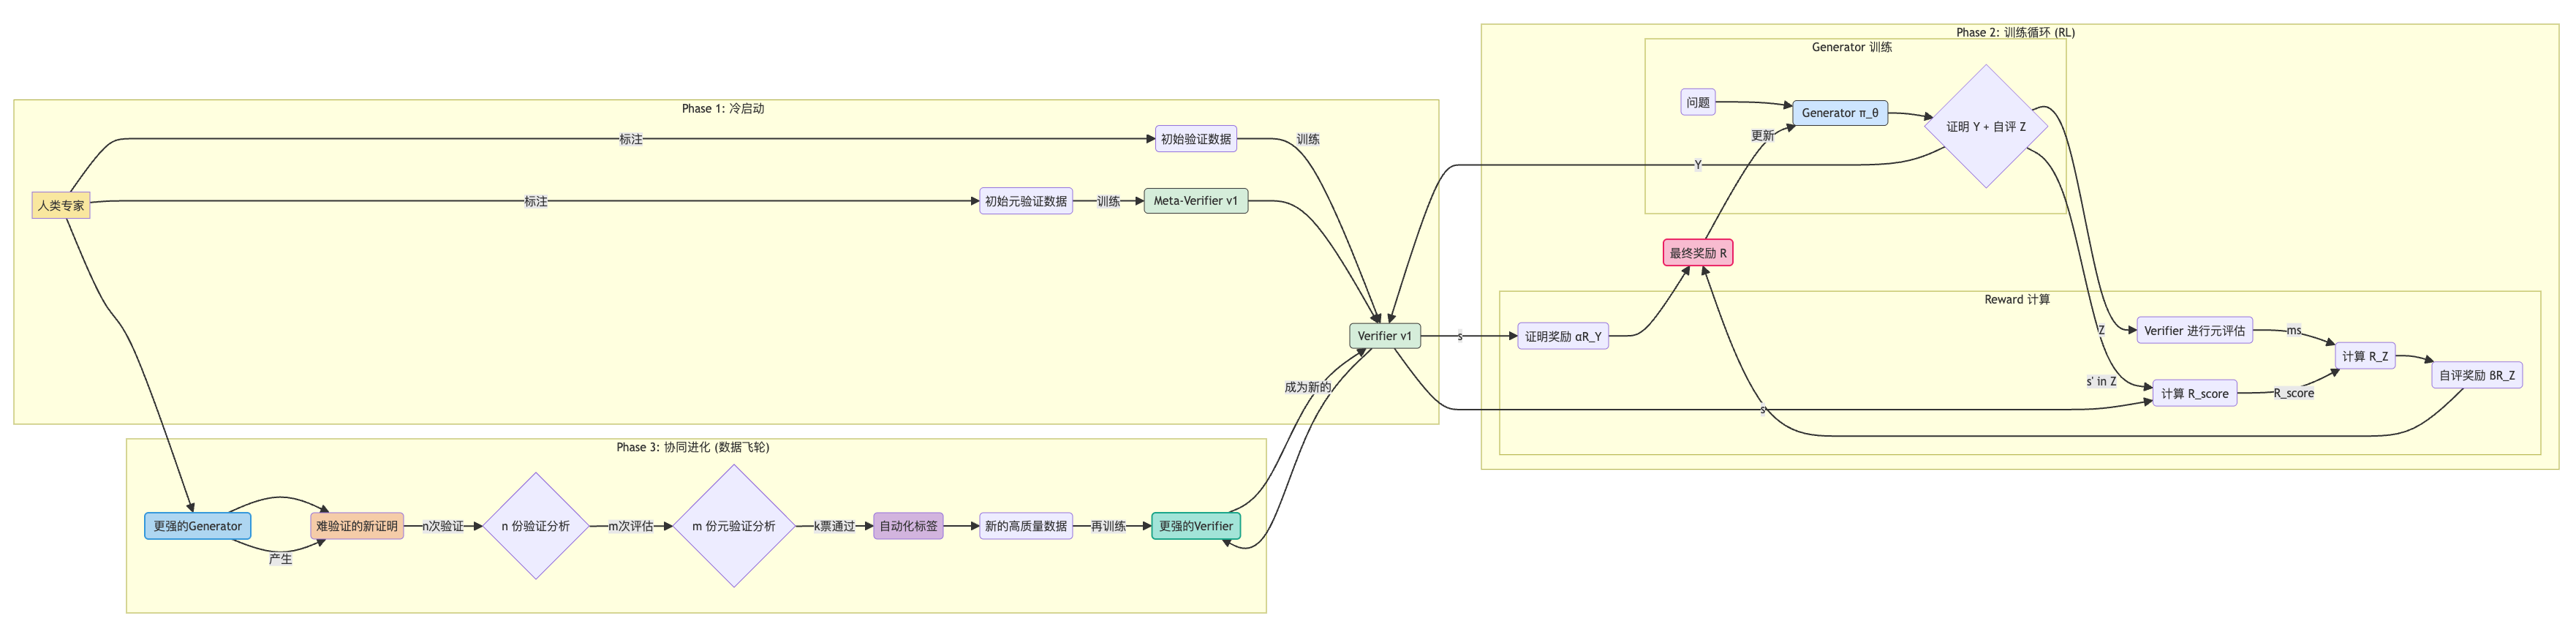
作者采用 GRPO 进行强化学习, 迭代地优化证明验证和生成能力. 在每次迭代中, 首先优化证明验证能力. 证明生成器随后从验证器检查点初始化, 并为证明生成进行优化. 从第二次迭代开始, 证明验证器从一个通过拒绝采样微调(rejection fine-tuning)整合了上一轮验证和生成能力的检查点进行初始化.
2.4 实验
训练出来的DeepSeekMath-V2将在以下定理证明基准上评估:
- 内部的全国高中数学联赛(CNML)难度相当的问题. 91个定理证明问题, 涵盖代数(13), 几何(24), 数论(19), 组合(24)和不等式(11)
- 竞赛问题, 包含 IMO 2025 / CMO 2024 / Putnam 2024 / ISL(IMO shortlist) 2024 / IMO-ProofBench等.
2.4.1 单次生成
首先评估模型在没有迭代精炼(iterative refinement)的情况下生成正确证明的能力. 在内部CNML问题集上, 作者为每个评估的模型在每个问题上生成8个证明样本. 证明的正确性是通过最终版验证器产生的8个验证分析进行多数投票来衡量的.(渣注: 相当于一个Pass@8, Best@8的变体)
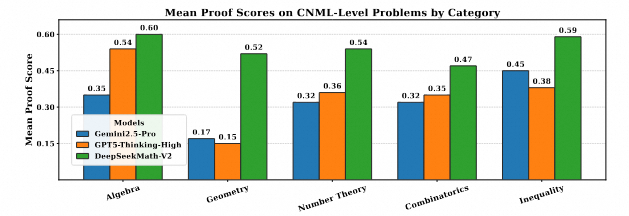
如图所示, 在CNML级别问题的所有类别(代数, 几何, 数论, 组合和不等式中), DeepSeekMath-V2始终优于GPT-5-Thinking-High (OpenAI, 2025) 和 Gemini 2.5-Pro (DeepMind, 2025).
2.4.2 基于自我验证的序列化精炼
对于像IMO和CMO这样的竞赛难题, 模型通常无法在128K token的限制内一次性生成全面且严谨的证明. 当这种情况发生时, 证明生成器能通过自我验证认识到其证明是无效的, 但缺乏足够的上下文长度在单次尝试中解决所有已识别的问题.
为了探索扩展上下文和自我验证如何能改善证明质量, 作者评估了基于自我验证(Self-verification)的序列化精炼(Sequential Refinement). 该方法首先生成一个带自我分析的证明, 然后用其之前的输出迭代地重新提示生成器, 使其能够解决已识别的问题. 这个过程一直持续, 直到生成器给自己打了满分, 或达到最大序列化尝试次数.
下图展示了在IMO Shortlist 2024问题上通过序列化精炼带来的证明质量提升. 对每个问题, 作者启动了32个独立的精炼线程. 证明的正确性通过我们最终版验证器的32个验证分析进行多数投票来衡量.
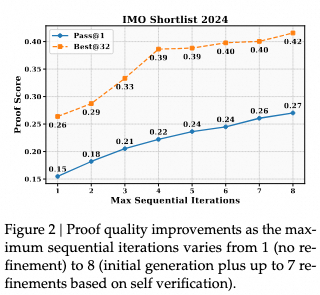
在图中报告了两个指标:
- Pass@1 – 每个线程最终证明的平均分数
- Best@32 – 每个问题最好的证明的分数, 该证明是根据所有线程的自评分数选出的.
Pass@1曲线的上升表明, 迭代本身是有益的, 模型确实在根据自己的判断进行有效的修正.Best@32曲线远高于Pass@1, 证明模型不仅会改, 还知道哪次改得好. 这种"自知之明"对于在大量样本中自动筛选出最佳候选至关重要, 极大地提升了搜索效率.
2.4.3 高算力搜索
为了解决最挑战性的问题, 作者扩展了验证和生成两方面的计算: 使用广泛的验证来识别细微的问题, 并行生成来探索多样的证明策略.
通过为每个问题维护一个候选证明池, 初始化为64个证明样本, 并为每个样本生成64个验证分析. 在每次精炼迭代中, 根据平均验证分数选出得分最高的64个证明, 并为每个证明随机配对8个分析报告, 优先选择那些识别出问题(分数为0或0.5)的. 每个“证明-分析”对被用来生成一个精炼后的证明, 然后更新候选池. 这个过程持续最多16次迭代, 或直到某个证明成功通过所有64次验证尝试, 这表明对其正确性有很高的信心. 所有实验都使用单个模型, 即最终的证明生成器, 它同时执行证明生成和验证.
为了验证结果, 数学专家评估了得分最高的证明. 作者的方法解决了IMO 2025的6个问题中的5个, 以及CMO 2024的4个问题外加另一个的部分分, 在这两个顶级高中竞赛中都取得了金牌表现. 在Putnam 2024, 这个卓越的本科生数学竞赛中, 模型完全解决了12个问题中的11个, 剩下的一个有轻微错误, 取得了118/120的分数, 超越了人类最高分90分. 下图展示了在IMO-ProofBench上的结果. 该方法在Basic上优于DeepMind的DeepThink (IMO Gold), 在Advanced上保持竞争力, 同时大幅优于所有其他基准. 我们观察到最难的IMO级别问题对我们的模型来说仍然有挑战.
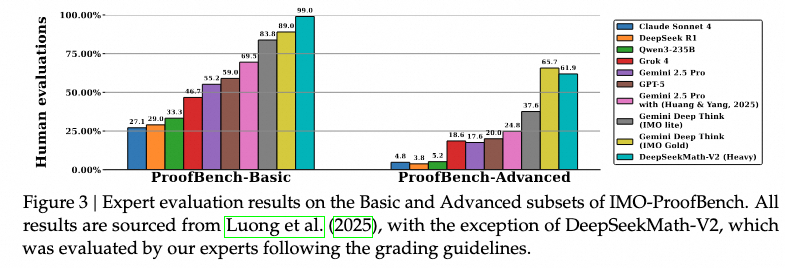
值得注意的是, 对于未完全解决的问题, 生成器通常能识别出其证明中的真实问题, 而完全解决的问题则能通过所有64次验证尝试. 这表明DeepSeek团队能成功训练基于LLM的验证器来评估以前被认为难以自动验证的证明. 通过在验证器指导下扩展测试时计算, 模型解决了需要人类竞争者花费数小时努力的问题.
3. 编程领域
IOI和ICPC被广泛认为是算法编程竞赛的巅峰. 这些竞赛是评估 AI 在编程竞赛和整体通用推理能力方面的一个重要里程碑. 去年OpenAI和Deepmind都报道了使用专有方法在 ICPC 2025 中取得了金牌级别的表现. 但是这些模型很少被公开, OpenAI仅在一篇论文中大概介绍了一下子问题聚类和基于Reward重排的实现.
接下来我们基于nv的一篇开源实现的论文 GENCLUSTER 《Scaling Test-Time Compute to Achieve IOI Gold Medal with Open-Weight Models》[3]来详细介绍, GENCLUSTER的实现如下: 首先为每个问题生成大量的候选解决方案, 然后通过一个包含过滤、行为聚类和锦标赛排序的流水线进行提炼. 最后, 一种轮询提交策略会在遵守 IOI 对人类参赛者施加的相同提交约束下, 选出最佳候选方案.
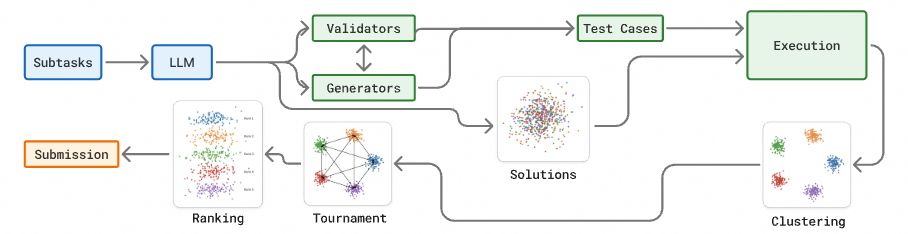
GENCLUSTER 能够使开源权重模型 gpt-oss-120b (OpenAI, 2025) 在 IOI 2025 中达到金牌水平. 另一方面DeepSeek-V3.2也宣称可以在IOI 2025中达到金牌水平, 我们将在稍后的章节中详细介绍DeepSeek-R1和V3.2的后训练过程.
在编程竞赛中, 不同的竞赛会有不同的赛制. 例如ICPC和IOI都会有提交反馈, 并且对运行时间和内存占用也有约束. ICPC的记分方式需要全对, 同时还有根据提交错误进行罚时. 而IOI会按点给分. 例如我们以IOI 2025第一题[4]为例, 它分成了6个子任务, 每个子任务有不同的分值. 子任务的分数被累加以得出一个问题分数, 每个问题最高 100 分. 参赛者可以改进并重新提交他们的解决方案, 但每个问题最多允许 50 次提交, 这使得提交策略成为表现的一个关键因素.
GENCLUSTER的评估数据集是在子任务级别而非问题级别组织的. 对于每一个子任务, 作者通过移除所有与其它子任务相关的信息, 创建了一个独立的实例, 将其隔离成一个独立的评估单元. GENCLUSTER 包括四个阶段: (1) 并行生成, (2) 行为聚类, (3) 锦标赛排序, 以及 (4) 提交.
3.1 并行生成
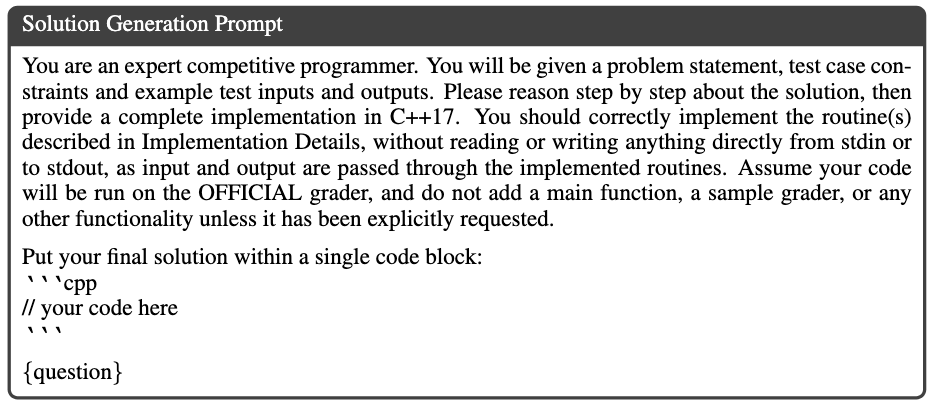
首先根据如下Prompt为每个子任务生成 K 个候选解决方案. 由于生成过程是相互独立的, 它们可以并行执行, 这使得该方法具有可扩展性. 那些无法解析出代码或代码无法编译的生成结果将被过滤掉.
3.2 行为聚类
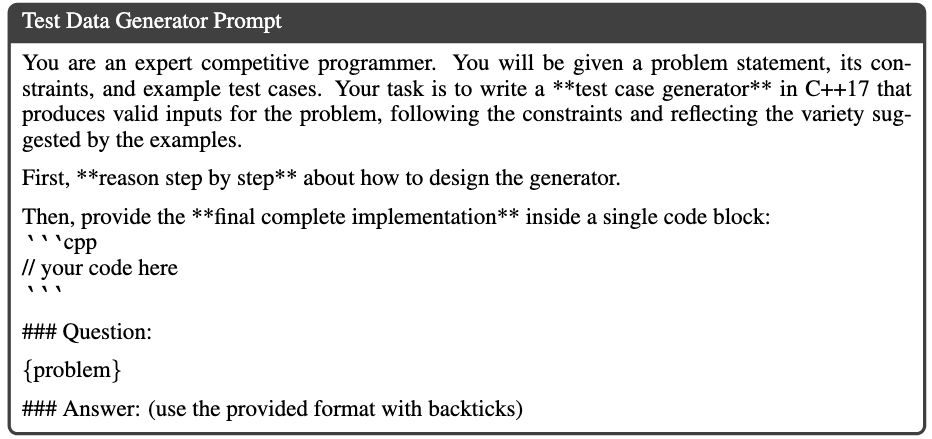
在此阶段, 根据相似的行为对候选解决方案进行分组, 以减少候选者的数量并使排序更有效. 对于每个子任务, 首先指示 LLM 产出多个不同的程序, 这些程序能够生成符合子任务规范的随机化测试输入. 生成测试数据的Prompt如下:
为确保测试输入的正确性, 还要求模型产出多个独立的验证器. 验证器的Prompt如下:
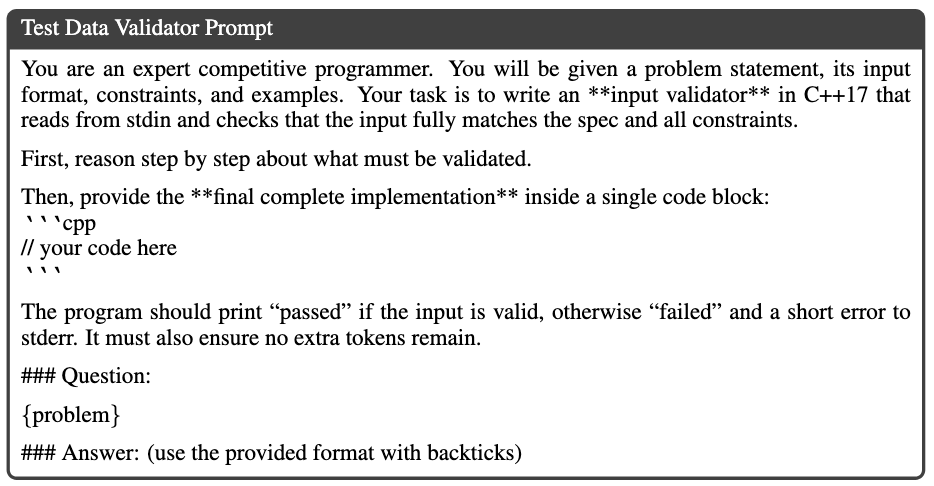
每个验证器程序会检查一个给定的输入是否满足子任务的特定约束. 一旦GENCLUSTER创建了所有的测试生成器和验证器, 就遍历这些生成器. 对每一个生成器, 产出一个测试输入, 并用所有验证器对其进行评估. 如果至少 75% 的验证器认可该输入, 就将其保留为一个有效的测试用例. 这个过程在所有生成器上重复, 直到收集到所需数量的被接受的测试用例.
一个子任务的所有候选解决方案都在所有测试用例上执行, 然后根据它们的输出进行聚类. 产出完全相同输出的解决方案被分到同一个聚类中. 为了效率, 通过计算输出的哈希值以加速聚类. 如果一个聚类中的解决方案由于任何原因 (如运行时错误) 对任何测试输入产生了空输出, 那么该聚类将被完全移除.
3.3 锦标赛排序
对候选方案进行聚类会产生大量的行为相似的解决方案组. 因此, 我们需要一个排序机制来优先选择最有希望的聚类进行提交. 先前已有工作研究如何在多个生成的候选中选择最佳方案; 然而, 大多数现有方法不太适合GENCLUSTER的场景, 或者没有在可比的条件下进行评估. 具体来说:
- 它们无法扩展到实验所需的大量解决方案;
- 它们主要是在数学等任务上设计和评估的, 在这些任务中, 多数投票可以轻易地识别出正确答案;
- 它们专注于选择而非候选方案的排序.
GENCLUSTER提议在聚类之间举办一场受部分循环赛启发的锦标赛. 每个聚类与随机选择的聚类进行 次比赛. 我们从每个聚类中选择具有最长思考长度 (longest thinking length) 的解决方案作为代表. 然后将两个聚类的代表提供给 LLM, LLM 被提示在成对比较中选择更好的解决方案.Prompt如下:
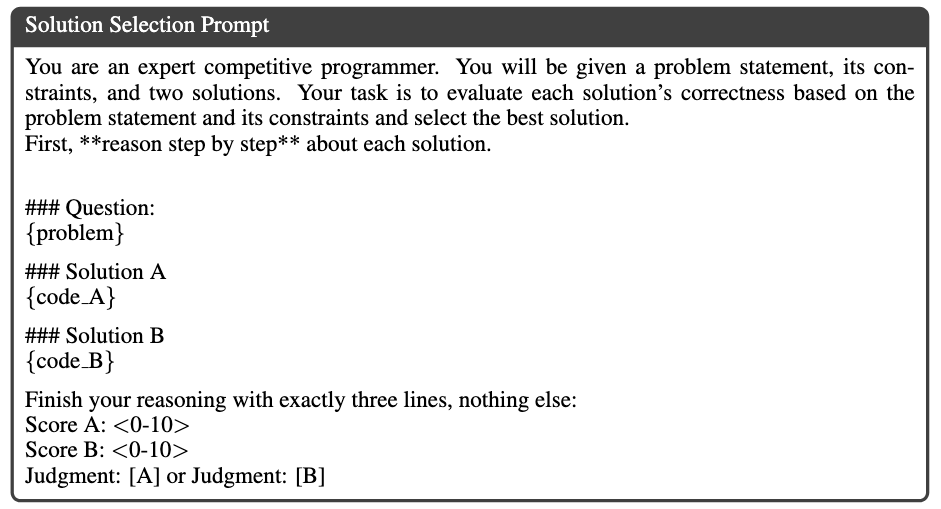
每场比赛产生一个赢家. 锦标赛结束后, 聚类根据其代表候选者的获胜次数进行排名. 为了减轻模型判断中的新近度偏见 (Recency Bias), 作者将两个解决方案的呈现顺序随机化; 每个解决方案在其大约一半的比赛中首先出现.
3.4 提交策略
GENCLUSTER使用轮询 (round-robin) 策略, 为每个问题提交最多 50 个解决方案 (IOI 允许的最大数量). 作者从每个问题的最后一个子任务开始, 这通常是最难的. 对于每个子任务, 按其聚类的排名顺序进行迭代, 从每个聚类中选择一个解决方案并提交计分. 在每个聚类内部, 单个解决方案按其推理长度 (reasoning length) 排序, 我们将其用作正确性可能性的一个代理指标. 我们继续每次从排名靠前的聚类中提交一个解决方案, 以轮询方式在聚类间循环, 并在每个聚类内部轮换解决方案. 一旦一个子任务被解决 (即, 它的最高分被达到), 我们就跳过其剩余的聚类, 并按照 OpenAI 等的做法继续处理下一个子任务.
3.5 一些补充
GENCLUSTER的工作中, 其实主要还是在构建基于模型Test-Time Compute的Scaling能力, 同样它采用了让同一个模型生成多个答案, 并且由另一个验证器生成测试数据, 并对执行完的结果进行聚类和排序. 但是似乎整个流程还可以进一步深入进行一些RL训练的工作.
- Validators: 对自我测试集的生成, 例如我们可以有针对性的进行一些SFT / RL的处理, 使得用于LLM自我验证的测试集更加完善, 特别是一些corner case的生成. 因为在ICPC这样的赛制下, 错误的提交会带来罚分. 或者像NOI/NOIP这样的赛制, 并没有提交反馈的机会. 因此对生成的代码进行测试需要进一步的强化.
- Generators: 对于生成器而言, 是否需要有一个两阶段的生成过程. 例如先对问题进行一个形式化的描述. 然后进行一些推理. 再基于这些推导进一步生成代码. 这部分的工作应该还可以进一步加强.
- 同理, 类似于前一章针对数学领域问题的处理, 我们是否还可以把Generator和Validator进一步的进行互相迭代, 增强模型的解题能力?
- 另一方面还有针对聚类的处理, 如何在语义上通过LLM分析两种不同的代码在算法上是等价的?
4. 回顾RLVR
我们注意到, 无论是第二章用于数学领域证明并达到IMO金牌能力的DeepSeek-Math-V2, 还是第三章中在算法竞赛IOI中达到金牌能力的GENCLUSTER. 他们不约而同地指向了一个核心思想: 通过构建一个精密的“生成-验证”(Generator-Verifier)系统, 并大规模投入测试时计算(Test-Time Compute), 来解决远超模型单次推理能力的复杂逻辑问题. 这套方法论, 我们可以泛化地称之为RLVR. 两项工作都清醒地认识到, 面对IMO级别的数学证明或IOI级别的算法难题, 期望LLM像计算器一样“一次性”给出完美答案是不现实的. 它们共同的出发点是放弃对单次生成结果的幻想, 转而构建一个系统性的流程, 该流程至少包含两个基本角色:
- 生成器 (Generator): 负责产出大量的候选解(数学证明或代码).
- 验证器 (Verifier): 负责以某种方式评估这些候选解的质量.
这标志着AI解题思路从单一的"直觉式输出"转向了更接近人类专家的"推敲式探索". 另一方面, 无论是数学还是编程, "验证"环节都是整个系统的支点.
- 在数学领域, 验证器 的任务是阅读一个证明, 并从逻辑严谨性上给出一个评分(). 这个评分直接成为奖励信号.
- 在编程领域, "验证"的概念被分解和具体化了: 首先通过自动生成的测试用例进行行为验证(执行代码, 检查输出), 然后通过LLM裁判在锦标赛中进行优劣验证(成对比较, 判断哪个更好).
尽管形式不同, 但本质都是利用一个独立的评判标准来量化或排序生成物的质量, 从而为后续决策提供依据. 另外它们都没有试图在有限的计算内“教会”模型所有知识, 而是选择在解决具体问题时, 不计成本地增加计算投入.
- DeepSeek-Math-V2 通过序列化精炼和高算力搜索, 让模型与自己生成的评估进行多轮对话, 或并行探索数十个证明路径, 每次迭代都是一次昂贵的计算.
- GENCLUSTER 则通过并行生成数千个候选方案, 并对它们进行聚类和锦标赛排序, 这同样是一个计算密集型的筛选过程.
这两种方法都体现了一种工程上的务实主义: 如果单次推理的“质量”不够, 就用海量计算的“数量”来弥补,并通过一个高效的验证机制从数量中提炼出质量. 一个有趣且深刻的共同点是, 两个系统都大胆地将LLM本身用作了评估者.这表明研究者们相信, 即使LLM在生成复杂解法时会犯错, 但它们在识别错误或进行相对优劣判断方面的能力是相对更可靠的, 并且这种能力可以通过训练得到强化. 这是一种将LLM的能力进行“任务解耦”的巧妙应用.
更进一步我们可以构造一个如下的“生成器--验证器”强化学习迭代训练回路, 进一步提升模型的能力.
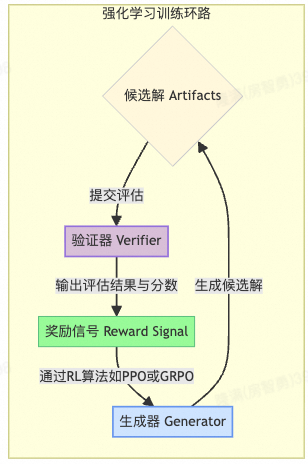
那么我们进一步就要问一个问题, 能否构建一个相对通用的 Reward Model用于这样的迭代?
5. GRM
传统的大语言模型强化学习(RL)十分依赖奖励模型(RM)来提供信号. 过去, 我们在数学、代码等"对错分明"的领域取得了巨大成功, 因为这些任务天生带有明确的客观规则. 但当大模型走进日常对话、创意写作等泛化领域时, 评价标准变得极其主观且复杂. 更棘手的是, 传统的标量奖励模型像一个只会死记硬背给分数的考官, 无论你给它多少思考时间(推理算力), 它给出的分数都不会变好, 也就是缺乏"推理期可扩展性"(Inference-Time Scalability).
DeepSeek团队的这项研究提出了一种 生成式奖励模型(Generative Reward Modeling, 简称GRM) 的范式, 即《Inference-Time Scaling for Generalist Reward Modeling》[5]. 这种范式不直接输出一个冷冰冰的分数, 而是像一个负责任的老师一样, 先写出具体的评分标准(Principles), 然后根据标准写出详细的评语(Critiques), 最后再给出打分.
为了让这位"AI考官"在拥有更多时间时能做到精益求精, DeepSeek团队提出了 自发则批判微调(Self-Principled Critique Tuning, 简称SPCT) 机制. 这一机制摒弃了传统人类设定的死板规则, 而是通过拒绝采样微调(Rejective Fine-Tuning)作为冷启动, 结合基于规则的在线强化学习(Rule-based RL), 让模型学会针对不同问题动态生成合适的评分准则. 当我们在推理阶段增加算力(即让模型多次并行采样生成不同的评分准则和评语)时, 它们设计了一个"元奖励模型"(Meta RM)来担任"主考官", 从多次不同的打分逻辑中投票选出最靠谱的结果.
5.1 不同奖励模型(RM)方法的比较
如图所示, 奖励模型(RM)的方法主要由奖励生成范式(reward generation paradigms) 和 评分模式(scoring patterns) 决定, 这内在地影响了RM的推理时可扩展性(inference-time scalability) 和 输入灵活性(input flexibility).
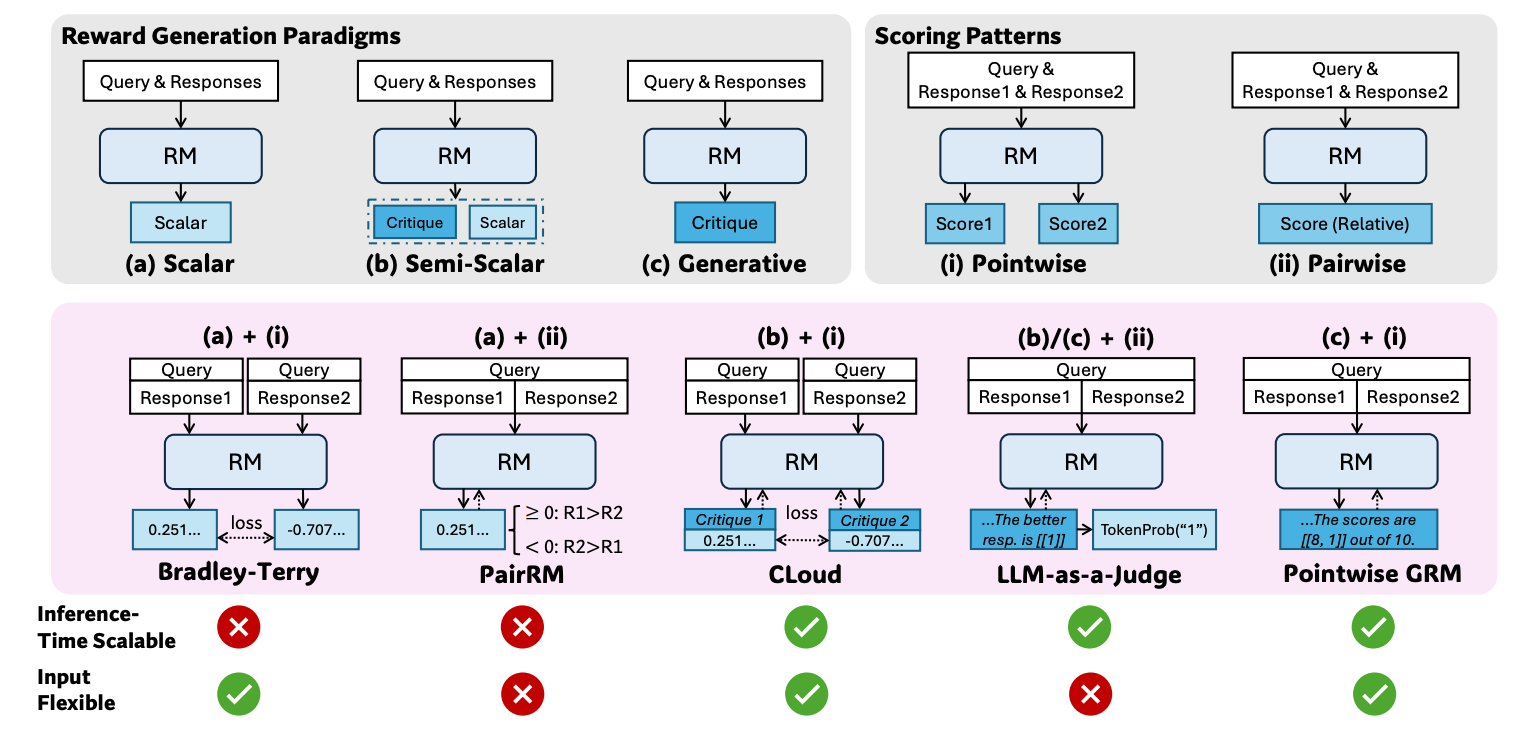
奖励生成范式
作者区分三种主要方法: (a)标量(scalar), (b)半标量(semi-scalar) 和 (c)生成式(generative). 经典的RM采用标量方法来生成奖励(R), 它为给定的查询和回复分配标量值. 标量方法被进一步扩展为半标量方法, 它在生成标量值的同时还生成文本. 而生成式方法则只生成文本形式的奖励.
其中是查询, 是第个回复, 是由参数化的奖励函数, 是标量奖励, 是评判文本(critique).
评分模式
作者区分两种主要方法: (i)逐点式(pointwise) 和 (ii)成对式(pairwise).
逐点式方法 为每个回复分配一个独立的分数:
其中是一个分割函数.
成对式方法可以被看作是一种best-of-n的方法, 从所有候选中选择一个最佳回复:
其中是一个选择函数, 并且在大多数情况下. 尽管成对式方法可以扩展到, 但它不能应用于单个回复的评分().
为了在推理时扩展计算使用量, 这篇文章专注于基于采样的方法, 即为相同的查询和回复生成多组奖励, 然后聚合得出最终奖励. 因此, RM的推理时可扩展性取决于是否能通过多次采样获得不同的奖励, 在这一点上, 标量RM因其生成的奖励不变而在大多数情况下会失败; 而输入灵活性则定义为RM是否支持对单个, 成对和多个回复进行评分, 在这一点上, 成对式RM几乎无法对单个回复进行评分, 并且通常需要额外的技术来处理多个回复.
然后基于这几种模式, 有五种范式
| 组合 (范式 + 模式) |
代表性方法 | 工作方式 | 输入 灵活性 |
推理时 可扩展性 |
核心局限 |
|---|---|---|---|---|---|
| (a) 标量 + (i) 逐点 |
Bradley-Terry 模型 (变体) | 模型为每个候选回复输出一个独立的标量分数. 例如输入{R1, R2}, 输出{S1, S2}. |
高 | 低 | 输出是确定的标量, 多次采样无法产生新信息, 无法通过增加推理计算来提升评判质量. |
| (a) 标量 + (ii) 成对 |
PairRM | 模型为一对回复输出一个标量分数S, 通过S的符号判断哪个更好. 例如, S > 0则R1更好. |
低 | 低 | 只能处理成对比较, 无法评估单个或多个回复. 同样, 标量输出导致无法扩展. |
| (b) 半标量 + (i) 逐点 |
CLoud | 模型生成一段评判文本, 同时一个独立的"价值头(value head)"为每个回复输出一个标量分数. | 高 | 有限 | 评判文本可以多样, 但最终分数仍由一个倾向于确定性输出的标量头决定, 扩展潜力受限. |
| (c) 生成式 + (ii) 成对 |
LLM-as-a-Judge | 模型生成一段自然语言, 明确指出两个回复中哪一个更好, 例如生成"...所以, 回复A更好." | 低 | 中等 | 只能成对比较. 但因为是生成式, 多次采样可以进行多数投票(majority voting), 有一定扩展性. |
| (c) 生成式 + (i) 逐点 |
Pointwise GRM (本文选择) |
模型生成一段完整的评判文本, 并在文本中直接包含对每个回复的独立打分. 例如"...综上, 最终得分: [[8, 5]]". | 高 | 高 | 可以灵活处理单个, 成对或多个回复. 每次采样都可能生成不同的评判视角和分数, 聚合后能得到更鲁棒的结果. |
5.2 利用原则提升奖励质量
通用奖励模型(Generalist RM)需要在特定领域之外生成高质量的奖励, 在这些通用领域中, 奖励的标准更加多样和复杂, 并且通常没有明确的参考或基准真相. 为此, 对于通用领域, 采用原则(principles) 来指导奖励生成, 以替代人为制定的规则. "原则"的概念最早在 Constitutional AI 中被引入, 它们是指导LLM或经过策划的分类器构建安全数据管道的手工制定的标准. 有了原则, GRM的奖励生成过程变为:
其中表示原则. 通过实验作者发现, 自我生成的原则几乎不能提升性能, 但过滤后的原则可以显著提升奖励质量. 从中得出两个主要结论:
- 当前的LLM可以生成多样的原则, 但并非所有原则都适合用于奖励生成.
- 一部分生成的原则可以在正确的标准下更好地指导奖励生成, 这表明了自我引导(self-bootstrapping)的潜力. 这些发现是使用在线强化学习来优化GRM的基础, 模型可以从自己生成的原则中学习, 只要有一个清晰的信号告诉它们这些原则是否合适.
5.3 自我原则评判调优 (Self-Principled Critique Tuning, SPCT)
受初步实验结果的启发, 作者开发了一种新方法, 让逐点式GRM学习生成能够有效指导评判生成的自适应, 高质量原则. 这种方法被称为自我原则评判调优(Self-Principled Critique Tuning, SPCT). 如图所示, SPCT包含两个阶段: 作为冷启动的拒绝式微调(rejective fine-tuning), 和通过推进生成的原则与评判来增强通用奖励生成能力的基于规则的在线强化学习(rule-based online RL).
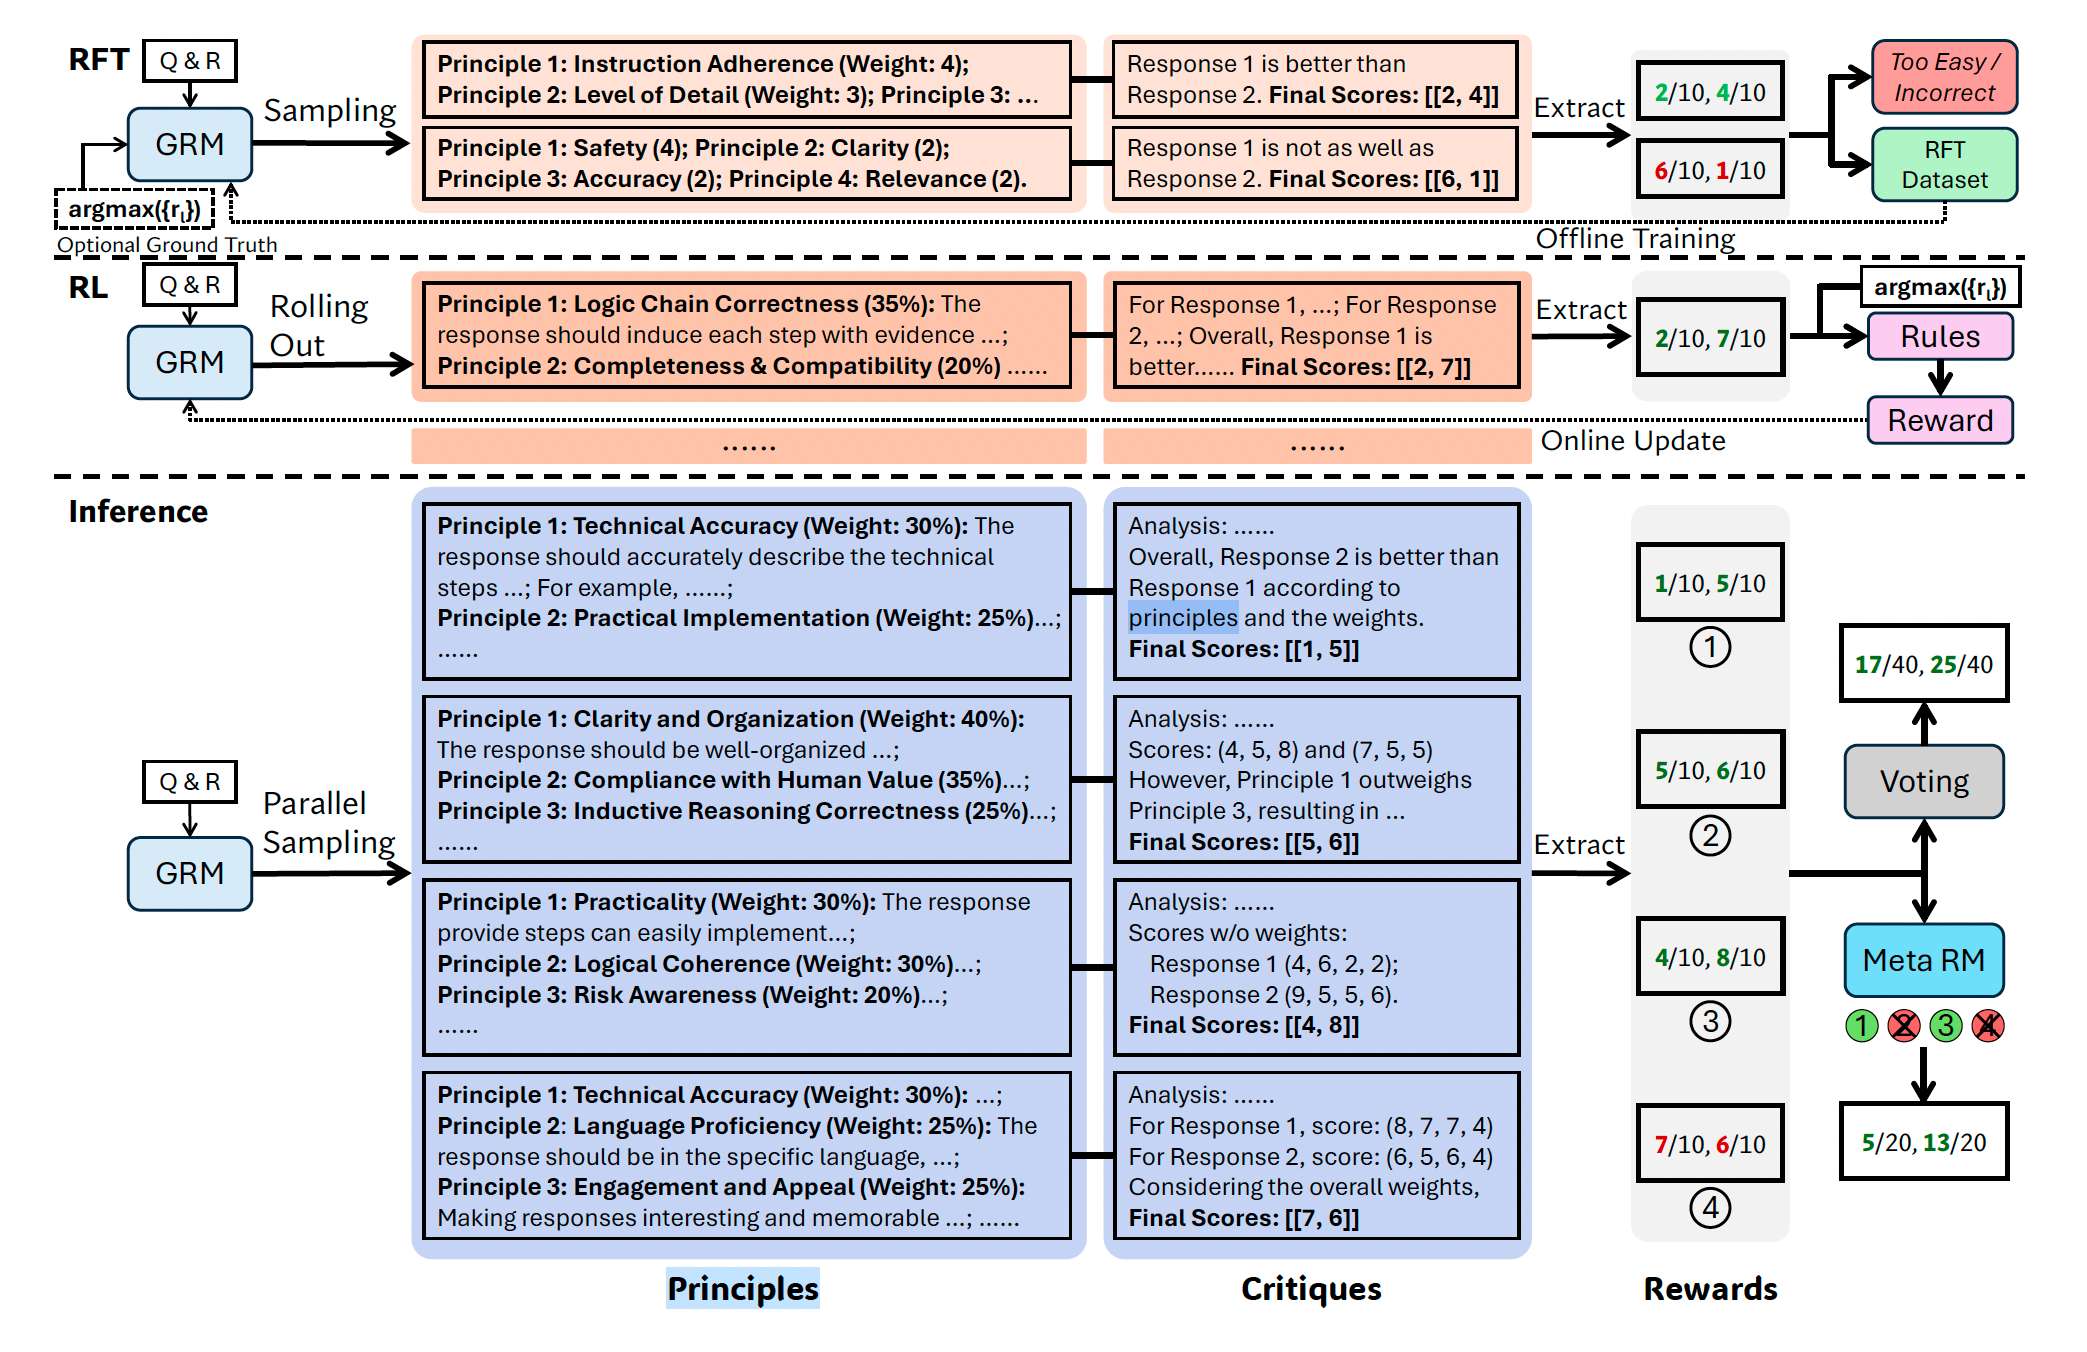
将原则从理解任务转变为生成任务
在基于原则的初步实验中, 作者发现适当的原则可以在特定标准内指导奖励生成, 这对于高质量奖励至关重要. 然而, 如何大规模地为通用RM生成有效的原则仍然是一个挑战. 为了解决这个挑战, 作者建议将原则从一个理解任务转变为一个生成任务, 也就是说, 将原则视为奖励生成的一部分, 而不是一个预处理步骤.
形式上, 当原则是预定义时, 它们遵循公式8指导奖励的生成. GRM可以自己生成原则, 然后基于这些原则生成评判, 这可以形式化为:
其中 是由 参数化的原则生成函数, 它与奖励生成函数 共享同一个模型. 在实践中, 它们是通过LLM中同一个语言模型头来实现的. 这种转变使得原则可以根据输入的查询和回复自适应地生成, 从而调整奖励生成过程. 并且, 原则与相应评判的质量和粒度, 可以通过对GRM进行后训练得到进一步提升. 当原则被大规模生成时, GRM有潜力输出粒度更精细, 考量更全面的奖励, 从而实现更好的推理时可扩展性.
RFT冷启动
拒绝式微调阶段的核心思想是训练GRM以正确的格式为各种输入类型生成原则和评判. 作者采用逐点式(Pointwise )GRM, 以相同的格式灵活地为任意数量的回复生成奖励.
在数据构建方面, 除了通用的指令数据, 作者还通过一个预训练的GRM, 给定查询和相应回复来采样轨迹. 每个RM数据点包含一个查询和一到多个对该查询的回复, 以及一个指明最佳回复的真实标签. 对于每个RM数据点, 原则和评判的采样会执行次. 拒绝策略也是统一的, 即拒绝那些预测奖励不正确的轨迹, 以及那些所有次轨迹都正确的(过于简单)查询和回复.
形式上, 设是第个回复对查询的真实奖励, 预测的逐点式奖励被认为是正确的, 如果:
这里有一个保证, 即真实奖励中只有一个最大值. 作者发现在有限的采样配额内, 预训练的GRM很难为一部分查询和相应回复生成正确的奖励. 因此, 作者选择性地将附加到GRM的提示(prompt)中, 称为提示采样(hinted sampling), 以期望除了非提示采样(non-hinted sampling)之外, 预测的奖励能与真实标签对齐. 具体来说, 一个额外的片段"最佳回复是: 回复 "将被附加到输入中. 对于提示采样, 每个查询和相应回复只采样一次, 只有当轨迹不正确时才会被拒绝. 作者观察到提示采样的轨迹有时在生成的评判中会走捷径(take shortcuts), 特别是在推理任务中, 这表明了对GRM进行在线强化学习的必要性和潜在好处.
Rule-Based RL
GRM会通过基于规则的在线强化学习进一步微调. 具体来说, 作者使用GRPO的原始设置, 配合基于规则的结果奖励(outcome rewards). 在部署(rollout)期间, GRM根据输入的查询和回复生成原则和评判, 然后提取预测的奖励, 并通过准确性规则与真实标签进行比较. 不同的是, 这里没有使用格式奖励. 作为替代, 作者应用了更大的KL惩罚系数来确保格式并避免严重的偏见.
形式上, 对于给定的查询和回复, 第个输出的奖励为:
其中逐点式奖励是从输出中提取的. 这个奖励函数鼓励GRM通过在线优化的原则和评判来区分出最佳回复, 这有利于实现有效的推理时扩展. 这种奖励信号可以从任何偏好数据集和已标记的LLM回复中无缝获得.
5.4 基于SPCT的推理时扩展
利用生成式奖励进行投票
投票是奖励模型(RM)中一种被广泛采用的推理时扩展方法.
对于半标量RM , 投票通过取平均值的方式进行:
其中是最终奖励. 在实践中, 标量值的方差有限, 这可能会阻碍可扩展性.
对于Pairwised GRM , 投票通过选择被识别为最佳次数最多的回复来进行, 即多数票制:
其中是最终预测的最佳回复, 是一个选择函数, 是每次采样中独立选出的最佳回复, 是指示函数. 尽管投票过程是可扩展的, 但多数票选出的结果可能会有偏差, 因为每次采样都不允许平局, 并且由于缺乏量化分数, 可能无法区分回复之间的细微差异.
对于逐点式GRM, 投票过程被定义为对奖励进行求和:
其中是第个回复的最终奖励(), 而是第次采样得到的一组逐点式奖励. 由于通常被设定在一个小的离散范围内, 例如, 投票过程实际上将奖励空间扩大了倍, 并使得GRM能够生成大量的原则, 这有利于最终奖励的质量和粒度. 一个直观的解释是, 如果每个原则都可以被看作是评判视角的一个代理, 那么大量的原则可能能更准确地反映真实分布, 从而带来扩展的有效性. 值得注意的是, 为了避免位置偏差并增加多样性, 回复在采样前会被打乱顺序.
Meta RM引导投票
DeepSeek-GRM的投票过程需要多次采样, 由于随机性或模型限制, 少数生成的原则和评判可能是带有偏见或低质量的. 因此, 作者训练了一个元奖励模型(meta RM) 来引导投票过程.
这个元奖励模型是一个逐点式的标量RM, 训练它来识别DeepSeek-GRM生成的原则和评判的正确性, 采用二元交叉熵损失进行训练, 其标签根据公式10来确定. 提示模板整合了查询, 候选回复, 相应的原则和评判. 数据集包含来自RFT阶段的非提示采样轨迹, 以及从将被引导的DeepSeek-GRM中采样的轨迹, 这样做既能提供足够的正负奖励样本, 并且缓解训练和推理策略之间的差距.
引导投票的过程很简单: 元RM为个采样出的奖励输出元奖励, 而最终的结果由元奖励排名前的那些奖励投票得出, 从而过滤掉低质量的样本.
5.5 回顾GRM整个流程
我们再次回到原论文的配图来回顾整个流程:
这张图描绘了如何训练并使用一个DeepSeek-GRM的全过程. 我们用一个形象的例子来说明整个过程
A. 离线训练: "海选 + 基础课" (RFT阶段)
- 海选 (左上角): 想象一下, 我们要办一个裁判培训班. 首先, 我们让一个助教AI(预训练GRM)对大量的比赛录像(查询Q, 回复R)写评判报告.
- 筛选 (左侧): 我们作为总教官, 对这些报告进行筛选.
- 如果报告的结论(打分)和我们已知的比赛结果不符, 扔掉!
- 如果比赛太没悬念, 助教每次都评对, 扔掉!
- 只留下那些有一定难度, 且助教给出了正确分析的"优秀范文".
- 基础课 (左侧): 把这些"优秀范文"交给我们的学员AI, 让他们模仿学习, 掌握写评判报告的基本格式和套路. 经过这一步, 学员们毕业, 拿到了"冷启动模型".
B. 在线更新: "模拟赛 + 复盘" (RL阶段)
- 模拟赛 (中间): 现在, 学员们要参加模拟赛了. 拿到一场新比赛, 他们必须独立写出评判报告.
- 复盘 (中间): 赛后, 我们用一个最简单的规则来复盘: 你评对了吗?
- 评对了, 给你加分(+1).
- 评错了, 给你扣分(-1).
- 自我进化: 学员们根据加分或扣分, 不断反思自己的评判思路("我刚才用的那套标准是不是有问题?"), 调整自己的评判. 通过无数次这样的循环, 他们从只会模仿的菜鸟, 成长为能独立思考的专家. 最终毕业, 成为DeepSeek-GRM.
C. 推理: "专家团会审" (Inference阶段)
- 召集专家团 (下半部中间): 现在, 真正的比赛来了. 我们不再只让一个毕业的专家(最终模型)来评判, 而是让他"分身"成一个k人的专家团(并行采样k次).
- 独立评审: 每个"分身"都会从自己独特的视角(生成不同的原则), 独立撰写一份评判报告. 于是我们得到了k份视角各异的报告.
- 汇总意见 (投票): 如何综合这k份报告呢?
- 方式一: 简单投票 (Naive Voting). 最民主的方式. 把每份报告里给选手A和选手B的分数分别加起来, 谁总分高谁就赢.
- 方式二: 主席团引导投票 (Meta RM Guided Voting). 更精英的方式. 我们额外请来一个"主席团"(Meta RM). "主席团"不直接评判选手, 而是评判这k份报告本身的质量. 哪些报告分析得深入, 哪些在敷衍了事, "主席团"一目了然. 然后, 我们只采纳那些被评为"高质量"的报告进行投票.
- 最终裁决: 无论通过哪种投票方式, 我们最终都会得到一个比任何单个专家意见都更可靠, 更公正的评判结果.
对比第二代LRM模型, 传统的LLM训练, 无论是SFT还是RLHF, 重点都在于优化最终生成的内容(response). 而SPCT的巧妙之处在于, 它将优化目标扩展到了生成评判的思考过程.
- "原则"就是这个思考过程的显式表达.
- RFT阶段教会模型这个思考过程的"语法"(格式).
- RL阶段则通过结果导向的奖励, 优化这个思考过程的"逻辑"(什么样的原则和分析是有效的).
通过让模型生成并优化自己的思考过程, SPCT不仅提升了评判的准确性, 还带来了额外的两个好处:
- 可解释性: 我们可以通过查看模型生成的原则, 来理解它做出某个判断的依据.
- 可控性: 理论上, 我们可以通过在prompt中注入特定的原则, 来引导模型的评判方向.
另一方面并行采样带来了有益的"视角多样性", 但多样性不等于高质量. k次采样中, 有可能出现一些低质量的, "胡思乱想"的评判.
- 简单投票 (Naive Voting) 的问题在于, 它对所有采样一视同仁, 给了低质量评判与高质量评判相同的权重. 这可能会"污染"最终结果.
- Meta RM 的引入, 是一种质量控制机制. 它扮演了一个"裁判的裁判"的角色. 其本质是对采样得到的多样性进行筛选和加权. 这使得推理时扩展的效率更高. 与其采样32次进行简单投票, 不如采样16次, 然后由Meta RM选出最好的8次进行投票, 效果可能更好, 而计算成本更低.
6. 小结
这篇文章介绍了第三代RLVR模型的训练过程, 在数学领域介绍了能够获得IMO金牌的 DeepSeek-Math-V2, 在编程竞赛领域介绍了能够获得IOI金牌的GENCLUSTER. 这两个例子作为RLVR的代表, 我们可以看到构建了一种新的“生成--验证”的模式. 当然还有一些其它很好的工作, 例如DeepMind AlphaGeometry & AlphaProof & AlphaEvolve & Athetia 等工作, 由于篇幅有限, 就没有介绍了. 然后我们再介绍了DeepSeek-GRM, 它是一种模型自己生成批判性思考的方法. 它将一个标准的LLM, 转化为一个能够进行结构化思考, 并且其思考深度可以随计算资源投入而增长的"通用评判专家". 这套方法论的核心, 是将"原则"作为连接模型内部思考过程与外部性能表现的桥梁, 并通过RL和推理时扩展, 将其潜力发挥到极致.
接下来, 在介绍第四代针对Agentic LLM强化学习任务之前, 我们将单独补一篇, 从工程的角度来详细分析一下DeepSeek-R1和DeepSeek-V3.2-Speciale的相关后训练流程.