本文篇幅较长, 其中有些公式推导难免会有一些错误, 欢迎大家指正
TL;DR
在介绍第四代Agentic LLM之前, 我们以DeepSeek为例详细介绍一下开源模型的后训练流程, 特别是《DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning》[1]在2026年1月更新了论文, 增加了很多工程上的细节, 非常值得再次详细学习. 另一方面我们还会详细介绍一下DeepSeek-V3.2的后训练过程, 并且详细分析一下Rollout Routing Replay(R3)相关的工作. 最后我们将详细谈谈 RL 中的 KL散度相关的问题.
本文目录如下:
1. DeepSeek-R1
1.1 Overview
1.2 DeepSeek-R1-Zero
1.2.1 训练算法
1.2.2 奖励设计
1.2.3 在LLM中激励推理能力
1.3 DeepSeek-R1
1.3.1 基于模型的奖励
1.3.2 训练细节
1.4 从R1-Zero到R1
1.4.1 RL 数据集
1.4.2 R1冷启动
1.4.3 第一阶段RL
1.4.4 第二阶段SFT
1.4.5 第二阶段RL
1.5 实验结果
2. DeepSeek-V3.2
2.1 专家蒸馏和混合RL训练
2.2 Scaling GRPO
3. R3:Rollout Routing Replay
3.1 为什么需要R3
3.2 训推不一致的问题
3.2.1 MoE中训推策略差异
3.2.2 MoE模型中训推路由差异
3.2.3 同一框架内对相同序列重复前向传播的差异
3.3 Rollout Routing Replay
3.3.1 实现
3.3.2 路由器掩码缓存与多轮对话支持
3.3.3 R3对训推差异的实证分析
4. 谈谈RL中的KL散度
4.1 什么是KL散度
4.2 KL散度的不对称性
4.3 如何选择Forward KL 和 Reverse KL
4.4 KL 估计器
4.5 KL惩罚的使用方式
4.5.1 KL的梯度
4.5.2 KL-in-Reward vs KL-in-Loss
4.5.3 不同KL估计器的区别
4.5.3.1 估计器的梯度
4.5.3.2 KL-in-Loss时的梯度分析
4.5.3.3 KL-in-Reward时的梯度分析
4.6 off-policy k3-in-loss1. DeepSeek-R1
1.1 Overview
传统大模型虽然在理解能力上突飞猛进, 但其推理能力的瓶颈在于它本质上是一个高级的词汇接龙游戏. 当遇到复杂的数理问题时, 依赖先验人类标注数据的监督学习 (SFT) 只能让模型学会形式上的正确, 而非逻辑上的严谨. 针对这一痛点, 本文的研究目的非常明确: 探索一条不依赖人类认知上限, 让模型自主进化出推理能力的道路.
作者采用的方法极致而纯粹: 放弃监督微调的捷径, 直接在预训练模型上应用基于结果的强化学习. 这种放养策略带来了一系列惊人的发现: 模型并非在瞎猜, 而是在试错中自发形成了类似人类的高阶认知行为 (如顿悟, 纠错). 其得出的核心数据与结论是: 纯强化学习训练的模型在数学, 代码等存在客观对错的标准任务上, 性能不仅超越了 SFT 模型, 甚至逼近了目前最顶尖的闭源模型.
作者在论文的第一章详细阐述了这个过程: DeepSeek旨在探索LLM在一个RL框架中通过自我演化发展推理能力的潜力, 并最大限度地减少对人类标注工作的依赖. 具体来说, 基于DeepSeek-V3-Base模型, 并采用 GRPO 作为 RL 框架. 奖励信号完全基于最终预测与标准答案的正确性, 而不对推理过程本身施加任何约束.
DeepSeek-R1-Zero
作者在RL训练前绕过了传统的监督式微调(SFT)阶段. 这一设计选择源于作者的假设: 人类定义的推理模式可能会限制模型的探索, 而不受限制的RL训练能更好地激励LLM中新颖推理能力的涌现. 基于这个假设使用纯 RL 训练的 DeepSeek-R1-Zero 自然地发展出了多样化且复杂的推理行为. 在解决推理问题时, 该模型表现出生成更长响应的趋势, 在每个响应中都包含了验证、反思以及对替代方法的探索. 尽管我们没有明确地教模型如何推理, 但它通过强化学习成功地学会了更优的推理策略.
DeepSeek-R1
尽管DeepSeek-R1-Zero展现出强大的推理能力, 但它也面临诸如可读性差和语言混用等挑战, 偶尔会在一个思维链响应中混合使用中英文. 此外, DeepSeek-R1-Zero的基于规则的RL训练阶段仅狭隘地专注于推理任务, 导致其在写作和开放域问答等更广泛领域的性能受限. 为应对这些挑战, 作者推出了DeepSeek-R1, 这是一个通过多阶段学习框架训练的模型, 该框架整合了拒绝采样、强化学习和监督式微调. 这个训练流程使DeepSeek-R1能够继承其前身DeepSeek-R1-Zero的推理能力, 同时通过额外的非推理数据使其行为与人类偏好对齐.
1.2 DeepSeek-R1-Zero
1.2.1 训练算法
R1-Zero基于 GRPO 算法进行 RL 训练, 它直接从DeepSeek-V3 Base开始训练, 没有经过任何SFT. 对于每个问题 , GRPO 从旧策略 中采样一组输出 , 然后通过最大化以下目标函数来优化策略模型 :
其中 是一个参考策略, 和 是超参数, 而 是优势(advantage), 它是使用每组输出对应的奖励 计算得出的:
注: 关于GRPO和PPO的比较在RL102已经有较详细的叙述了. 后面会单独再写一篇对比GRPO的各种变体.
R1-Zero 学习率设置为3e-6, KL系数设置为0.001, rollout采样温度设置为1, 这样能够得到更多样化的输出. 对于每个问题, 在8.2k步之前采样16个输出, 最大长度为32,768个token, 在此之后最大长度为65,536个token.因此R1-Zero的性能和响应长度在8.2k步时都表现出显著的跃升. 训练总共持续了10,400步, 相当于1.6个epoch.
每次训练step包含32个独立的问题, 每个问题16个采样输出, 因此单个训练batch=512. 作者每400步就将参考模型替换为最新的策略模型. 为了加速训练, 每个rollout过程生成8,192个输出, 这些输出被随机分成16个mini-batch, 并且只进行一个inner epoch的训练.
R1-Zero训练过程中的Template如下, <think> </think>标签内包含了推理过程, <answer> </answer>标签包含了答案.prompt将在训练期间被具体的推理问题替换.
1.2.2 奖励设计
R1-Zero采用基于规则的奖励, 为数学、编程和逻辑推理领域的数据提供精确的反馈. 我们基于规则的奖励系统主要由两种类型的奖励组成: 准确率奖励和格式奖励.
- 准确率奖励评估响应是否正确. 例如, 对于具有确定性结果的数学问题, 模型被要求以指定格式(例如, 在一个方框内)提供最终答案, 从而可以通过基于规则的方式可靠地验证其正确性. 类似地, 对于代码竞赛的提示, 可以利用编译器根据一套预定义的测试用例来评估模型的响应, 从而生成关于正确性的客观反馈.
- 格式奖励通过强制执行特定的格式要求来补充准确率奖励模型. 具体而言, 模型被激励将其推理过程封装在指定的标签内, 特别是
<think>’和</think>. 这确保了模型的思考过程被明确地勾画出来, 从而增强了可解释性并便于后续分析.
准确率奖励和格式奖励以相同的权重组合. 值得注意的是, 作者没有对推理任务应用神经奖励模型: 无论是基于结果(ORM)的还是基于过程(PRM)的. 这个决定是基于作者的观察: 神经奖励模型在大规模强化学习期间容易受到reward hacking. 此外, 重新训练这类模型需要大量的计算资源, 并给训练流程带来了额外的复杂性, 从而使整个优化过程变得复杂.
1.2.3 在LLM中激励推理能力
作者在DeepSeek-V3基础模型上应用RL技术来训练DeepSeek-R1-Zero. 在训练期间, 设计了一个直观的模板, 要求DeepSeek-R1-Zero首先产出推理过程, 然后再给出最终答案. 作者有意将约束限制在这种结构化格式上, 避免任何特定内容的偏见, 以确保能够准确地观察模型在RL过程中的自然演进.
如下左图描绘了DeepSeek-R1-Zero在整个RL训练过程中于AIME 2024基准测试上的性能轨迹, 其在AIME 2024上的平均pass@1得分显示出显著增长, 从最初的15.6%跃升至77.9%. 此外, 通过利用自洽性解码 模型的性能可以得到进一步提升, 达到86.7%的准确率. 这一性能显著超过了所有人类参赛者的平均水平. 除了数学竞赛, DeepSeek-R1-Zero在编程竞赛以及研究生水平的生物、物理和化学问题上也取得了卓越的性能. 这些结果凸显了RL在增强大型语言模型推理能力方面的有效性.
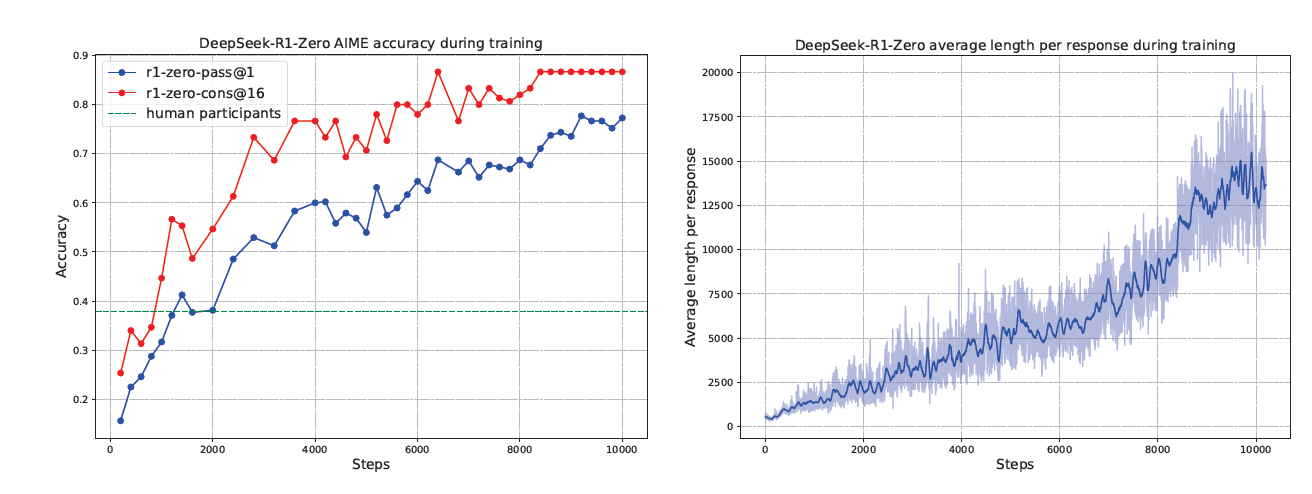
DeepSeek-R1-Zero的自我进化例证了RL如何能够自主地增强模型的推理能力. 如上右图所示, DeepSeek-R1-Zero在整个训练过程中的思考时间表现出稳步增长, 这完全是由内在适应而非外部修改所驱动的. 利用长思维链, 模型逐步完善其推理, 生成成百上千的token来探索和改进其解决问题的策略.
思考时间的增加促进了复杂行为的自主发展. 具体而言, DeepSeek-R1-Zero越来越多地展现出高级推理策略, 例如反思性推理和对替代方案的系统性探索(如下左图所示).
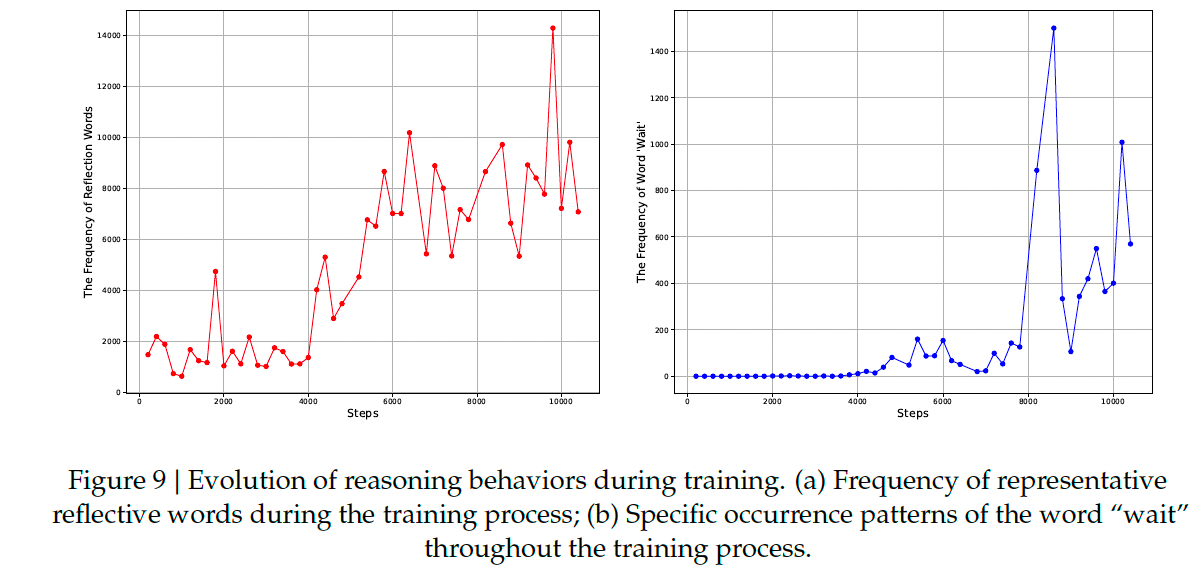
这极大地提升了它在数学和编程等可验证任务上的性能. 值得注意的是, 在训练期间, DeepSeek-R1-Zero展现出一次“aha moment”(如下图所示), 其特征是在反思过程中“wait” 一词的使用突然增加(如上图(b)所示). 这个时刻标志着推理模式的明显转变, 并清晰地展示了DeepSeek-R1-Zero的自我进化过程.
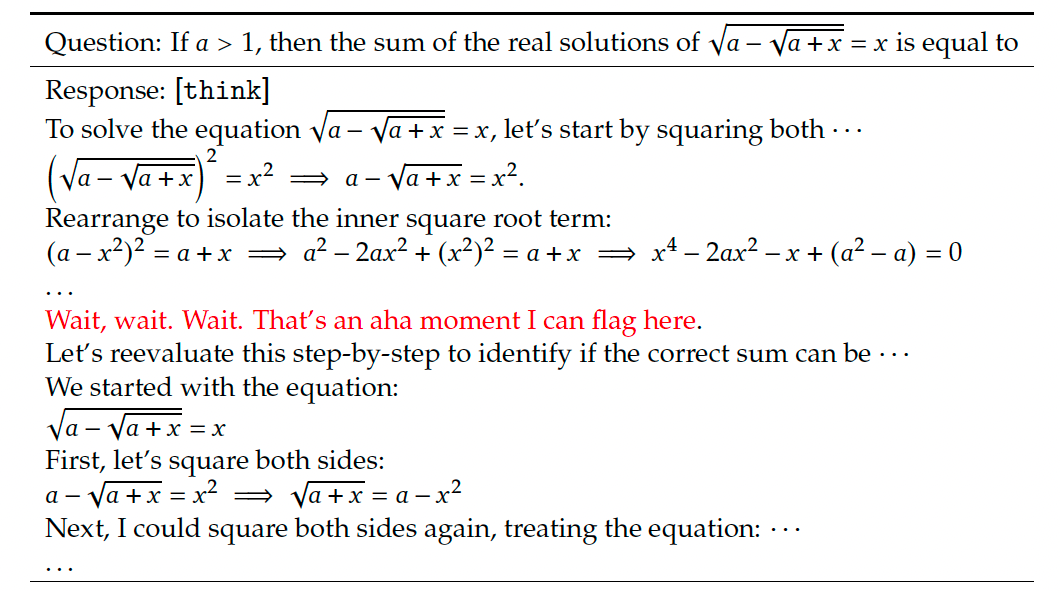
DeepSeek-R1-Zero的自我进化凸显了RL的力量与美感: 作者并非明确地教模型如何解决问题, 而只是为它提供了正确的激励, 它便自主地发展出高级的解题策略. 这提醒我们RL在解锁LLM更高层次能力方面的潜力, 为未来更自主、更具适应性的模型铺平了道路.
1.3 DeepSeek-R1
尽管DeepSeek-R1-Zero展现出强大的推理能力, 但它面临着几个问题. DeepSeek-R1-Zero在可读性差和语言混用等挑战上挣扎, 因为DeepSeek-V3-Base是在多种语言(特别是英语和中文)上训练的. 为了解决这些问题, 作者开发了DeepSeek-R1, 其流程如图所示.
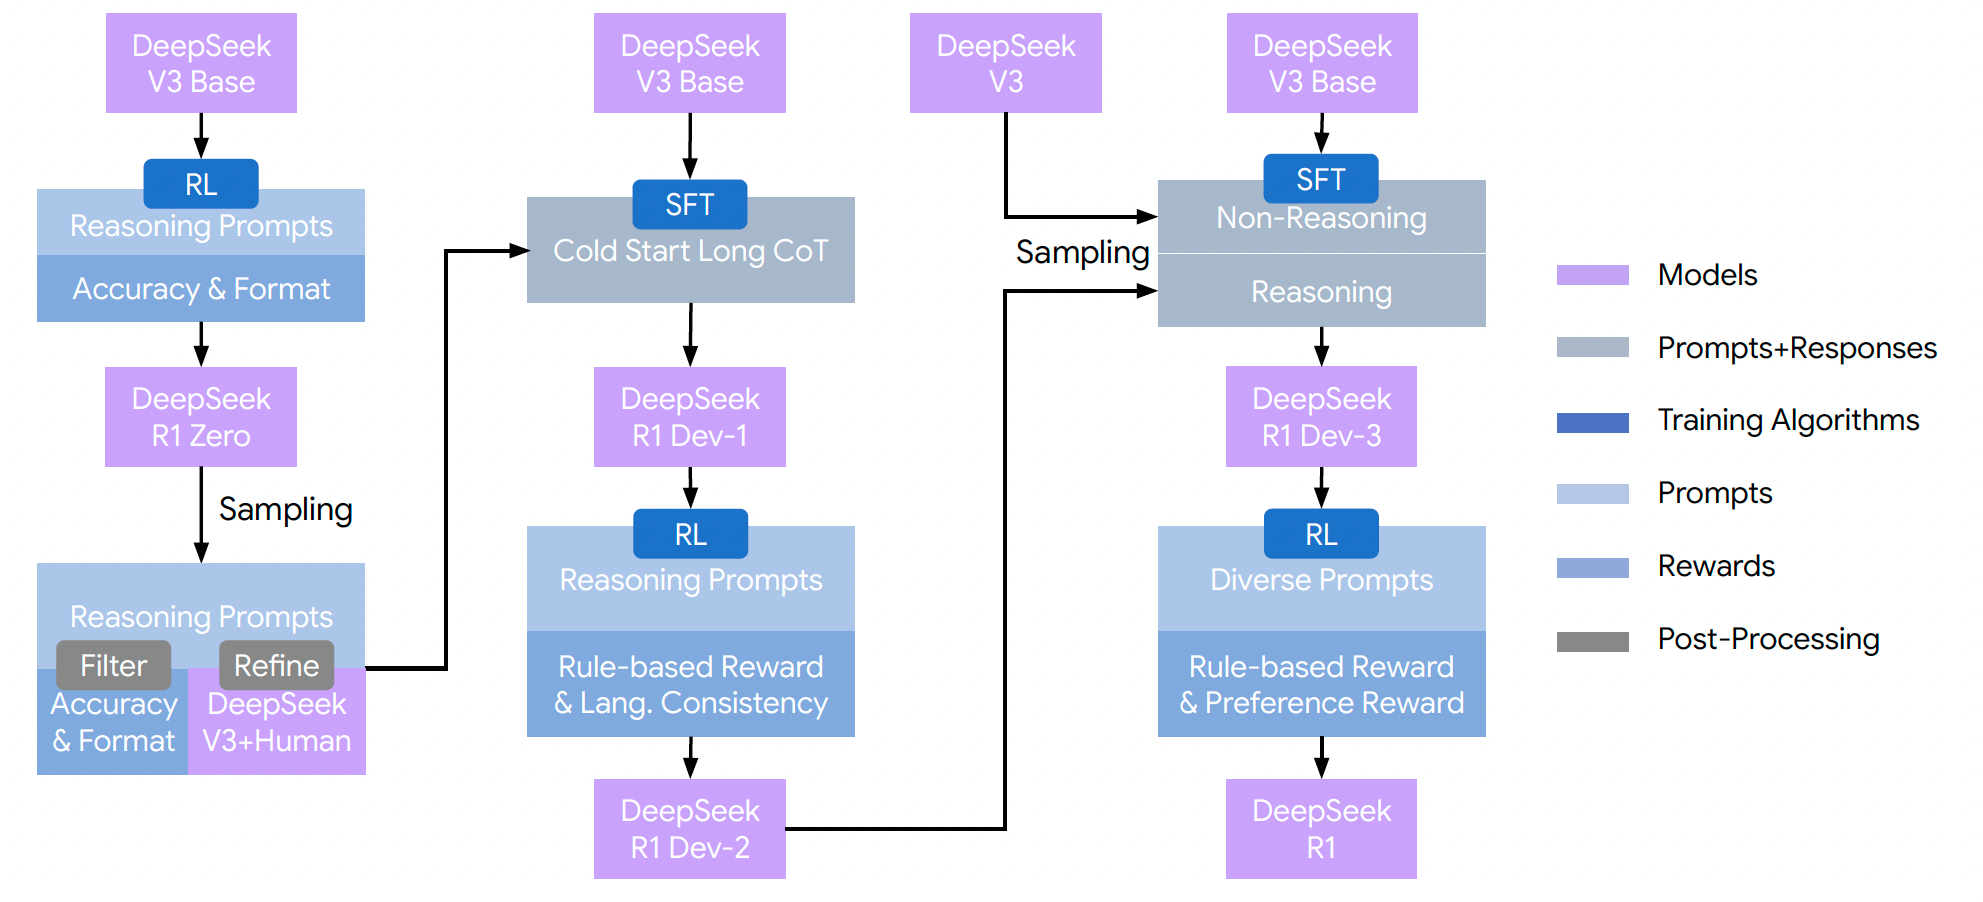
在初始阶段, 收集了数千条展现出对话式、符合人类偏好的思维过程的冷启动数据. 然后应用RL训练来提高模型在对话式思维过程和语言一致性方面的性能. 随后, 再次应用拒绝采样和SFT. 这一阶段将推理和非推理数据集都纳入SFT过程, 使模型不仅能在推理任务上表现出色, 还能展示出色的写作能力. 为了进一步使模型与人类偏好对齐, 然后实施了第二个RL阶段, 旨在增强模型的有用性和无害性, 同时进一步完善其推理能力.
1.3.1 基于模型的奖励
RM关注三个方面:
- 对于通用数据, 借助奖励模型来捕捉复杂和细微场景中的人类偏好. 作者基于DeepSeek-V3的流程, 并采用了类似的偏好对和训练提示分布.
- 对于有用性, 只关注最终的摘要, 确保评估强调响应对用户的效用和相关性, 同时最大限度地减少对底层推理过程的干扰.
- 对于无害性, 评估模型的整个响应, 包括推理过程和摘要, 以识别和减轻在生成过程中可能出现的任何潜在风险、偏见或有害内容.
有用性奖励模型 (Helpful Reward Model)
关于有用性奖励模型的训练, 我们首先使用arena-hard提示格式提示DeepSeek-V3来生成偏好对, 每对包含一个用户查询和两个候选响应.
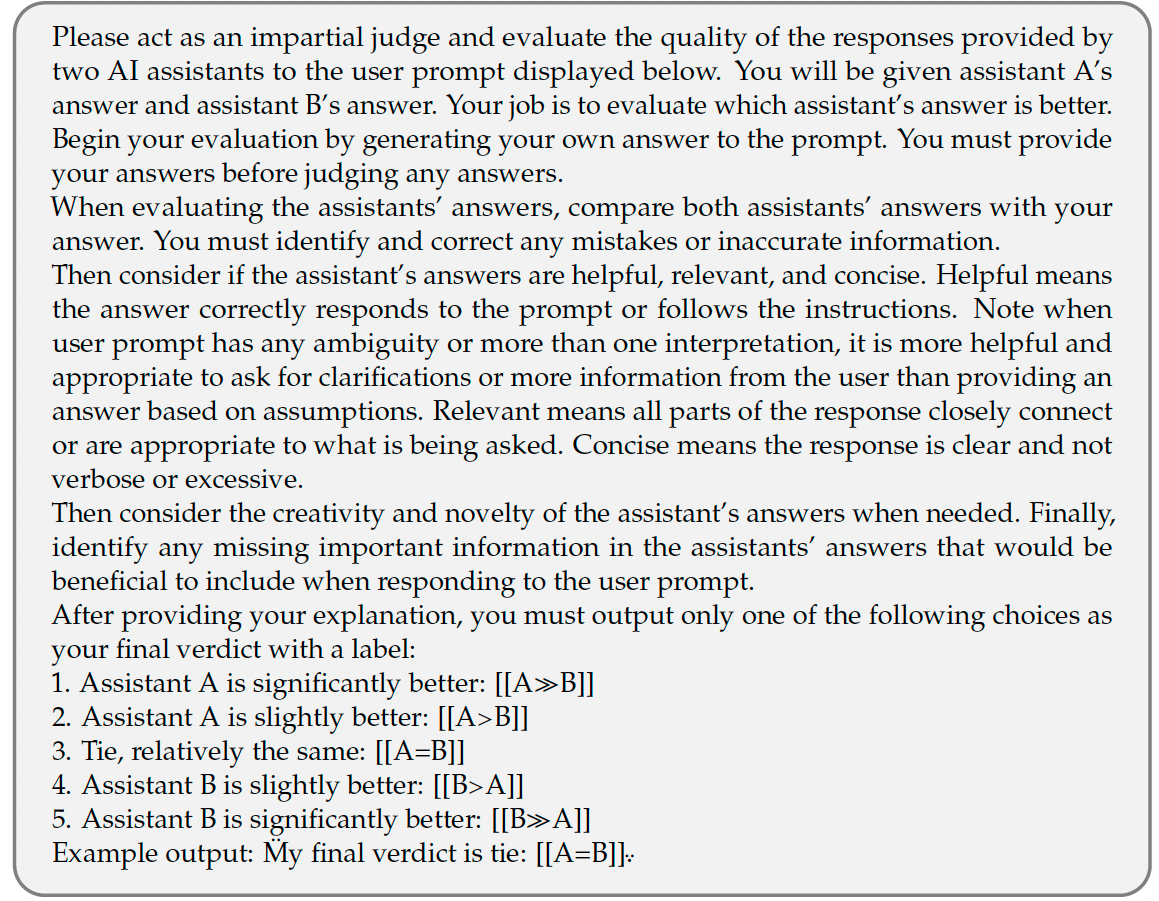
对于每个偏好对, 查询DeepSeek-V3四次, 并采用随机分配响应为响应A或响应B以减轻位置偏见. 最终的偏好得分由四次独立判断的平均值决定, 只保留那些得分差异超过1的配对以确保有意义的区分. 此外, 为了最小化与长度相关的偏见, 确保整个数据集中被选择和被拒绝的响应具有相当的长度. DeepSeek团队总共整理了66,000个数据对用于训练奖励模型. 该数据集中使用的提示都是非推理问题, 来是公开可用的开源数据集或已明确同意分享其数据以用于模型改进的用户.
另外奖励模型的架构与DeepSeek-R1一致, 只是增加了一个奖励头来预测标量偏好分数.
有用性奖励模型使用BatchSize=256、6e-6的学习率进行训练, 并在训练数据集上训练一个epoch. 训练期间的最大序列长度设置为8192个token, 而在奖励模型推理期间没有施加明确的限制.
安全奖励模型 (Safety Reward Model)
为了评估和提高模型安全性, 作者整理了一个包含106,000个提示的数据集, 其中模型生成的响应根据预定义的安全指南被标注为"安全"或"不安全". 与有用性奖励模型中采用的成对损失不同, 安全奖励模型使用逐点(point-wise)方法进行训练, 以区分安全和不安全的响应. 训练超参数与有用性奖励模型相同.
对于通用查询, 每个实例被分类为属于安全数据集或有用性数据集. 分配给每个查询的通用奖励对应于相关数据集中定义的相应奖励.
1.3.2 训练细节
第一阶段RL的训练细节
在第一阶段RL中, 将学习率设置为3e-6, KL系数设置为0.001, GRPO裁剪率设置为10, rollout的采样温度设置为1. 对于每个问题, 采样16个最长为32,768的输出. 每个训练步包含32个独立问题, 从而使训练批大小达到每步512. 每400步用最新的策略模型替换参考模型.
为了加速训练, 每个rollout生成8,192个输出, 这些输出被随机分成16个小批次, 并且只进行一个inner epoch的训练. 然而, 为了缓解语言混用问题, 在RL训练期间引入了语言一致性奖励, 计算方式为目标语言词汇在CoT中所占的比例.
尽管消融实验表明, 这种对齐会导致模型性能轻微下降, 但这种奖励符合人类偏好, 使其更具可读性. 通过直接将其添加到最终奖励中, 将语言一致性奖励应用于推理和非推理数据.
请注意, 裁剪率在训练中起着至关重要的作用. 较低的值可能导致大量token的梯度被截断, 从而降低模型性能, 而较高的值可能导致训练过程中的不稳定.
第二阶段RL的训练细节
作者使用奖励信号和多样化提示分布的组合来训练模型. 对于推理数据, 遵循DeepSeek-R1-Zero中概述的方法, 该方法采用基于规则的奖励来指导数学、编程和逻辑推理领域的学习.
在训练过程中, 作者观察到CoT经常表现出语言混用, 特别是当RL提示涉及多种语言时.
对于通用数据, 利用奖励模型来指导训练. 最终, 奖励信号与多样化数据分布的整合使DeepSeek团队能够开发出一个不仅在推理方面表现出色, 而且优先考虑有用性和无害性的模型.
给定一批数据, 奖励可以表示为:
其中,
第二阶段RL保留了第一阶段的大部分参数, 主要区别是降低了温度至0.7, 因为作者发现此阶段较高的温度会导致不连贯的生成. 该阶段总共包含1,700个训练步, 其中通用指令数据和基于偏好的奖励仅在最后的400步中被引入. 这是因为作者发现, 使用基于模型的偏好奖励信号进行更多训练步骤可能会导致Reward Hacking.
1.4 从R1-Zero到R1
首先对于CoT的生成, 作者利用了纯RL的方法进行探索, 构建了R1-Zero的模型. R1-Zero虽然是个解题天才, 但就像一个不修边幅、满嘴行话的怪人, 你很难和他正常交流. 他说话乱七八糟, 经常中英文混着说. 如何把这个"怪才"培养成一个成熟、稳重、善于沟通的"全能选手"DeepSeek-R1 ? 整个培养过程分为精心设计的几个步骤, 就像一个复杂的教育流程:
接下来我们详细来阐述这个训练流程.
1.4.1 RL 数据集
用于Reasoning的RL数据包括四类: 数学, 编程, STEM (科学, 技术, 工程, 数学) 和逻辑问题. 此外, 作者还加入了通用的 RL 数据, 以在 DeepSeek-R1 的训练中提升模型的帮助性和无害性. 所有问题都是中文或英文.
| 数据类型 | # Prompts (问题数量) |
问题类型 | 输出类型 | RL奖励 | 奖励机制 |
|---|---|---|---|---|---|
| Math (数学) | 26K | 定量推理 | 数字/表达式/方程 | 答案匹配 | Rule-Based |
| Code (编程) | 17K | 算法和 Bug 修复 | 代码解决方案 | 代码执行/单元测试 | Rule-Based |
| STEM (科学) | 22K | 多项选择 | 选项 | 选项匹配 | Rule-Based |
| Logic (逻辑) | 15K | 选择/定量推理 | 选项/数字 | 答案 | Rule-Based |
| General (通用) | 66K | 帮助性/无害性 | 排序的响应 | 偏好排序 | Model Based |
数学数据集
包含 2.6 万个定量推理问题, 包括数学考试题和竞赛题. 平均 prompt token 数为 122. 数据集涵盖代数, 微积分, 概率和几何等多个数学领域. 问题难度从地区竞赛到国际奥林匹克不等. 对于每个问题, 模型被期望生成一个逐步的推理过程, 最终得到一个最终答案, 这个答案可以是一个数值(如, "5"), 一个数学表达式(如, ""), 或一个方程(如, ""). 数学证明被排除在外, 因为很难确定其正确性. 在RL中, 作者通过将预测答案与参考答案匹配来计算推理过程的奖励. 如果答案与参考答案一致, 奖励被赋值为 1; 否则为 0.
编程数据集
包括 1.7 万个算法竞赛问题, 以及 8 千个 bug 修复问题. 算法竞赛问题类似于 Codeforces 或 LeetCode 等平台上的问题. 每个问题通常包括详细的问题描述, 约束条件和多个输入输出示例. 任务是编写一个完整的函数或程序, 能够正确高效地解决问题, 通过一套全面的隐藏测试用例, 这些用例评估正确性和性能. 这些问题测试算法技能, 包括动态规划, 图论, 字符串操作和数据结构使用. bug 修复问题从真实的 GitHub issue 中提取. 每个任务提供一个 issue 描述, 一个有 bug 的源代码版本, 以及一组部分或完全失败的单元测试. 目标是理解 issue 的意图, 定位并修复代码中的缺陷, 并确保修正后的版本通过所有单元测试.
STEM 数据集
包含 2.2 万个选择题, 涵盖物理, 化学和生物等主题. STEM 任务中的每个问题都呈现一个特定学科的问题, 并附有四到八个答案选项. 模型需要根据给定的上下文和领域知识选择最科学准确的答案. 平均 prompt token 数为 161. 具体来说, 数据集包括 15.5% 的物理, 30.7% 的生物, 46.5% 的化学, 以及 7.3% 的其他主题, 如健康和医学. 由于所有 STEM 问题都是多选题, 根据是否匹配正确选项分配一个二元奖励.
逻辑数据集
包含 1.5 万个问题, 旨在评估模型在广泛逻辑挑战中的推理能力. 数据集包括真实世界和人工生成的问题. 所有问题都支持自动评估, 平均 prompt 长度约为 420 token. 数据集的真实世界部分包括从网络上搜集的多种问题, 包括脑筋急转弯, 经典逻辑谜题和知识密集型问题. 这些问题以多选题形式呈现, 以确保客观和一致的评估. 人工生成部分主要包括两类: code-IO问题和谜题任务. code-IO 问题使用 《CodeI/O: Condensing Reasoning Patterns via Code Input-Output Prediction》[2] 介绍的数据流水线生成, 它将编程竞赛问题及其对应的输入输出测试用例转换为可验证的逻辑推理问题. 谜题任务包括旨在评估特定推理能力的问题. 例如, 密码学谜题旨在评估模型识别和应用密码方案模式或执行字符串操作的能力; 逻辑谜题关注在复杂约束下的演绎推理, 如从一组固定的前提推断出有效结论; 算术谜题测试模型的数值推理能力.
通用数据集
包含 6.6 万个旨在评估帮助性的问题, 涵盖创意写作, 编辑, 事实性问答和角色扮演等各种类别. 此外, 数据集还包括 1.2 万个专注于评估无害性的问题. 为确保可靠的验证, 使用了两个奖励模型, 每个模型都在与帮助性和无害性相关的模型生成的 ranked responses 的精选数据集上进行训练. 作者用最大序列长度为 8192 token 对帮助性奖励模型训练了一个 epoch. 然而, 在部署模型生成奖励信号时, 作者没有对被评估的输入序列施加任何明确的长度限制.
1.4.2 R1冷启动
作者明确指出, 这个步骤是 "产品驱动" 的, 旨在提升用户体验. 他们观察到 R1-Zero 的输出虽然在逻辑上强大, 但在表达上 (如人称使用, 语言一致性) 不符合人类习惯. 例如一个表达混乱但正确的答案, 会给用户带来巨大的认知负荷. 用户需要花费额外精力去理解模型的思路, 甚至翻译混杂的语言. 这违背了 AI 作为 "助手" 的初衷. 因此, 对表达风格进行对齐, 本质上是在优化人机交互的效率.
具体来说, 纯粹的 RL (如 R1-Zero 的训练) 可能会探索到一些在性能上极佳但行为上 "怪异" 的策略空间. 直接将这样的模型呈现给用户是有风险的. "冷启动 SFT" 相当于在 RL 开始前, 给策略空间施加了一个强烈的先验 (prior). 它告诉模型: "请在这个人类偏好的风格区域内开始你的探索". 这有助于引导后续 RL 的探索方向, 加速收敛, 并降低生成不可接受内容的风险.
当然, 作者坦诚地指出了 "可能引起用户不应有的信任". 这是一个非常负责任的声明. 当模型使用 "我" 来叙述时, 它极大地增强了拟人化程度, 用户可能无意识地赋予其过高的信任度. 这种风格对齐是一把双刃剑, 在提升体验的同时, 也带来了潜在的伦理问题和用户教育的挑战. 因此有了一个声明: “我们想强调的是, 观察到的生动推理模式主要反映了 DeepSeek 工程化的启发式方法, 而不是表明该模型已内在地获得了类似人类的智能或自主解决问题的能力.“
整个R1冷启动过程如下所示:
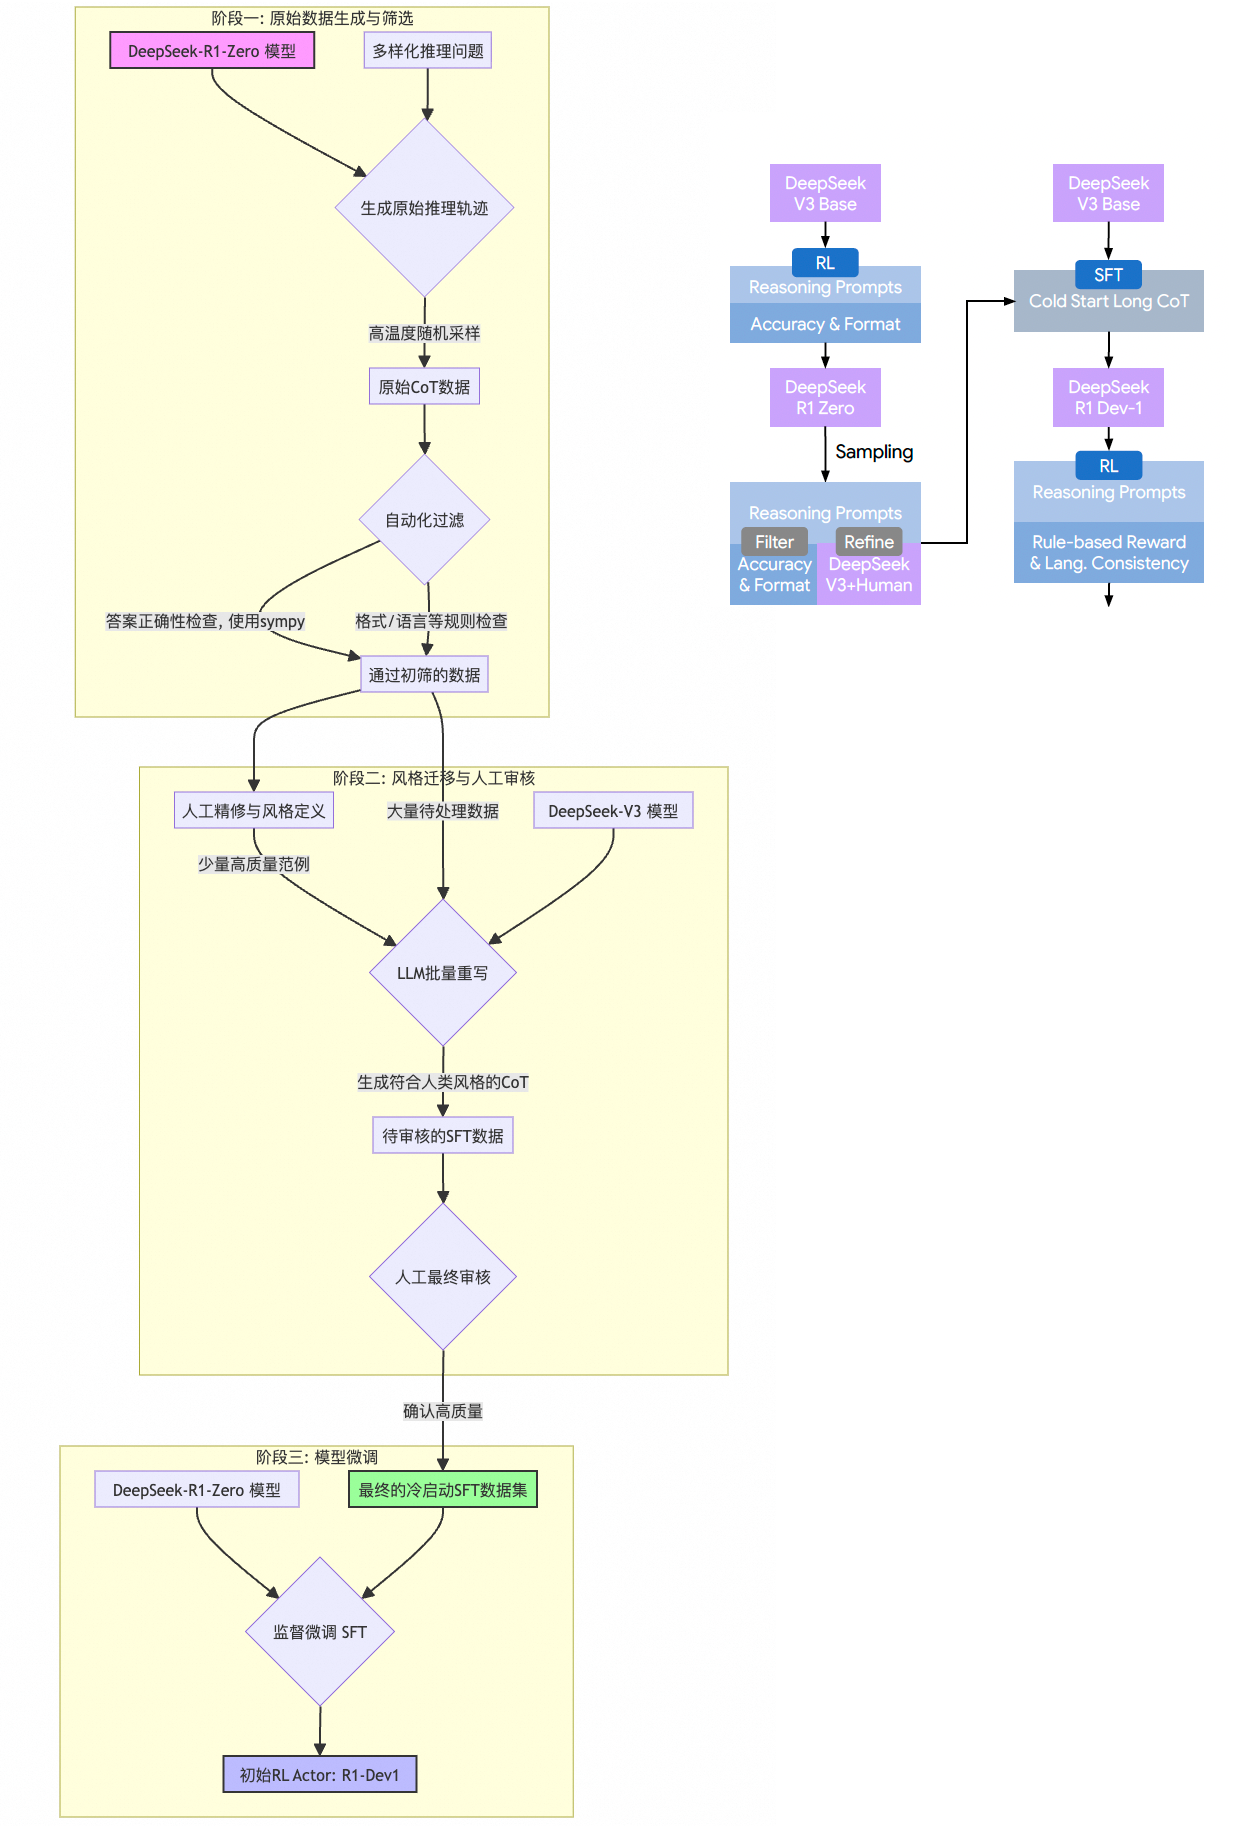
首先收集数千个高质量, 多样化的推理提示. 对于每个提示, 使用 DeepSeek-R1-Zero 在较高的温度 1.0 下生成多个推理轨迹. 接下来, 筛选这些生成内容, 只保留那些最终答案正确且格式可读的. 对于数学输出, 使用 sympy 进行解析和表达式比较; 对于格式, 应用诸如重复检测和语言混合过滤等规则. 最后, 通过提示 DeepSeek-V3 来提炼推理过程和摘要, 以确保格式正确和表达方式对人类友好. 特别是, 为了解决语言混合问题, 作者指示 DeepSeek-V3 "将思维过程翻译成与问题相同的语言". 由于 DeepSeek-R1-Zero 的摘要只提供了最终答案, 作者使用如下的摘要Prompt来生成一个简洁的, 人类可读的解决方案, 该方案概述了推理步骤和最终结果.
## Question
{question}
## Thought process
{thought_process}
---
Based on the above thought process, provide a clear, easy-to-follow, and well-formatted solution to the question. Use the same language as the question.
The solution must strictly follow these requirements:
- Stay faithful and consistent with the given thought process. Do not add new reasoning steps or conclusions not shown in the original.
- Show key steps leading to final answer(s) in clear, well-formatted LaTeX.
- Use \boxed{} for final answer(s).
- Be clean and concise. Avoid colloquial language. Do not use phrases like "thought process" in the solution.
Your response should start with the solution right away, and do not include anything else. Your task is solely to write the solution based on the provided thought process. Do not try to solve the question yourself.对于代码数据, 收集了大量的编程竞赛问题. 具体来说, 从多个在线评测 (OJ) 平台汇编了大量编程竞赛问题, 特别是来自 Codeforces 的 5151 个问题和来自 AtCoder 的 2504 个问题. 由于这些平台的原始测试用例不公开, 作者开发了一种方法来为每个问题创建可靠的测试用例.
DeepSeek的方法涉及使用 DeepSeek-V2.5 生成候选测试用例, 随后进行严格的验证过程. 具体来说, 提示 DeepSeek-V2.5 编写 Python 程序来生成针对每个问题需求的测试用例, 如 Listing 2 所示.
<USER>
Question:
You are given a string word and an integer k.
A substring s of word is complete if:
Each character in s occurs exactly k times.
The difference between two adjacent characters is at most 2. That is, for any two
adjacent characters c1 and c2 in s, the absolute difference in their positions in
the alphabet is at most 2.
Return the number of complete substrings of word.
A substring is a non-empty contiguous sequence of characters in a string.
**Input**
The first line contains a single integer t the number of test cases.
The first line of each test case contain one string word.
The second line of each test case contain one integer k.
It is guaranteed that word consists only of lowercase English letters, and the sum of |
word| over all test cases does not exceed 10^5.
**Output**
For each test case, print one integer the number of complete substrings of word.
**Example**
Input
‘‘‘
2
igigee
2
aaabbbccc
3
‘‘‘
Output
‘‘‘
36
‘‘‘
Construct some random input generators to generate diverse and adversarial inputs,
which are large enough to to make incorrect codes exceed the time limit.
</USER>
<ASSISTANT>
First construct a random input generator for large data with 10 testcases of the same
length.
‘‘‘python
import random
import string
def generate_random_string(l_min, l_max):
length = random.randint(l_min, l_max)
seq = ’’.join(random.choices(string.ascii_lowercase, k=length))
k = random.randint(1, length)
return f"{{seq}}\n{{k}}"
t = 10 # the number of test cases
testcase = [generate_random_string(10000, 10000) for _ in range(t)]
print(t)
print("\n".join(testcase))
‘‘‘
First construct a random input generator for large data with 10 testcases of different
length.
‘‘‘python
import random
import string
def generate_random_string(l_min, l_max):
length = random.randint(l_min, l_max)
seq = ’’.join(random.choices(string.ascii_lowercase, k=length))
k = random.randint(1, length)
return f"{{seq}}\n{{k}}", len(seq)
t = 10 # the number of test cases
testcase = []
cum_length = 0
for i in range(t):
# each test case should have length >= 1
cur_testcase, cur_length = generate_random_string(1, 100000 - cum_length - (t -i))
testcase.append(cur_testcase)
cum_length += cur_length
print(t)
print("\n".join(testcase))
‘‘‘
Construct a random input generator for large data with only one test case.
‘‘‘python
import random
import string
def generate_random_string(l_min, l_max):
...
t = 1 # the number of test cases
testcase = [generate_random_string(90000, 100000) for _ in range(t)]
print(t)
print("\n".join(testcase))
‘‘‘
Construct an input generator for large adversarial inputs of a string of a repeated
single character.
‘‘‘python
import random
import string
def generate_single_repeated_char(l_min, l_max):
length = random.randint(l_min, l_max)
char = random.choice(string.ascii_lowercase)
seq = char * length
k = random.randint(1, length)
return f"{{seq}}\n{{k}}"
t = 1 # the number of test cases
testcase = [generate_single_repeated_char(90000, 100000) for _ in range(t)]
print(t)
print("\n".join(testcase))
‘‘‘
Construct an input generator for large adversarial inputs of a string of two
alternating characters.
‘‘‘python
import random
import string
def generate_alternating_chars(l_min, l_max):
length = random.randint(l_min, l_max)
char1, char2 = random.sample(string.ascii_lowercase, 2)
seq = ’’.join(char1 if i % 2 == 0 else char2 for i in range(length))
k = random.randint(1, length)
return f"{{seq}}\n{{k}}"
t = 1 # the number of test cases
testcase = [generate_alternating_chars(90000, 100000) for _ in range(t)]
print(t)
print("\n".join(testcase))
‘‘‘
Construct an input generator for large adversarial inputs of a string of sequential
characters from alphabet.
‘‘‘python
...
‘‘‘
</ASSISTANT>
Question:
Question Description
Construct some random input generators to generate large, diverse and adversarial
inputs, which are large enough to testing time complexity and to make incorrect
codes exceed the time limit.
Use the format used in the above example by returning several input generators in
different code blocks. Each of these generators prints EXACTLY ONE input directly
into stdout.在获得了大量候选测试用例后, 实施了一个两阶段的过滤程序. 首先使用正确的提交来消除那些产生不正确输出的无效测试用例. 然后, 策略性地选择那些能成功识别不正确提交中缺陷的测试用例子集. 这个过程确保了最终的测试用例能够正确区分每个问题的正确和不正确解决方案.
此外, 作者对 DeepSeek-V3 采用 few-shot 提示来为简单的数学问题 (如 "1 + 1 = ?") 生成响应, 确保输出保持简洁和结构得当. 在 Listing 3 中提供了简单数学问题的Prompt.
## Question
How much is 5+4?
## Response
<think>
I need to add the numbers 5 and 4. Starting with 5, if I add 4 to it, the total will be
9. Therefore, the sum of 5 and 4 is 9.
</think>
**Solution:**
We are asked to calculate the sum of 5 and 4.
**Step 1:** Start with the number 5.
**Step 2:** Add 4 to it.
\[
5 + 4 = 9
\]
**Final Answer:** \(\boxed{9}\)
---
## Question
what is 1 plus 2
## Response
<think>
I need to determine the sum of 1 and 2.
Adding these two numbers together, 1 plus 2 equals 3.
Therefore, the answer is 3.
</think>
Sure! Let’s solve the problem step by step.
**Problem:** What is \(1 + 2\)?
**Solution:**
To find the sum of 1 and 2, simply add the two numbers together:
\[
1 + 2 = 3
\]
**Answer:**
\(\boxed{3}\)
---
## Question
{question}
## Response1.4.3 第一阶段RL
经过R1-Zero冷启动的Dev-1 可以被看作一个已经掌握了"如何优雅地表达思考过程"但其"内在推理能力"尚未得到强化的初始 actor 模型. 它的推理水平大致与 V3-Base 相当, 此时作者进行了第一阶段的强化学习. 这个 RL 阶段的目标不是从零开始学习推理, 而是将在 R1-Zero 身上验证成功的方法, 应用于已经具备良好风格的 Dev-1 模型上. 同时针对中英文等语言混杂的问题进行处理.
主要数据集应该是采用了1.4.1节描述的推理数据集进行GRPO, 同时采用Rule-Based Reward和Language Consistency Reward. 通过RL训练得到了DeepSeek-R1-Dev2.
1.4.4 第二阶段SFT
R1-Dev2它是 Dev-1 经过推理任务强化学习后的产物, 具备以下特点:
- 强大的推理能力: 继承了 R1-Zero 的核心优势, 在数学, 编程等领域表现出色.
- 优秀的表达风格: 继承了
Dev-1的优势, 输出是第一人称, 语言纯净, 结构清晰. - 潜在的"偏科"问题: 由于之前的训练 (
Dev-1的 SFT 和到Dev-2的 RL) 都高度集中在推理类任务上,Dev-2在处理非推理类的通用任务(如创意写作, 角色扮演等)时, 能力可能相对不足, 甚至不如那些专门做通用对话对齐的模型(比如 DeepSeek-V3).
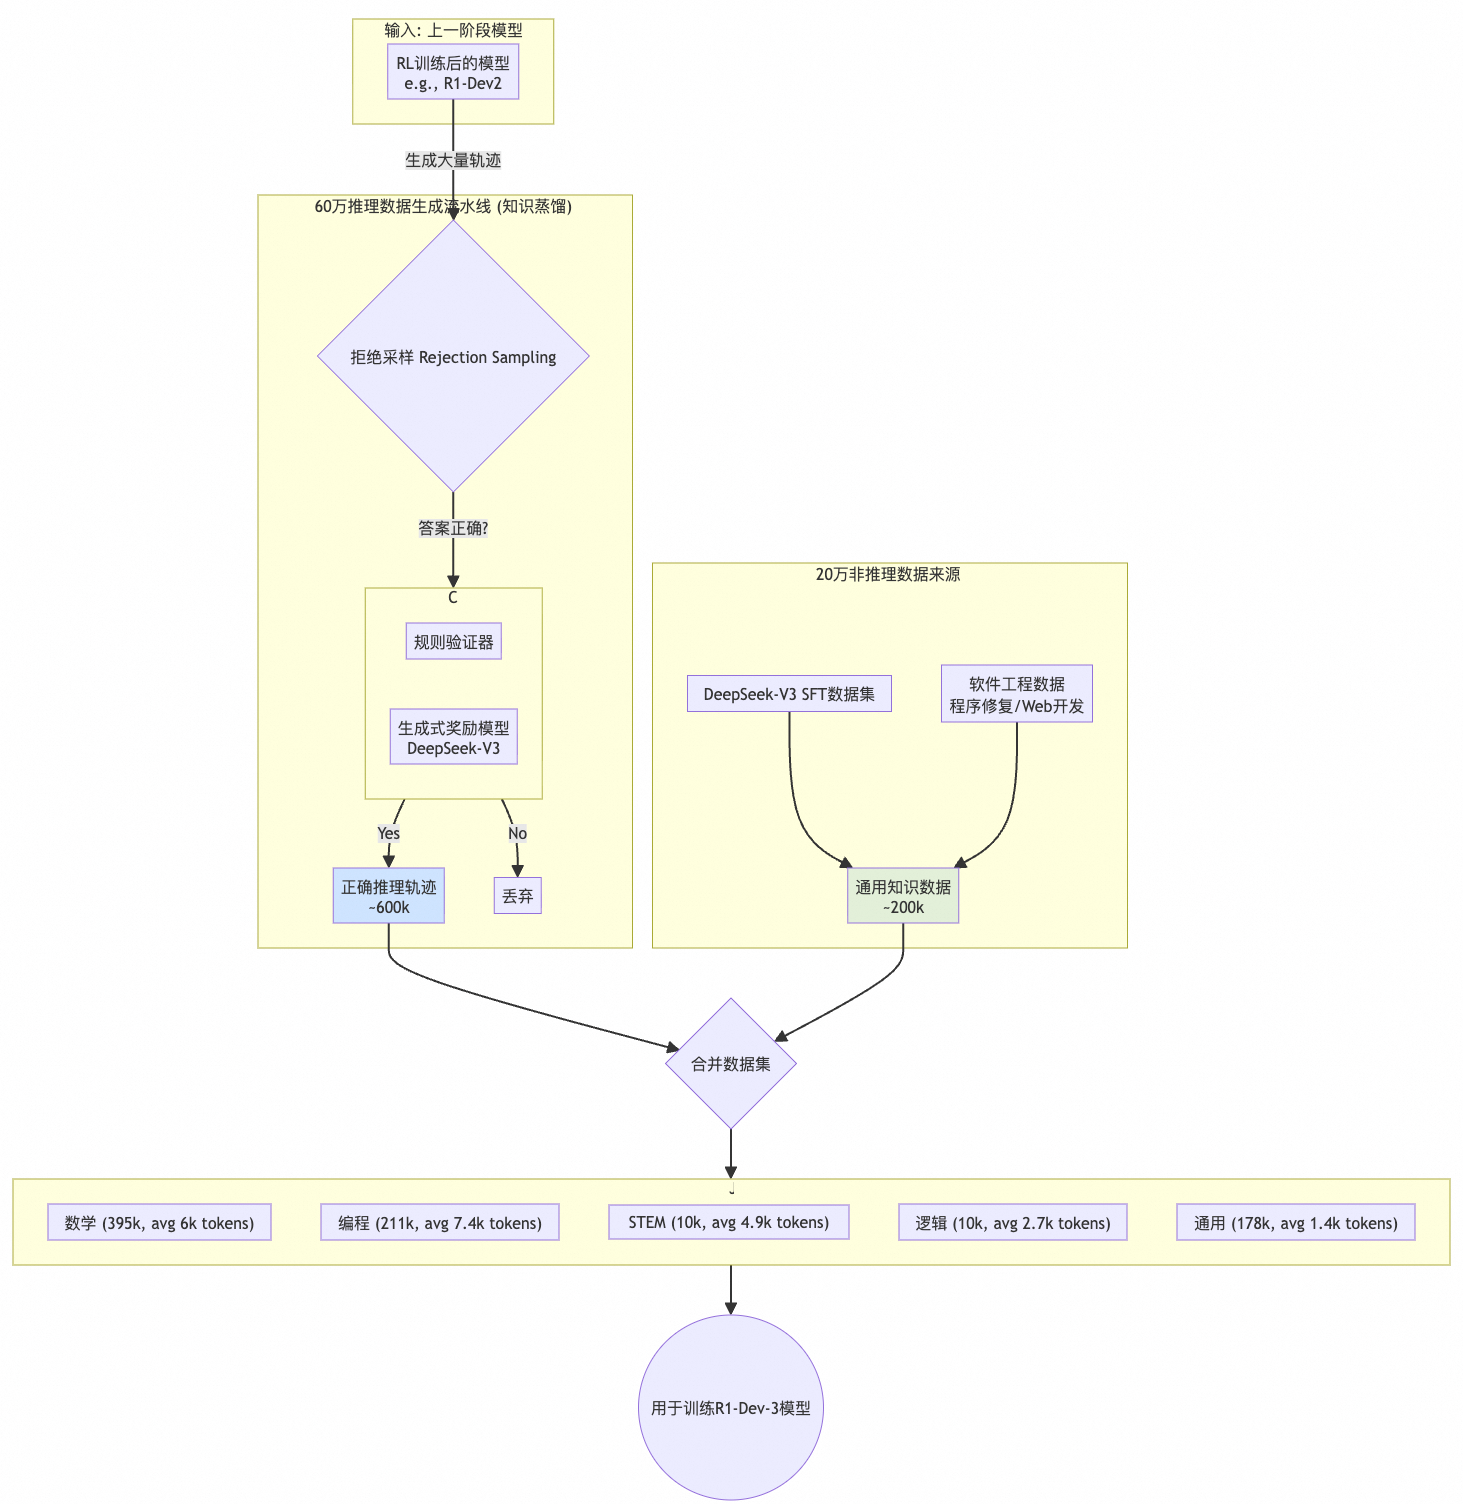
因此Dev-3 的生成目标非常明确: 在不显著损害其强大推理能力的前提下, 大规模地注入通用知识和技能, 提升其在非推理任务上的表现, 使其成为一个更全面, 更"博学"的模型.为了实现这个目标, 作者选择了 SFT (Supervised Fine-Tuning) 作为核心方法.
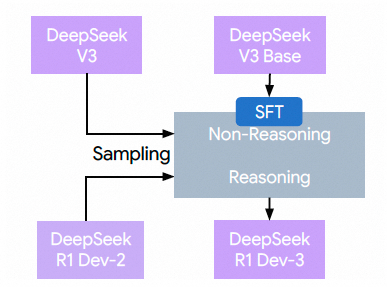
整个SFT的数据在论文原文的附录B.3.3中详细介绍, 整个SFT数据有800K.
用于Reasoning的数据
通过构建大量的Reasoning prompt, 并通过对第一阶段 RL 训练的 checkpoint Dev-2 进行拒绝采样 来生成推理轨迹. 在前一阶段, 只包含了可以用基于规则的奖励来评估的数据. 然而, 在这个阶段, 通过加入额外的数据来扩展数据集, 其中一些数据使用了生成式奖励模型 (generative reward model), 即将真实答案和模型预测输入到 DeepSeek-V3 中进行判断, 示例 prompt 如下. 此外, 由于模型输出有时混乱且难以阅读, 所以过滤掉了混合语言, 长段落和代码块的思想链. 对每个 prompt, 采样多个响应, 并只保留正确的. 总共收集了约 60 万个与推理相关的训练样本.
As an advanced reasoning problem evaluation assistant, your primary responsibility is
to assess the accuracy of provided answers. You will be presented with a reasoningrelated
question, its corresponding reference answer, and an answer requiring
evaluation.
## Answer Quality Classification
You have to carefully analyze and classify the answer into one of the following two
levels:
1. **correct**: The answer fully aligns with the reference answer in both reasoning
process and final conclusion, and address the question without any errors or
omissions.
2. **incorrect**: The answer contains major errors in key reasoning steps or the final
conclusion, or completely deviates from the core of the question. This indicates a
fundamental misunderstanding or error in comprehending the question.
## Question
{question}
## Reference Answer
{reference}
## Answer to be Evaluated
{answer}
## Output Format
You need to combine the question and reference answer, first provide a detailed
explanation of your analysis of the answer to be evaluated, then conclude with the
final answer quality classification.
Output the following content in **JSON** format, including two key:
1. ’analysis’: analysis of the answer’s correctness;
2. ’correctness’: correct/incorrect这段是一个使用 DeepSeek-V3 作为裁判来判断答案正确性的 Prompt 示例, 其核心是要求裁判模型将待评估答案与标准答案对比, 给出'analysis'或'correctness'的 JSON 格式结论.
非Reasoning数据
对于非推理数据, 如写作, 事实性问答, 自我认知和翻译, 采用了 DeepSeek-V3 的流水线, 并重用了 DeepSeek-V3 的部分 SFT 数据集. 同时还加入了以软件工程为中心的数据, 包括程序修复和前端 Web 开发, 以增强模型解决现实世界问题的能力. 对于某些非推理任务, 作者通过 prompting 调用 DeepSeek-V3 在回答问题前生成一个潜在的思想链. 然而, 对于更简单的查询, 如"你好", 不在响应中提供 CoT. 最后, 收集了总共约 20 万个与推理无关的训练样本.
在设计思维过程风格时, 作者要求模型遵循几个关键原则:
- 保持每个段落简洁易懂. 短段落使思想更清晰, 更易于遵循.
- 采用一种感觉自然且引人入胜的对话语气. 避免使用 markdown 等技术格式来保持流畅的阅读体验.
- 也是最重要的, 思维过程始于理解完整的用户上下文. 这意味着分析用户是谁, 他们正在处理什么情况, 以及他们真正需要什么——包括那些可能隐藏在他们初始请求表面之下的未言明的需求.
在从模型中引出这些思维过程后, 人类标注员会仔细验证输出的准确性. 作者的发现表明, 这些人工推理轨迹增强了模型在解释用户查询时的精确度. 具体来说, 它们有效地突出了格式约束, 澄清了用户意图, 并阐明了所需的输出结构. 这种方法促进了模型和用户之间更准确和响应更灵敏的交互.
最终SFT的数据构成如下:
| Domain (领域) | Num Samples (样本数) | Avg Rounds (平均轮次) | Avg Tokens (平均长度) |
|---|---|---|---|
| Math (数学) | 395,285 | 1.0 | 6094.2 |
| Code (编程) | 211,129 | 1.1 | 7435.7 |
| STEM (科学) | 10,124 | 1.0 | 4928.8 |
| Logic (逻辑) | 10,395 | 1.0 | 2739.0 |
| General (通用) | 177,812 | 1.1 | 1419.8 |
| Total (总计) | 804,745 | 1.0 | 5355.3 |
其中, 数学相关的数据主要以中文和英文为主, 涵盖了广泛的主题和难度级别. 这些问题是可验证的, 可以通过确定性规则或参照特定的标准答案来判断. 编程数据集不仅包含算法竞赛问题, 还包含调试任务和面向项目的编程查询.STEM (科学, 技术, 工程, 数学) 和逻辑相关的问题, 尽管在数量上少于数学和编程, 但其来源是公开可用的教科书和在线知识库. 通用领域的查询是多种多样的, 主要以中文和英文为主, 包括创意写作, 开放式问答, 角色扮演场景等任务.
值得注意的是, 大部分数据由单轮交互组成, 这可能会限制 DeepSeek-R1 的多轮对话能力. 作者将扩展到多轮对话数据作为未来的工作.
1.4.5 第二阶段RL
我们来详细剖析从 DeepSeek-R1-Dev3 到最终 DeepSeek-R1 的这最后一步强化学习训练. 其核心目标是最终的用户对齐 (Final User Alignment), 将一个能力全面但可能还略显"生硬"的技术模型, 打磨成一个在与用户交互时表现得既聪明又有帮助的成熟产品.
首先, Dev-3 是一个已经非常强大的模型, 具备以下特点:
- 强大的推理内核: 经过了 RL 阶段
Dev-2和 SFT 巩固Dev-3, 其在数学, 编程等领域的推理能力已经接近顶峰. - 广泛的通用知识: 通过 800K 数据的 SFT, 它已经学习了大量的非推理知识和技能.
- 潜在的对齐不足: 尽管能力很强, 但它主要通过 SFT 来与人类偏好对齐. SFT 只能保证它"知道"什么是好的回答, 但不一定能保证它在自由生成时"总是倾向于"给出最好的回答. 它在细微的表达, 语气, 帮助性等方面可能还有提升空间, 这在 AlpacaEval 和 ArenaHard 等主观评测指标上可以体现出来 (
Dev-3在这两项上得分尚可, 但远未到顶尖).
这个最终 RL 阶段的目标, 不是像之前那样进行大规模的能力获取或知识注入, 而是进行精细的微调和打磨, 核心是让模型的行为最大程度地符合人类的综合偏好. 具体可以分解为三个子目标:
- 提升帮助性 (Helpfulness): 让模型在回答开放性问题时, 变得更贴心, 周到, 真正解决用户的潜在需求.
- 保证无害性 (Harmlessness): 进一步加固模型的安全护栏, 确保其不会产生有害或不当内容.
- 保持并微调推理能力: 在进行上述对齐的同时, 确保其顶尖的推理能力不发生退化, 甚至在对齐过程中得到进一步的协同提升.
为了同时实现这三个目标, 作者设计了一套混合奖励机制, 并将其应用于 GRPO 强化学习框架中. 这意味着在同一个 batch 中, 可能包含来自不同领域的 prompt, 并且它们会使用不同的奖励函数. 我们可以将总奖励分解:
需要注意的是, 这一步采样的温度降低到了0.7, 降低温度意味着模型的生成更趋于确定性, 更少地进行天马行空的探索. 这是合理的, 因为这个阶段的目标是精细微调而不是大规模探索 (exploration). 过高的温度可能导致生成不连贯或低质量的内容.
另一方面只在最后的 400 步加入了通用指令数据和偏好奖励, 主要是防止Reward Hacking. 他们采取了非常谨慎的策略, 只在训练的最后阶段"点到为止", 在模型学会"作弊"前就完成训练.
1.5 实验结果
作者在一系列基准测试上评估模型:
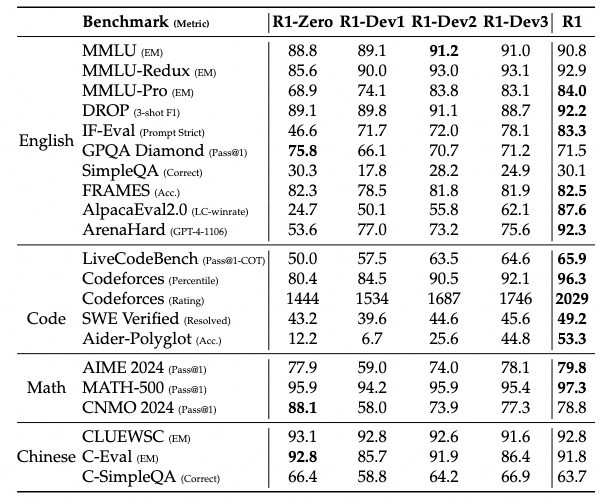
R1-Zero 和 Dev1之间的比较揭示了在指令遵循能力上的显著提升, 这由 IF-Eval 和 ArenaHard 基准测试上的更高分数所证明. 然而, 由于冷启动数据集的规模有限, 与 R1-Zero 相比, Dev1 在推理性能上表现出部分退化, 最明显的是在 AIME 基准测试上.
相比之下, Dev2 在需要高级推理技能的基准测试上表现出显著的性能增强, 包括那些专注于代码生成, 数学问题解决和 STEM 相关任务的基准. 而针对通用任务的基准, 如 AlpacaEval 2.0, 则显示出边际提升. 这些结果表明, 以推理为导向的 RL 极大地增强了推理能力, 同时对以用户偏好为导向的基准影响有限.
Dev3 将推理和非推理数据集都整合到 SFT (监督微调) 流水线中, 从而增强了模型在推理和通用语言生成任务上的熟练度. 与 Dev2 相比, Dev3 在 AlpacaEval 2.0 和 Aider-Polyglot 上取得了显著的性能提升, 这归功于大规模非推理语料库和代码工程数据集的加入.
最后, 在 Dev3 上使用混合了以推理为中心和通用目的的数据进行全面的 RL 训练, 产生了最终的 DeepSeek-R1. 在代码和数学基准上的提升是边际的, 因为大量的针对性推理 RL 在之前的阶段已经完成. 最终 DeepSeek-R1 的主要进步在于通用指令遵循和用户偏好基准, 其中 AlpacaEval 2.0 提升了 25%, ArenaHard 提升了 17%.
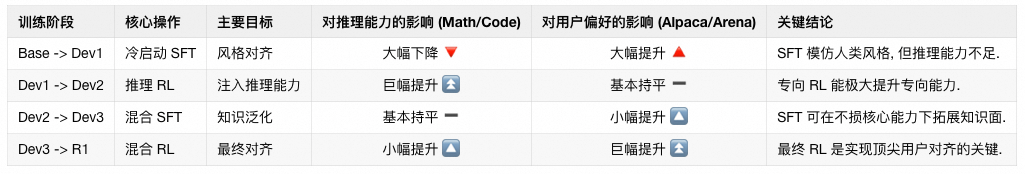
我们可以创建一个表格, 将每个训练阶段与其在关键能力维度上的主要影响进行映射, 这能更清晰地展现整个演进逻辑.
2. DeepSeek-V3.2
接下来我们来分析一下《DeepSeek-V3.2-Exp》[3]和《DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models》[4]的后训练过程.
DeepSeek-V3.2 采用了Scaling GRPO算法, 通过实施稳健的强化学习并扩展后训练阶段的计算资源,DeepSeek-V3.2 的性能已能与 GPT-5 媲美. 值得特别指出的是, 我们的高计算量变体模型 DeepSeek-V3.2-Speciale 不仅超越了 GPT-5,更展现出与 Gemini-3.0-Pro 相媲美的推理能力, 在 2025 年国际数学奥林匹克竞赛(IMO)和国际信息学奥林匹克竞赛(IOI)中均斩获金牌水平成绩. 另一方面, 它也为第四代Agentic LLM做了很多准备, 将推理能力整合到工具使用场景中, 并开发了一种新型合成流水线, 能够系统化地大规模生成训练数据. 这一方法论推动了可扩展的智能体后训练, 在复杂交互环境中显著提升了泛化能力和指令遵循的稳健性.
2.1 专家蒸馏和混合RL训练
在DeepSeek-V3.1开始, 模型支持了混合推理架构:一个模型同时支持思考模式与非思考模式. 后训练方式也有所不同.
专家蒸馏 (Specialist Distillation): 对于每项任务, 首先开发一个专门针对该特定领域的专业模型, 所有专业模型都从同一个预训练的 DeepSeek-V3.2 基础检查点进行微调. 除了写作任务和通用问答, 框架还涵盖了六个专业领域: 数学、编程、通用逻辑推理、通用智能体任务、智能体编码和智能体搜索, 所有领域都支持思考(thinking)和非思考(non-thinking)两种模式. 每个专家模型都通过大规模的强化学习(RL)计算进行训练. 此外, DeepSeek团队采用不同的模型来为长思维链推理(思考模式)和直接响应生成(non-thinking模式)生成训练数据. 一旦专家模型准备就绪, 它们就被用来为最终的检查点生产特定领域的数据. 实验结果表明, 在蒸馏数据上训练的模型的性能水平仅略低于领域专属的专家模型, 并且通过后续的 RL 训练, 这种性能差距被有效消除.
混合RL训练(Mixed RL Training: 与之前DeepSeek模型采用多阶段强化学习不同, 将推理, Agent和人类对齐训练合并到了一个RL阶段. 这种方法有效地平衡了不同领域间的性能, 同时规避了多阶段训练范式中常见的灾难性遗忘问题. 对于推理和Agent任务, 采用了基于规则的结果奖励, 长度惩罚和语言一致性奖励. 对于通用任务, 采用了一个生成式奖励模型(是否就是DeepSeek-GRM?), 其中每个提示都有其自己的评估标准. 在DeepSeek-3.2-Exp中还额外提到了奖励设计精心平衡了两个关键的权衡: (1) 长度与准确性, (2) 语言一致性与准确性.
DeepSeek-V3.2 和 DeepSeek-V3.2-Speciale DeepSeek-V3.2 整合了从专家模型蒸馏出的推理、智能体和人类对齐数据, 经过数千步的持续 RL 训练, 达到最终的检查点. 为了探索扩展思维的潜力, 还开发了一个实验性变体, DeepSeek-V3.2-Speciale. 该模型在 RL 期间专门使用推理数据进行训练, 并降低了长度惩罚. 此外, 整合了来自 DeepSeekMath-V2 的数据集和奖励方法, 以增强其在数学证明方面的能力.
2.2 Scaling GRPO
首先回顾 GRPO 的目标. GRPO 通过在给定每个问题 的情况下, 对从旧策略 采样的一组响应 最大化以下目标来优化策略模型 :
其中
是当前策略和旧策略之间的重要性采样率. 和 是分别控制裁剪范围和 KL 惩罚强度的超参数. 是 的优势(advantage), 它是通过在每个组内对结果奖励(outcome reward)进行归一化来估计的. 具体来说, 一组奖励模型被用来为组中的每个输出 评分一个结果奖励 , 从而分别产生 个奖励 . 的优势是通过从输出 的奖励中减去组的平均奖励来计算的, 即, .
然而进行大规模RL训练的瓶颈不仅仅是算法本身, 更多是系统与算法交互中产生的工程问题, 有些涉及到模型结构, 例如MoE模型上Routing带来的问题, 有些涉及到工程上, 例如训练推理框架不一致带来的误差等. 下面是作者列举的几个问题和解决方案:
无偏 KL 估计 (Unbiased KL Estimate)
给定 是从旧策略 中采样的, 作者修正了 K3 估计器以获得一个无偏的 KL 估计, 使用当前策略 和旧策略 之间的重要性采样率.
作为此调整的直接结果, 该 KL 估计器的梯度变得无偏, 这消除了系统性估计误差, 从而促进了稳定的收敛. 这与原始的 K3 估计器形成鲜明对比, 特别是当采样到的 token 在当前策略下的概率远低于参考策略时, 即 . 在这种情况下, K3 估计器的梯度会分配不成比例的、无界的权重来最大化这些 token 的似然, 导致梯度更新充满噪声, 这些噪声累积起来会在后续迭代中降低样本质量并导致不稳定的训练动态. 在实践中, 作者发现不同领域受益于不同强度的 KL 正则化. 对于某些领域, 如数学, 应用相对较弱的 KL 惩罚甚至完全省略它可以产生更好的性能.
Off-Policy Sequence Masking
为了提高 RL 系统的效率, 通常会生成一大批 rollout 数据, 然后将其分割成多个小批量进行数个梯度的更新步骤. 这种做法内生地引入了off-policy行为. 此外, 用于高效数据生成的推理框架通常是高度优化的, 这可能与训练框架在实现细节上有所不同. 这种训练-推理的不一致性进一步加剧了Off-Policy的程度. 为了稳定训练并提高对 Off-policy 更新的容忍度, 作者掩盖了那些引入显著策略分歧的负面序列, 分歧由数据采样策略 和当前策略 之间的 KL 散度来衡量. 更具体地说, 我们在 GRPO 损失中引入一个二元掩码 :
其中
且 是一个控制策略分歧阈值的超参数. 请注意, 这里的 表示由推理框架直接返回的采样概率, 因此旧策略和当前策略之间的 KL 散度考虑了上述两种 Off-policy 性的来源. 同样值得注意的是, 我们只掩盖具有负优势的序列. 直观地说, 模型从自身的错误中学习获益最大, 而高度 Off-policy 的负面样本可能是有害的, 可能会误导或破坏优化过程的稳定性. 我们凭经验观察到, 这种 Off-policy 序列掩码操作在某些原本会表现出不稳定性的训练场景中提高了稳定性.
Keep Routing
MoE模型通过在推理过程中仅激活一部分专家模块来提高计算效率. 然而, 推理和训练框架之间的差异, 加上策略更新, 可能导致即使对于相同的输入, 在推理和训练期间的专家路由也不一致. 这种不一致性会引起活动参数子空间的突然变化, 从而破坏优化稳定性并加剧离策略问题. 为了缓解这个问题, 作者保留了在推理框架中采样时使用的专家路由路径, 并在训练期间强制使用相同的路由路径, 确保相同的专家参数得到优化. "保持路由"操作被发现对 MoE 模型的 RL 训练稳定性至关重要, 并且自 DeepSeek-V3-0324 版本以来已在DeepSeek的 RL 训练流水线中采用.
Keep Sampling Mask
Top-p 和 top-k 采样是广泛使用的采样策略, 用于增强 LLM 生成响应的质量. 在 RL 训练中采用这些策略也是有利的, 因为它避免了采样那些将被用作优化目标的极低概率 token. 虽然这种截断保留了样本质量, 但它在 和 的动作空间之间引入了不匹配, 这违反了重要性采样的原则并破坏了训练的稳定性. 为了解决这个问题, 作者在从 采样期间保留截断掩码, 并在训练期间将其应用于 , 确保两个策略共享相同的动作子空间. 根据经验, 我们发现将 top-p 采样与"保持采样掩码"策略相结合, 能在 RL 训练期间有效地保持语言的一致性.
3. R3:Rollout Routing Replay
我们注意到在DeepSeek-V3.2的论文中提到, 关于训推一致和Keep Routing的工作已经在V3-0324的版本以来就采用了. 而公开的比较详细的一篇论文是来自Mimo的《Stabilizing MoE Reinforcement Learning by Aligning Training and Inference Routers》[5], 接下来我们将基于这篇文章详细介绍关于MoE模型进行大规模RL训练.
3.1 为什么需要R3
在基于大语言模型的强化学习中, 一个关键的挑战是平衡效率和稳定性, 而后者对于可靠的性能至关重要. 现代的强化学习框架通常为推理和训练阶段采用不同的引擎. 例如, 用于生成数据(rollout)的SGLang和用于训练的Megatron. 这种架构上的分离可能导致token概率的发散, 潜在地引发强化学习崩溃. 虽然有一些工作, 例如ThinkingMachine的《Defeating Nondeterminism in LLM Inference》[6]可以缓解一些差异. 但是针对MoE模型的RL还有一些问题, 具体来说路由分布(routing distribution)是导致MoE强化学习不稳定的一个关键因素. 在MoE模型内部, 路由器为每个输入token动态地选择并激活一部分专家. 这种多变的路由决策导致MoE模型在训练和推理之间的策略差异比其对应的稠密模型更大.
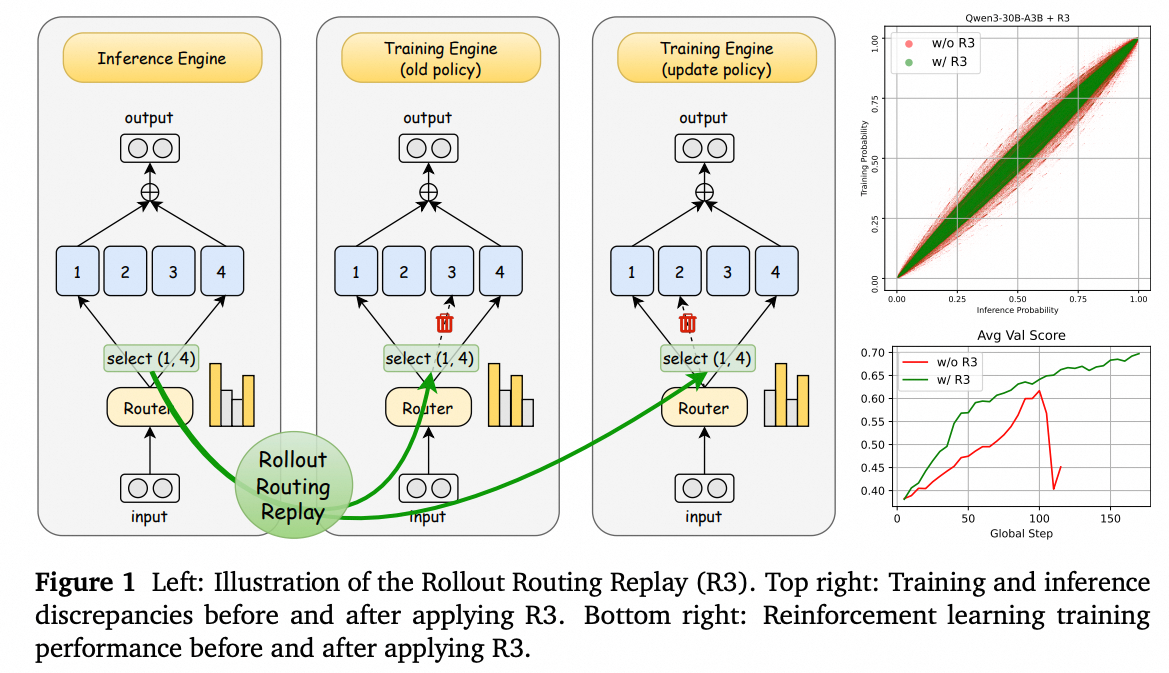
因此基于Rollout Routing Replay(R3)是一种简单而有效的方法, 用于稳定MoE模型的强化学习训练. R3的工作方式是, 在序列生成过程中从推理引擎捕获路由分布, 并将它们直接“回放”到训练引擎中. 这个过程显著地缩小了训练和推理之间的差距, 其标志是不同引擎产生的logits的KL散度大幅降低. 结果, 两个阶段之间存在显著概率差异的token数量减少了大约一个数量级.
3.2 训推不一致的问题
3.2.1 MoE中训推策略差异
基于MoE模型 Qwen3-30B-A3B 分析训练和推理引擎之间的策略差异. 首先, 作者使用SGLang推理引擎为2,048个数学问题生成响应, 并保存每个生成token的token概率. 这个过程产生了大约2000万个响应token. 然后, 这些响应被传递给Megatron, 以获得训练引擎分配的相应概率. 作者使用几个指标来量化这两种概率分布之间的差异.
KL散度估计 设 为所有响应token的集合, 我们使用Schulman (2020)中提出的 方法来估计训练和推理概率分布之间的KL散度:
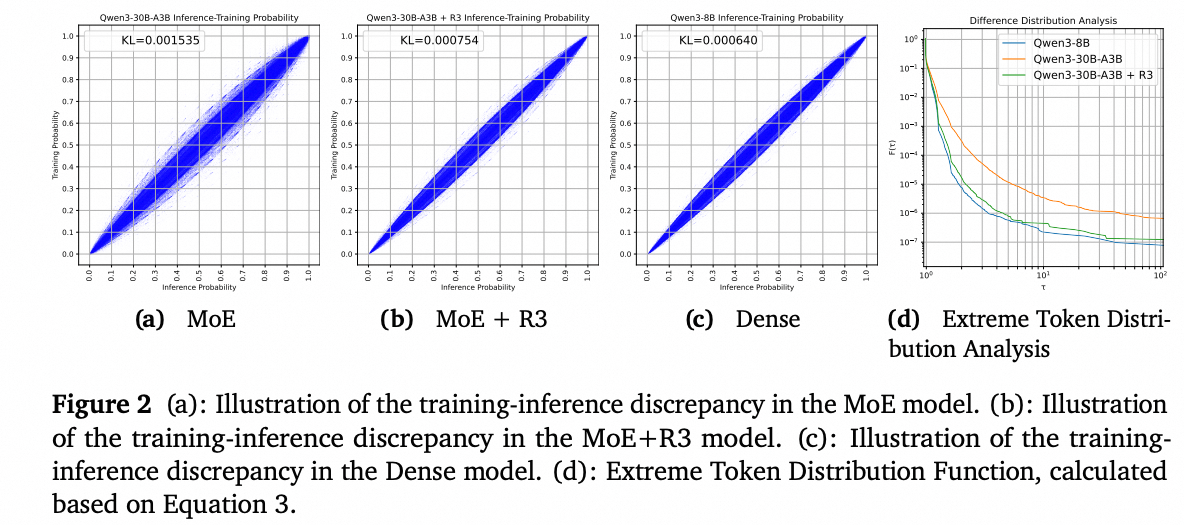
计算显示, Qwen3-30B-A3B (MoE)的估计KL散度为 , 而Qwen3-8B (稠密模型基线)的KL散度为 .
可视化
为了可视化MoE模型的训练-推理差异, 随机采样了1000万个响应token, 并绘制了一个散点图, x轴为SGLang的概率, y轴为Megatron的概率. 图点围绕 直线的集中程度表明了一致性的程度. 如图2a和2c所示, 与Qwen3-8B相比, Qwen3-30B-A3B展现出一个宽得多的散点带, 揭示了更大的训练-推理差异.
极端Token分布分析
为了量化模型在训练和推理期间行为的差异, 引入了极端Token分布函数(Extreme Token Distribution Function), , 定义为:
该函数测量了极端token的比例: 即那些训练分布 和推理分布 之间的概率比率超过阈值 的token. 图2d绘制了该函数 随阈值 变化的曲线. 该图揭示了, 对于 , Qwen3-30B-A3B模型展现出的极端token比例比Qwen3-8B模型大了一个数量级. 这一显著差距表明MoE模型中存在高得多的训推不一致的情况.
3.2.2 MoE模型中训推路由差异
从函数连续性的角度来看, MoE和稠密模型之间的关键区别在于路由引入的非连续性. 在MoE模型中, 路由器输入的微小扰动可能导致选择完全不同的专家, 从而引起层输出的巨大变化. 稠密模型由于没有明确的专家选择过程, 不会表现出这种现象.
基于此, 进一步分析了MoE模型中训练和推理之间的路由分布差异. 我们使用SGLang为2048个数学问题使用Qwen3-30B-A3B 生成响应. 对于每个响应, 我们从推理引擎收集所有token(包括输入token)的路由分布. 然后, 将这些序列输入到Megatron引擎进行前向传播. 这个过程产生了从训练引擎观察到的路由分布. 作者在不同层面上比较这两组路由信息:
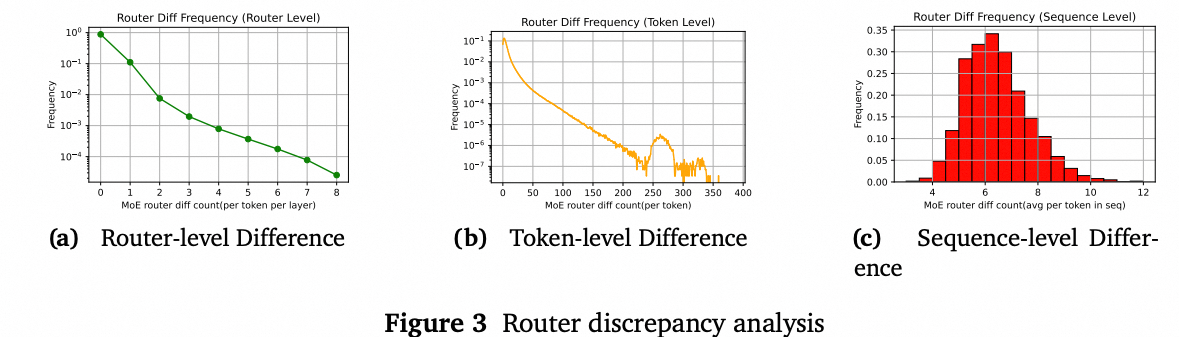
- Router层面比较: 对于每个token和每个MoE层, 作者计算MoE Router做出的不同专家选择的数量, 并计算这些差异的频率. 图3a展示了结果. 可以观察到, 大约10%的Router在训练时选择了与推理时不同的专家.
- Token层面比较: 对于每个token, 作者计算在所有层中MoE路由器做出的不同专家选择的总数. 作者也确定了这些情况的频率. 图3b呈现了这些发现. 它显示, 94%的token在前向传播过程中至少在一个层中选择了不同的专家.
- 序列层面比较: 对于一个序列, 作者计算每个token的路由分布差异, 然后在所有token上取平均, 得到每个序列的平均差异, 并绘制直方图(图3c). 结果显示, 每个token的平均差异大约是6个Router.
这些发现证明了在训练和推理期间, MoE模型表现出路由分布的差异.
3.2.3 同一框架内对相同序列重复前向传播的差异
在Megatron框架下对同一组序列进行了两次前向传播, 并获得了两个概率分布. 计算了这些分布之间的KL散度并绘制了结果(散点图见图4, KL散度 = ).
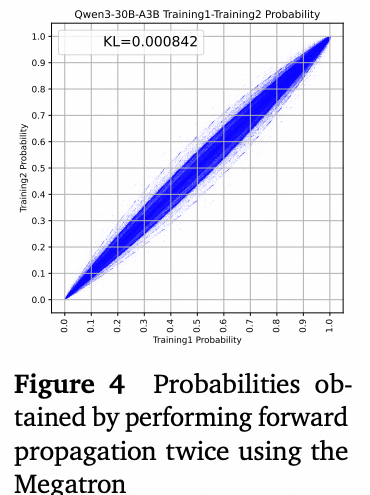
结果显示, 对于MoE模型, 在Megatron引擎中, 即使输入序列完全相同, 两次前向传播的最终输出概率也可能不同. 在强化学习的设置中, 这种变化为旧策略 的计算增加了噪声. 这种噪声使得重要性采样率不可靠, 从而可能破坏强化学习过程的稳定性, 甚至使其崩溃.
3.3 Rollout Routing Replay
3.3.1 实现
首先描述在训练框架内一个MoE层的常规前向传播过程. 考虑一个序列 的第 个token, 以及在第 个Transformer块中的MoE层. 设在训练期间该层的输入为 . 路由器的logits通过以下方式计算:
其中 表示路由器的线性权重矩阵. 设专家数量为 , 需要选择的专家数量为 . 在训练期间, 路由器根据logits选择得分最高的K个专家. 这由一个二进制掩码表示:
其中 且 . 门控权重(gating weights)随后通过对所选专家的logits应用softmax来产生:
最后, MoE层的输出计算为专家输出的加权和:
其中 表示第 个专家网络.
然后来看Rollout Routing Replay(R3). 假设在推理阶段, MoE层的输入是 . 路由器随后计算推理logits , 并从中获得路由掩码 .
R3的核心思想是在训练的前向传播中重用推理时的路由掩码 , 同时仍然对训练的logits应用softmax以保留梯度流.
具体来说, 沿着这条回放路径, “回放”门控权重 计算如下:
这些回放权重然后被用来组合训练专家的输出, 产生回放输出 :
这种设计服务于两个主要目的:
- 对齐训练和推理: 使用 确保了在训练回放期间使用的专家与推理时选择的专家相匹配, 消除了专家选择上的不匹配.
- 保留梯度数据流: 通过只回放掩码, 梯度仍然可以流回到logits, 而不干扰计算图, 这有助于有效地优化路由器.
通过细致的系统设计和实现, 作者使得能够从推理引擎存储和检索MoE路由器掩码数据, 在生成(rollout)阶段的总体延迟开销低于3%.
3.3.2 路由器掩码缓存与多轮对话支持
许多推理引擎使用KVCache前缀缓存策略来避免对先前看过的上下文进行冗余的 prefill 计算, 这显著减少了多轮交互中的总计算量. 作者观察到, 缓存的路由器掩码具有相似的属性: 对于相同的前缀token, MoE路由器应该产生相同的结果. 因此, 来自推理引擎的路由掩码 可以与前缀KVcache一起被缓存. 具体来说, 对于每个层和每个token前缀, 相应的路由掩码与KVCache一同存储. 当相同的前缀出现并命中缓存时, 这些掩码可以被重用, 无需重新计算. 这使得推广路由回放能够与前缀缓存机制无缝集成.
在智能体(agent)场景中, 缓存路由掩码尤其有益. 许多智能体任务, 如软件工程和网页浏览, 都涉及自回归生成和工具调用之间的多轮交互. 为了提高效率, 这些过程直接重用前几轮的KVCache, 因此它们不必重新生成已经计算过的数据. 路由掩码缓存使得R3在RL智能体任务中保持高效, 无需为了生成路由掩码而重新预填充, 这对于训练大规模、先进的MoE模型至关重要.
3.3.3 R3对训推差异的实证分析
为了评估R3在减少训练-推理差异方面的有效性, 继续使用Qwen3-30B-A3B模型进行采样, 缓存在SGLang上进行推理时获得的路由分布, 并在Megatron框架内回放它们. 在获得推理引擎概率和训练引擎概率后, 使用公式2, 估计了训练和推理之间的KL散度. 结果显示, 应用R3后, 训练和推理之间的KL散度从 下降到 , 这接近于稠密模型观察到的 .
4. 谈谈RL中的KL散度
在RL中通常都会使用到KL散度作为正则项来稳定训练. 但是具体实现时还涉及到几个维度的问题:
- 估计器的选择, 例如 K1, K2, K3 分别是什么, 有什么区别
- 采样策略的选择, On-policy 和 Off-policy以及一些micro-batch off-policy的区别?
- KL项的用法选择, 是作为损失项, 还是作为奖励项?
4.1 什么是KL散度
Kullback-Leibler 散度(KL散度) 是衡量一个概率分布与另一个概率分布差异的度量. 假设存在某个真实分布 ; 我们希望用一个近似分布 来估计它. 在这种情况下, KL 散度衡量了从近似分布 到真实分布 的距离. 详细的内容可以参考《KL Divergence for Machine Learning》[7]
从数学上讲, 考虑在某个空间 上的两个概率分布 . 从 到 的 Kullback-Leibler 散度 (写作 ) 是
KL散度不是一个距离度量, 对于一个距离度量需要满足:
- 非负性 (, 等于0当且仅当 );
- 对称性 ();
- 三角不等式 ().
KL 散度只满足条件1, 不满足条件2和3. 尽管不是严格的距离度量, 但它在局部可以近似为距离. 对于两个非常接近的分布 和 , KL 散度 在 上的二阶泰勒展开与Fisher信息矩阵 (Fisher Information Matrix,FIM)直接相关. Fisher信息度量了参数的微小变动如何导致分布的巨大变化, 它定义了参数空间上的一个局部距离, 称为信息距离. 这意味着, KL 散度在机器学习的优化过程中, 扮演了"局部距离"的角色, 指导着参数更新的方向和步长.
对于一个参数为的模型构建的近似分布为, 我们来考察 KL 散度 在 恰好等于 时的局部性质. 假设存在一个参数 , 使得 . 我们想研究当参数 在 附近微小扰动时, 是如何变化的.为此, 我们对 在 处进行二阶泰勒展开.
设 . 泰勒展开式为:
其中, 是 在 处的梯度 (一阶导数), 是 在 处的Hessian矩阵.
1. 计算零阶项
根据 KL 散度的性质, 当两个分布相同时, KL 散度为 0. 因为 , 所以:
2.计算一阶项
KL 散度的表达式为:
对 求梯度:
第一项 是 的熵, 与 无关, 所以其梯度为 0.
利用对数求导法则 :
现在, 我们在 处计算这个梯度. 此时 :
因为 对所有 成立, 所以其对 的梯度恒为 0:
因此,
结论: KL 散度在 时达到最小值 0, 这一点是它的驻点 (stationary point), 其梯度为 0.
3. 计算二阶项(黑塞矩阵)
我们需要对梯度 再次求导.
Hessian矩阵
我们来计算 . 这是一个二阶导数:
代回到Hessian矩阵的表达式:
在 处, :
第一项是 . 所以只剩下第二项:
或者用期望的形式写:
这个表达式正是Fisher信息矩阵 的定义.
将第 1, 2, 3 步的结果代入泰勒展开式:
4.2 KL散度的不对称性
但是需要注意的是KL散度是不对称的: 也就是说 . 因此, 它也不是一个距离度量.
我们可以仔细观察公式中的分母 . 假如真实情况 的概率很大(某件事极大概率发生), 但你的模型 却认为它绝不可能发生(概率接近 0), 那么整体的 KL散度会瞬间爆炸(趋向无穷大). 这种不对称性迫使我们在算法设计时必须做出站位选择.
让我们把自己置于一个优化场景中. 存在某个我们试图用近似分布 来估计的真实分布 . 因此, 当我们试图用 来近似 时, 我们可以选择优化两个潜在的目标之一:
- 最小化前向 KL (Forward KL):
- 最小化反向 KL (Reverse KL):
这两种不同的目标实际上会导致不同类型的近似行为.
我们将用一个例子来研究这个问题, 假设 是下面的双峰分布 (bimodal distribution),如下图所示:
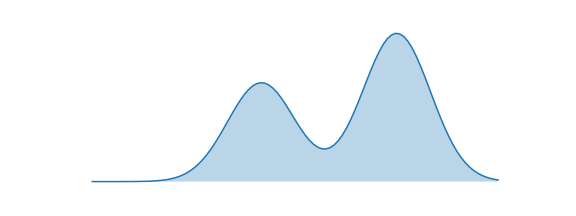 我们将尝试用一个正态分布 来近似它.
前向 KL:
让我们考虑优化关于 的前向 KL 目标.
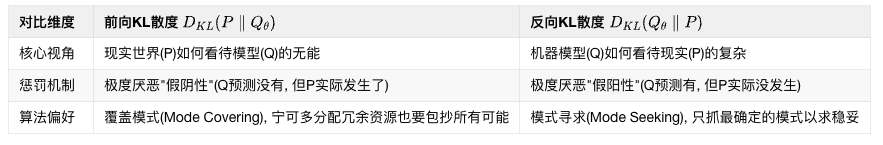
我们注意到这与最大似然估计 (Maximum Likelihood Estimation, MLE) 的目标是完全相同的. 上述目标将从 中采样点, 并试图在模型 下最大化这些点的概率. 具体来说, 当时, 这一项对整体的KL散度就有影响, 因此分母作为分母需要尽量大才能保证KL散度小, 如果 (即模型 错过了真实分布 的一个模式), 那么 . 因为 是一个不可忽略的权重, 这会导致 趋向于无穷大. 为了避免这种无限惩罚, 模型 被迫在所有 的地方都赋予一定的概率质量, 哪怕只是很少. 这就导致了 会"伸展"自己去覆盖 的所有模式. 这种行为视为覆盖模式(Mode Covering), 因为近似分布 必须覆盖 中的所有模式和高概率区域.
反过来看, 如果某个点 使得 但 (即模型 在真实世界不可能的地方产生了概率), 那么这一项 的贡献是 . 前向 KL 对此完全没有惩罚.
对于我们的例子, 最优的"近似"分布如下所示. 注意, 这个近似分布将自己置于两个模式的中间, 以便能够对两者都有高覆盖度.
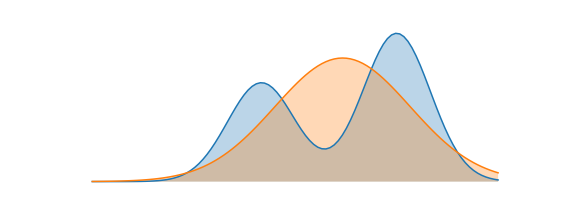
前向 KL 散度不会因为 在 没有概率质量的地方赋予了高概率质量而惩罚它. 因此惩罚机制来看, 它极度厌恶"假阴性"(Q预测没有, 但P实际发生了).
反向 KL:
现在考虑优化关于 的反向 KL 目标.
因此当时, 这一项对整体的KL散度就有影响, 如果 (即模型 试图在真实分布 的低谷区域产生样本), 那么 . 因为 是权重, 只要 在那里有概率, 这一项就会对 KL 散度贡献一个巨大的值. 为了避免这种惩罚, 模型 被迫只在 概率很高的地方活动. 这就导致 会"收缩"自己, 躲进 的某个峰值(模式)中, 造成了模式寻求 (Mode Seeking的效果.从惩罚机制上来看, 它极度厌恶"假阳性"(Q预测有, 但P实际没发生)
如果某个点 使得 但 (即模型 完全忽略了 的某个模式), 那么这一项 的贡献是 . 反向 KL 对此完全没有惩罚.
对于我们的例子, 最优的"近似"分布如下所示.
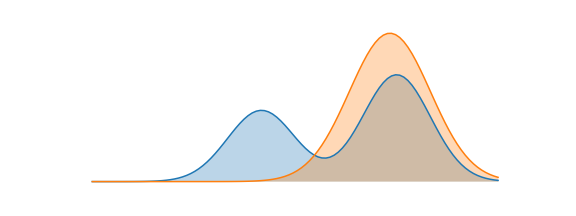
注意, 这个近似分布基本上只包含了 的右边那个模式.
4.3 如何选择Forward KL 和 Reverse KL
Supervised Learning = Forward KL
想象一下你是一个学生, 老师 (真实世界 ) 给了你一大堆习题和标准答案 (数据集 ). 你的目标是学习一个解题方法 (模型 ), 让你的答案尽可能接近标准答案.你看着标准答案, 然后调整自己的解题思路, 让你对这道题的解答能得到标准答案的概率最大化. 这就是最大似然估计.
这个过程正是在最小化前向 KL 散度 . 你是从"真实世界" () 中拿样本 (习题和答案), 然后强迫你的"模型" () 去覆盖它们. 假设我们从一大堆习题和标准答案中取出一个道题 , 对于这个样本, , 因为它确实存在.如果我们的模型 在此时犯了"假阴性"错误, 它会预测: "这道题的答案是错误的!", 也就是 . 此时, KL散度中对应这一项的值变为: 一个样本的"假阴性"错误, 就足以让总的KL散度(损失)变为无穷大.这种对"假阴性"的极度憎恶, 迫使模型 变得"兼容并包".
Reinforcement Learning = Reverse KL
想象一下现在你毕业了, 不再有标准答案. 你成了一个创业者 (智能体 ), 市场 (环境) 只会给你回报 (奖励 ). 你的目标是找到一套能最大化利润的商业模式.你不能直接"抄"成功企业 () 的模式, 因为商业机密没人会给你. 你只能根据自己的商业模式 () 去市场上闯荡, 得到利润或亏损 (奖励), 然后根据这些反馈来调整你的模式.
这个过程, 正是在最小化反向 KL 散度 . 你是从你自己的模型 () 出发去采样 (尝试商业行为), 然后用市场的反馈 (奖励 ) 来评估你的行为在"理想世界" () 中有多大的成功概率.
假设你尝试了一种行为 (比如工作日对滞销品提价), 即考虑了一个动作 , 并赋予了它一个非零的概率, . 结果亏了钱 (负奖励), 因此在最优策略 中, 这个动作的概率为零, .此时, KL散度中对应这一项的值变为:
仅仅是考虑去做一个坏动作, 就足以让总的KL散度(损失)变为无穷大. 你的优化算法 (反向KL) 会严厉惩罚这种行为, 让你以后不再这么做.
4.4 KL 估计器
由于现代LLM作为RL策略, 这使得KL散度的表达式非常复杂, 几乎不可能得到解析解. 因此我们需要基于采样, 强化学习的"学习"过程是基于从环境中采样得到的有限数量的轨迹(trajectories). 我们只有一批 数据. 我们能做的, 就是利用这批样本来近似或估计我们关心的所有期望值, 包括期望回报和期望KL散度. John Schulman博客《Approximating KL Divergence》[9]详细探讨了如何用蒙特卡洛方法估计KL散度 .
估计量 : 朴素估计量 (无偏但高方差)
根据KL散度的定义, , 最直接的蒙特卡洛估计量就是将被积函数本身作为单样本估计值:
其中 是概率密度比.
估计量 : 平方估计量 (低方差但有偏)
另一个替代的估计量是
它具有较低的方差但有偏差. 直观上, 似乎更好, 因为每个样本都在告诉你 和 的差距有多大, 并且它永远是正的. 经验表明, 的方差确实比 小得多.当 和 很接近时, 这个偏差非常小, 这使得 在很多实际场景中依然是一个不错的近似.
估计量 : 改进的无偏估计量 (低方差且无偏)
有没有可能写出一个既无偏又低方差的KL散度估计量呢? 降低方差的通用方法是使用控制变量(control variate). 如果我们想估计 , 并且我们知道另一个随机变量 的期望 , 那么我们可以构造一个新的估计量 . 显然 , 估计量是无偏的. 通过选择合适的 , 如果 和 相关, 我们就可以降低 的方差.
我们想估计的 是 .我们需要一个期望为0的控制变量. 作者找到了 . 我们来验证一下:
所以, 是一个期望为0的项. 然后构造新的无偏估计量: .
如何选择 ?: 理论上最优的 很难计算. 作者采取了一个非常巧妙的启发式方法: 选取 . 这个选择的动机是, 根据凹函数的性质, 我们有 . 这意味着 .
因此,最终的估计量:
几何的视角
回顾一下我们在4.1节中谈到,对于两个非常接近的分布 和 , KL 散度 在 上的二阶泰勒展开与Fisher信息矩阵 (Fisher Information Matrix,FIM)直接相关.
估计量 虽然是有偏差的, 但是在John Schulman的博客中通过引入f-散度进行了分析 .f-散度是衡量两个概率分布 和 差异的一大类度量. 它的定义依赖于一个凸函数 , 形式为:
许多常见的散度都是f-散度的特例, 只要选择不同的生成函数 :
- Forwad KL散度 :
- Reverse KL散度 :
我们来考察 在分布 下的期望:
这符合f-散度的定义, 只要我们令生成函数 . 我们可以验证 是一个凸函数(其二阶导数为 , 在 区间内为正, 这覆盖了 的情况, 即 ).
当两个分布 和 非常接近时 (例如, 是一个参数化分布, 在 0 附近, 使得 ), 任何f-散度 关于参数 的行为都可以通过泰勒展开来近似.
展开到二阶, 它们的形式都变成了 . 这里的 是Fisher信息矩阵, 它定义了参数空间中的一个黎曼度量, 与具体的f-散度选择无关. 这意味着, 局部来看, 所有f-散度都由同一个二次型 决定, 区别仅仅在于一个常数缩放因子 .
接下来我们从 Bregman散度[10]的几何视角谈谈.
对于一个在某个凸集 上可微的严格凸函数 , 点 之间的Bregman散度定义为:
让我们分解这个公式:
- : 函数在点 的值.
- : 这是函数 在点 处的一阶泰勒展开式, 也就是在点 处的切线(或切超平面)在点 处的值.
- : 表示向量内积.
从几何直观来说, Bregman散度最直观的理解是: 一个严格凸函数与其切线之间的差值.想象一个严格凸函数 , 就像一个向上开口的碗.
- 我们在碗底的某一点 画一条切线.
- 然后, 我们在碗上另取一点 .
- Bregman散度 就是在 点, 碗本身的高度 与 那条在 点画出的切线在 处的高度 之间的垂直距离.
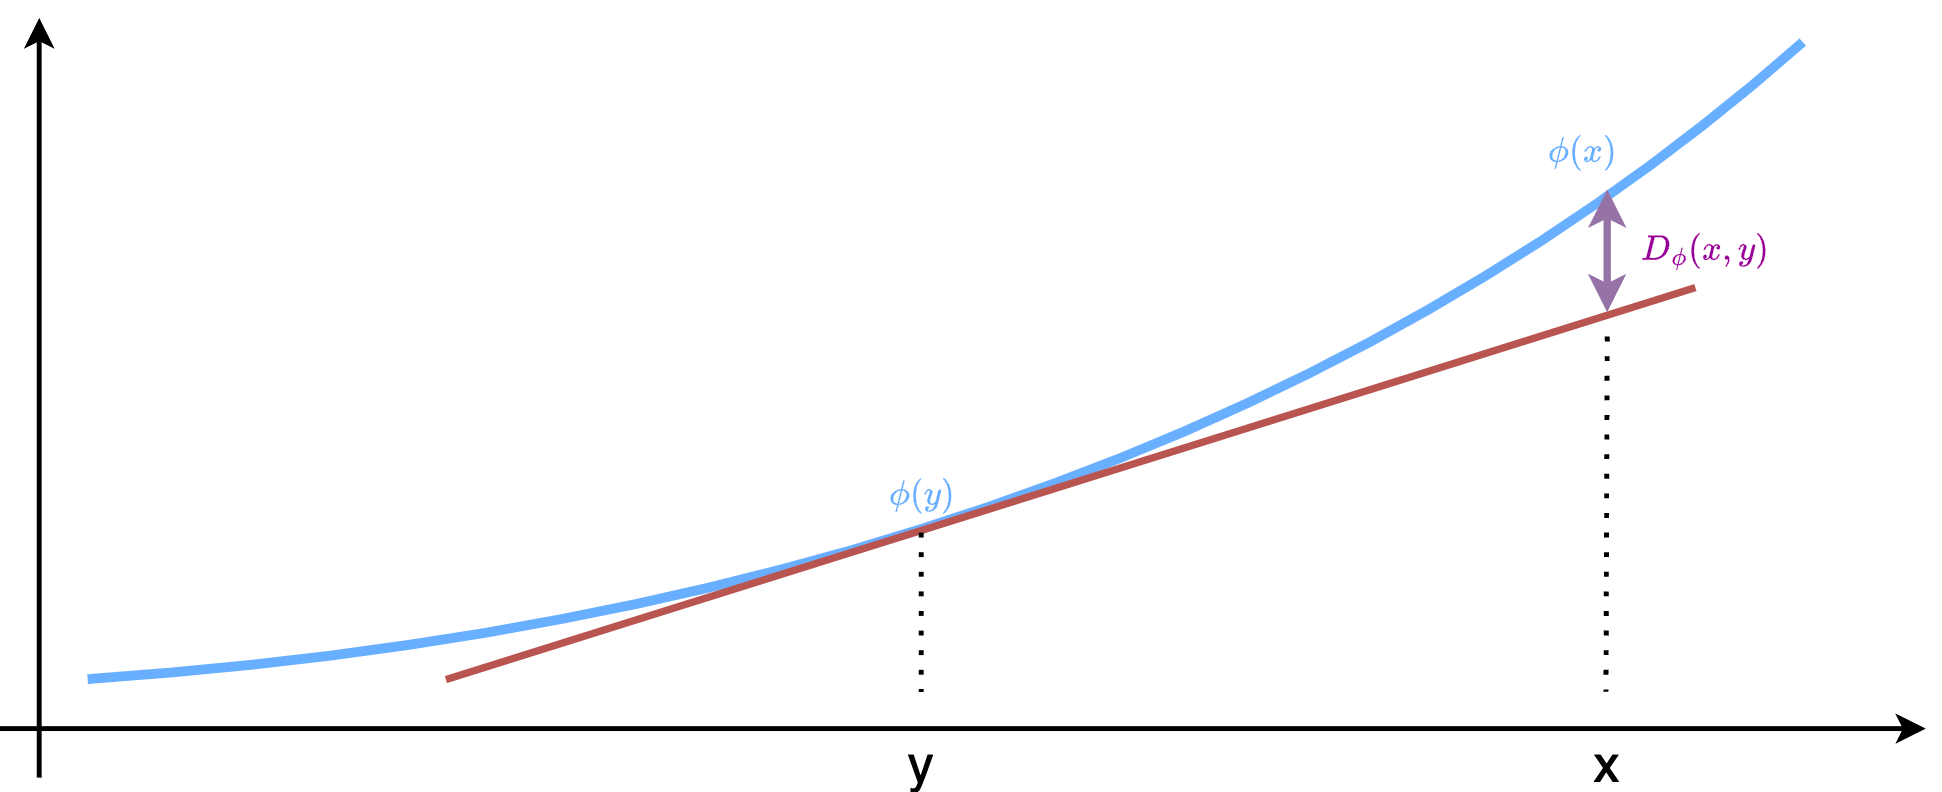
现在, 让我们选择凸函数 (注意, 这是的f-散度生成函数). 它的导数是 . 让我们计算 和 之间的Bregman散度:
这正是 , 因此 不仅仅是一个碰巧好用的公式, 它具有清晰的几何意义: 它是KL散度生成函数 所诱导的Bregman散度. 这种结构保证了它的非负性和其他良好性质.
4.5 KL惩罚的使用方式
接下来我们谈谈在RL中KL惩罚的使用方式, 接下来我们参考《A Comedy of Estimators: On KL Regularization in RL Training of LLMs》[11]以及《RL 中的 KL 估计器选型:从数值无偏到梯度正确》[12]这篇两篇文章进行分析.
对于KL惩罚如何处理存在几个选择:
- KL-in-reward 或者 KL-in-loss该如何选择?
- 估计器该如何选择?
- 针对on-policy/off-policy采样, 该如何处理?
这一节, 我们使用的一些符号如下表所示:
| 符号 | 描述 |
|---|---|
| 使用强化学习训练的策略 | |
| 参考策略(基础模型) | |
| 提示词(Prompt) | |
| 生成的包含 个token的响应(Response) | |
| 响应 中第 个位置的token |
4.5.1 KL的梯度
对于任何依赖于参数 的函数 和在由 参数化的分布 下的期望, 其梯度为:
使用乘法法则展开:
使用"对数导数技巧" :
将 重新写为期望形式:
这就得到了梯度的两个核心部分:
- 得分函数导数 (Score Function Derivative): , 对应期望内部估计器的梯度.
- 路径导数 (Path-wise Derivative): ,由期望中依赖于参数 的采样过程引起
在我们的问题中, 就是KL散度估算器, 我们记为 . 那么KL正则化项的梯度是:
4.5.2 KL-in-Reward vs KL-in-Loss
在GRPO的论文《DeepSeekMath》[13]中的第四章详细介绍过. PPO是添加在Reward项中, 而GRPO是添加到损失函数中. 具体区别如下:
KL-in-Reward
PPO在每个 token 处, 在奖励中加入一个来自参考模型(Reference Model)的逐 token KL 惩罚项, 具体实现是通过对KL估计应用停止梯度(Stop-gradient,sg)操作并将其添加到 token 级任务得分中, 可以将估计器添加到奖励中. 随后计算优势(Advantage)如下:
其中 是 token 级任务得分(中间 token 通常为0, 最后一个 token 取决于序列是否得出正确答案而为1或0), 是分配给 token 的优势, , 是优势基线(Baseline), 而 指的是停止梯度操作. 目标函数 的梯度为:
KL-in-Loss
GRPO 没有在奖励中添加 KL 惩罚, 而是直接将训练策略和参考策略之间的 KL 散度添加到损失函数中进行正则化,目标函数的梯度计算如下:
请注意, 在KL-in-reward 时, 其对梯度的贡献是 , 而在 KL-in-loss 时, 其贡献是 (两者均由 缩放).
因此, 在一般情况下, 这两项孤立来看, 相对于方程(*)中所述的正确梯度, 都是有偏的.
从具体代码实现上来看, 前者使用了stop_gradient, 即在Pytorch中使用.detach()处理. 它是区分"in-reward"和"in-loss"两种梯度路径的核心机制. 下面是一段代码实例来区分两者, 首先我们来看KL-in-reward, 计算如下:
# 计算KL散度估算值
kl_estimate = compute_kl(log_probs_theta,log_probs_ref)
# 核心步骤: 使用 .detach() 将 kl_estimate 从计算图中分离
kl_term_for_reward = kl_estimate.detach()
# 然后将KL项作为惩罚加入到优势中
# 注意: 论文中的 advantage = R - b - beta * KL, 在 PPO 损失中是 -advantage * log_prob
# 所以等价于 - (R - b) * log_prob + beta * KL * log_prob, 这里为了清晰, 我们直接在优势上操作
advantage_with_kl_reward = advantage - beta * kl_term_for_reward
loss_kl_in_reward = -advantage_with_kl_reward * log_prob_of_sampled_token然后我们来看KL-in-Loss的计算:
# 计算KL散度估算值
kl_estimate = compute_kl(log_probs_theta,log_probs_ref)
# 计算不含KL的原始策略损失
policy_loss = -advantage * log_prob_of_sampled_token
# L = - A * log(pi(a|s)) + beta * KL
loss_kl_in_loss = policy_loss + beta * kl_estimate4.5.3 不同KL估计器的区别
下面我们来看不同 KL 估计器的梯度有什么区别. 在4.4节我们介绍了三种KL估计器, 基于纯数值的角度给了一些结论:
- :
无偏, 但 单样本值可正可负导致高方差 - :
有偏,当两个分布非常接近时偏差较小, 由于恒正, 它具有较低方差 - :
无偏, 且具有较低方差
在RL中, 通常我们使用Reverse KL, 即, 估计器定义如下:
为了使推导过程清晰且可复用, 我们首先计算所有估计器都依赖的基础组件的梯度. 记
- , 它为概率比
- 对数概率比 的梯度: 对上式求关于 的梯度. 由于 是一个固定的参考分布, 它不依赖于 , 因此 .
- 概率比 的梯度: 我们利用链式法则: . 将上面计算出的 代入:
4.5.3.1 估计器的梯度
接下来我们来计算每个估计器的梯度.
K1 Estimator 的梯度
根据定义, .
代入我们准备好的结果 :
K2 Estimator 的梯度
根据定义, . 我们应用链式法则:
代入 :
最后, 使用对数的基本性质 :
K3 Estimator 的梯度
根据定义, . 利用梯度的线性性质:
代入我们准备好的两个基础结果:
提取公因式 :
最后, 我们总结一下三个估计器的梯度:
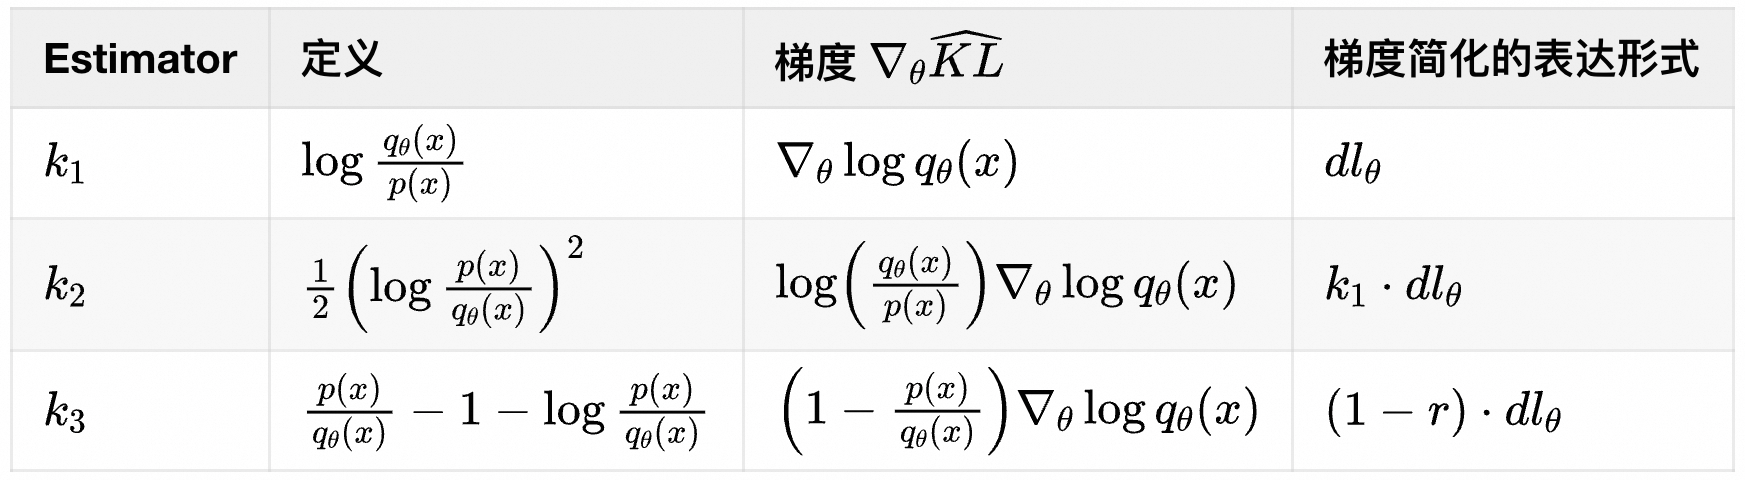
4.5.3.2 KL-in-Loss时的梯度分析
我们回顾4.5.2节的分析和公式(*):
- KL-in-reward 只计算了得分函数导数 (Score Function Derivative) 部分
- KL-in-loss 只计算了路径导数 (Path-wise Derivative) 部分
对于一个KL估计器 , 前一节我们计算了它的梯度, 的梯度的期望 恰好就是路径导数. 因此我们可以根据前一节计算的估计器梯度的期望来分析 KL-in-Loss 的情况.
K1-in-Loss
我们计算K1梯度的期望如下:
K2-in-Loss
我们计算K2梯度的期望如下:
K3-in-Loss
我们计算K3梯度的期望如下:
- 利用期望的线性性质, 将其拆分为两项:
- 分析第一项: , 其期望为 0. 具体推导如下
- 我们将第二项的期望形式展开为积分(对于离散情况, 积分换为求和): 这个积分形式, 正是 "" 在分布 下的期望的定义.
这个结果与Forward KL散度的梯度 完全一致, 下面我们来计算一下Forward KL散度的梯度:
因此我们得到:
我们总结一下KL-in-Loss中三种估计器的区别:
- -in-loss: , 完全无效, 会导致训练不稳定
- -in-loss: ,正好为Reverse KL, 无偏
- -in-loss: ,正好为Forward KL, 但是它的梯度是有偏的.
看上去-in-loss最好? 但是我们不光需要考虑无偏性, 还需要考虑方差的影响. 对于梯度随机向量, 我们应该计算它的协方差 , 但是相对复杂. 为了简化, 我们计算协方差矩阵的迹, 它等于向量各分量方差之和, 用于衡量整体梯度的波动性.
我们将使用这个公式, 其中 分别是 .
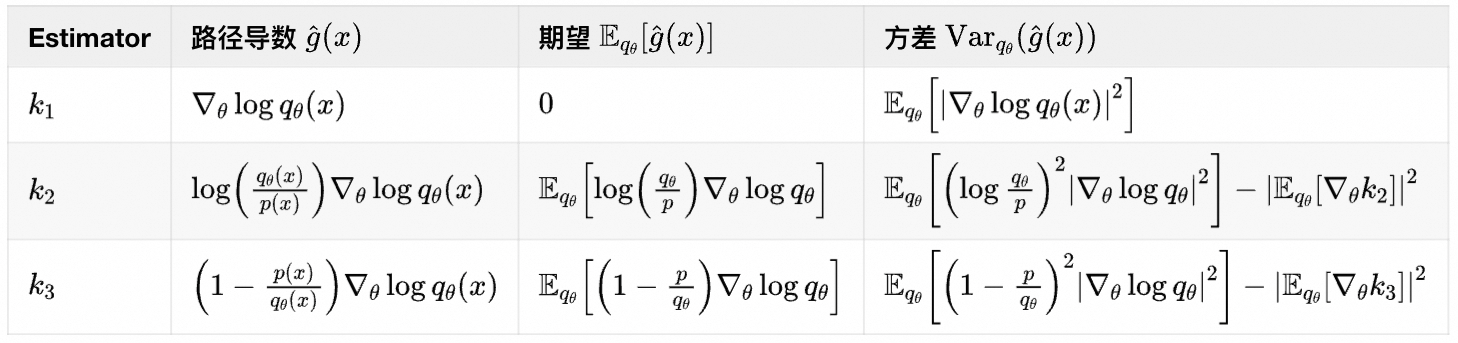
基础: 波动性的共同来源:得分函数
在分析三者差异之前, 我们必须认识到它们共享一个共同的、基础的波动来源: 得分函数 (Score Function) . 得分函数本身的波动性是所有策略梯度方法不稳定的根源. 这意味着, 只要你的策略 偶尔采样到一个"离群"的尾部样本, 你就会得到一个幅度巨大的梯度, 从而产生巨大的方差. 任何基于得分函数的梯度估计器都无法逃脱这个宿命.
总结一下:
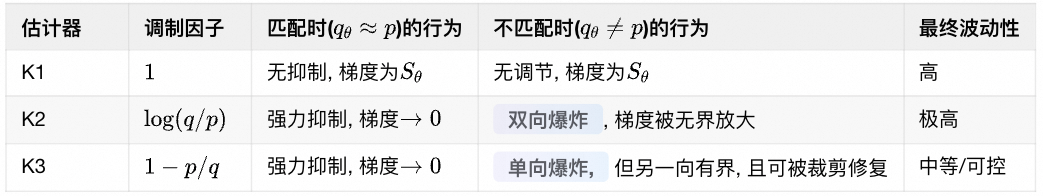
4.5.3.3 KL-in-Reward时的梯度分析
前面我们介绍过, KL-in-reward: 只计算得分函数导数.
k1
结论: 的得分函数导数是真实Reverse KL散度梯度的无偏估计.
k2
结论: 的得分函数导数是真实Reverse KL散度梯度的有偏估计.这意味着K2-in-reward会导致优化目标发生偏离.
k3
结论: 的得分函数导数是真实Reverse KL散度梯度的有偏估计. 因此K3-in-reward会导致训练崩溃. 这很可能是因为这个偏差项引入了巨大的梯度方差和不正确的优化方向, 使得训练过程极不稳定.
4.6 Off-policy k3-in-loss
在DeepSeek-V3.2的论文中提到, 关于off-policy中使用估计器时, 无偏修正如下:
实际上它是在估计器的基础上进行了重要性采样权重的修正:
直观的解释是: "我知道这个样本()来自一个旧策略, 有点'不合时宜'. 为了公平起见, 我要给它乘上一个权重(新旧策略的概率比), 把它校正回当前策略下的样子, 然后再用K3公式计算KL散度." 接下来我们做一些详细分析
1. 符号和表达式简化
为了使推导更清晰, 我们首先简化符号. 考虑单个token :
- 当前策略的概率:
- 旧策略的概率: (相对于是常数)
- 参考策略的概率: (相对于是常数)
修正的估算器, 我们记为 , 可以写作:
为了方便求导, 我们将 乘进去:
第一项中的 抵消, 得到一个更清晰的表达式:
2. 计算梯度
现在我们对上式关于 求导. 记住, 只有 是 的函数.
3. 计算策略梯度的期望
现在我们计算这个梯度的期望. 关键在于, 期望是关于采样分布 (即 ) 来计算的.
4. 和真实梯度比较
对于Reverse KL散度 的梯度是:
我们发现, 我们计算出的期望梯度与真实梯度完全相同. 这就证明了, 即使在off-policy的设定下, 该估算器 的路径导数 (即 KL-in-loss实现) 也是对真实 KL梯度的一个无偏估计.