TL;DR
最近 Neo Cloud 爆出很多安全问题, 以及 OpenAI 等沙箱漏洞被模型利用导致攻击huggingface 等案例出现, 当 LLM 能力越来越强的时候, Nvidia 也在开始宣传 Scale-in 旨在将传统的南北向网络改造成专为 Agentic AI Factories 提供安全、管理和数据加速的统一基础设施域.
那么 Agentic 时代的 DPU 是什么? 其实很早就有了答案, DPU这个词定义不清, 最早来源于Fungible, 他们也没想清楚, 而 Nvidia 沿用这个词也没想明白. CPU和GPU能不能处理 Data 是不是也叫 DPU ? 交换机甚至 FPGA 也能处理 data 是不是也算 DPU ? 其实我们很早就已经把它定义清楚了, 正确的说法应该是: 云基础设施处理器CIPU. 而 Scale-In DPU 的说法实质上就是对这个概念的展开的解释, 进一步定义清楚 DPU 是什么.
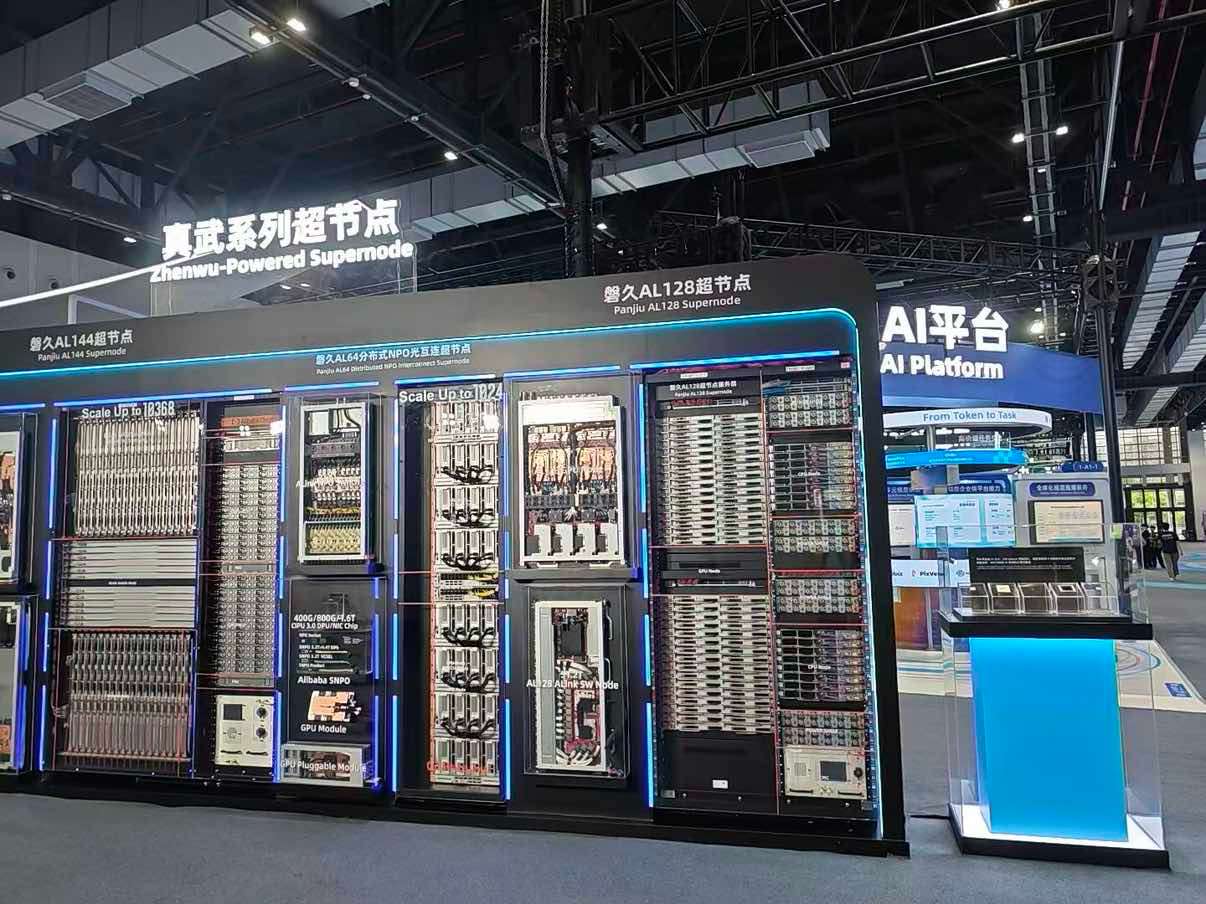
这次云栖大会我们带来了一个专题云基础设施处理器CIPU技术深度解读[1], 详细阐述了CIPU如何构建阿里云AI Agent、推理、训练等AI infra核心技术竞争力.
1. AI时代重申云计算核心价值主张
由于算力资源持续紧张, 我们经常会在各种社交媒体上看到各种小广告, xx 8卡服务器 xx 万元可租, 当前到货 xx 台, 通常我们可以把这类称为微商云, 另一方面是以 Coreweave 这类为代表的新云(Neo Cloud). 整个行业似乎都在疯狂的扩张算力, 所有的关注点都在性能. 那么这些云和传统的云服务提供商(AWS, GCP, Azure, Alicloud等)有什么区别?
因此, 我们需要在这里详细谈谈 AI 时代的云计算核心价值是什么?
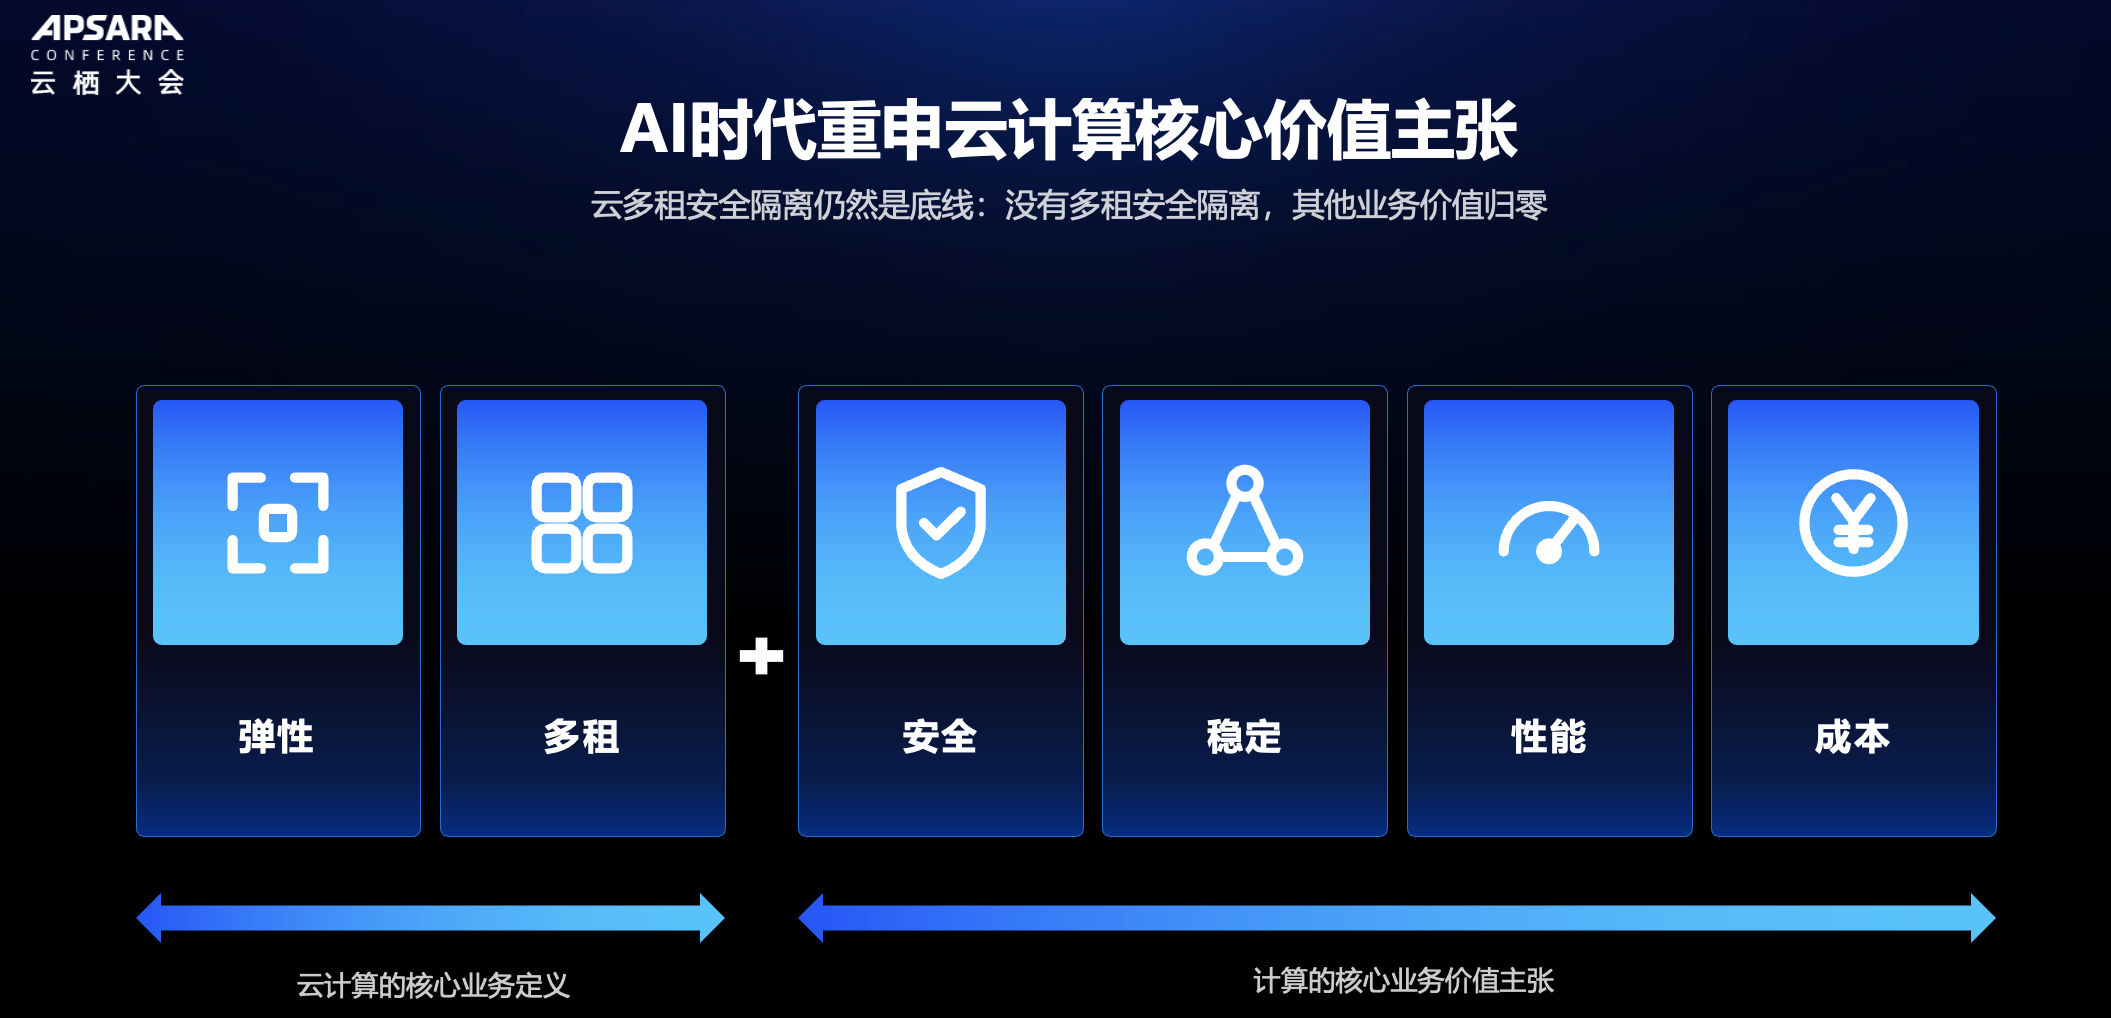
首先谈谈计算的核心业务价值, 你肯定不想自己的代码被错误的泄漏, 或者核心业务因为稳定性问题导致资损. 但是随着模型的能力越来越强, Agentic 时代的到来, 一系列问题出现了... 你肯定不想代码被错误的上传和泄漏, 也不想错误的攻击某些核心系统导致故障. 因此安全·稳定是计算的基石. 然后才是性能·成本, 同样的处理器能不能比其它计算提供方的性能高 10%~20%, 或者同样的性能价格低10%~20%? 这些价值主张, 无论是云计算还是本地化部署的计算, 都是需要考虑的.
那么什么是云计算? 云计算的核心业务定义是什么? 主要聚焦在弹性和多租上, 怎么理解这两个词, 其实国内由于大量的IDC建设和私有化部署, 很多人对于弹性的理解是不足的, 特别是在 Agentic 时代, 可能某些任务临时需要几百万核的 CPU 计算资源, 所谓的弹性其实就是为这些计算需求注入了算力流动性. 而云服务提供商实质上就变成了一个算力金融机构, 特别是在最近这些年算力紧张的时候. 既然云在为多个客户提供算力流动性, 那么多租户的安全隔离成为最重要的一个底线, 就像你存在银行的钱不希望被别人盗取, 而对于计算, 你也不希望你关键的数据被其他人获取/篡改甚至是删除...这个话题以前详细写了一篇文章锐评某友商说传统云还在卖铁: 从金融的视角谈云计算及其流动性管理 可以展开阅读一下.
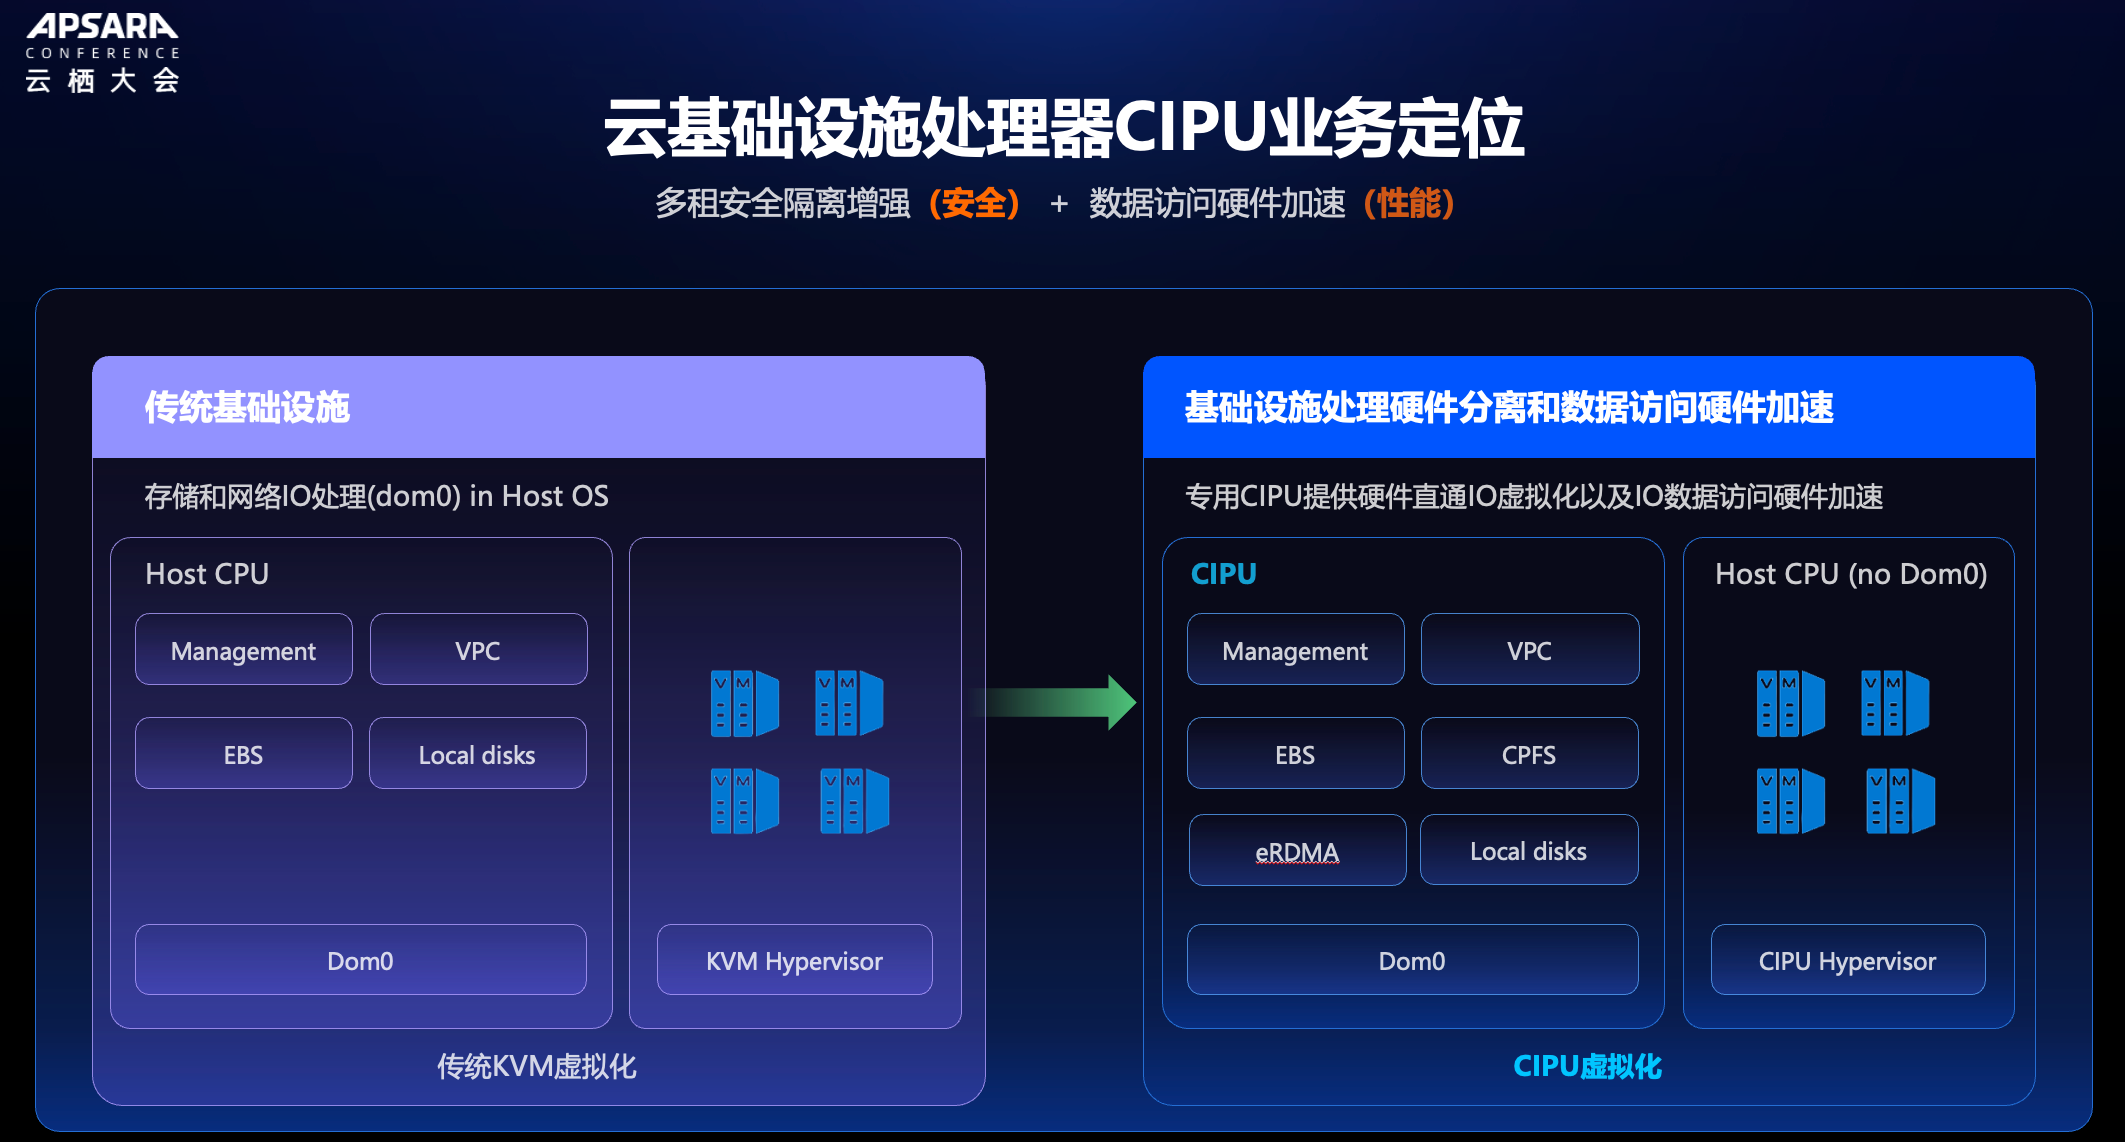
因此在 AI 时代, 我们重申云计算核心价值主张: 云多租安全隔离仍然是底线: 没有多租安全隔离, 其他业务价值归零. 正是弹性和多租这两个云计算的核心业务定义, 才推导出云的基础设施中需要有一颗新的处理器来负责处理这些业务. 这也是过去几年 DPU 这个概念没讲清楚的, 而如今重申 Scale-In 的原因. 而我们很早就定义好了这类处理器, 即云基础设施处理器:CIPU. 它主要业务定位是构建多租安全隔离增强(安全) + 数据访问硬件加速(性能)
整个 CIPU 的发展刚好经过了 10 年的沉淀和 5 代架构的演进, 但唯一不变的是我们从第一天起就始终以云计算核心业务价值为中心.
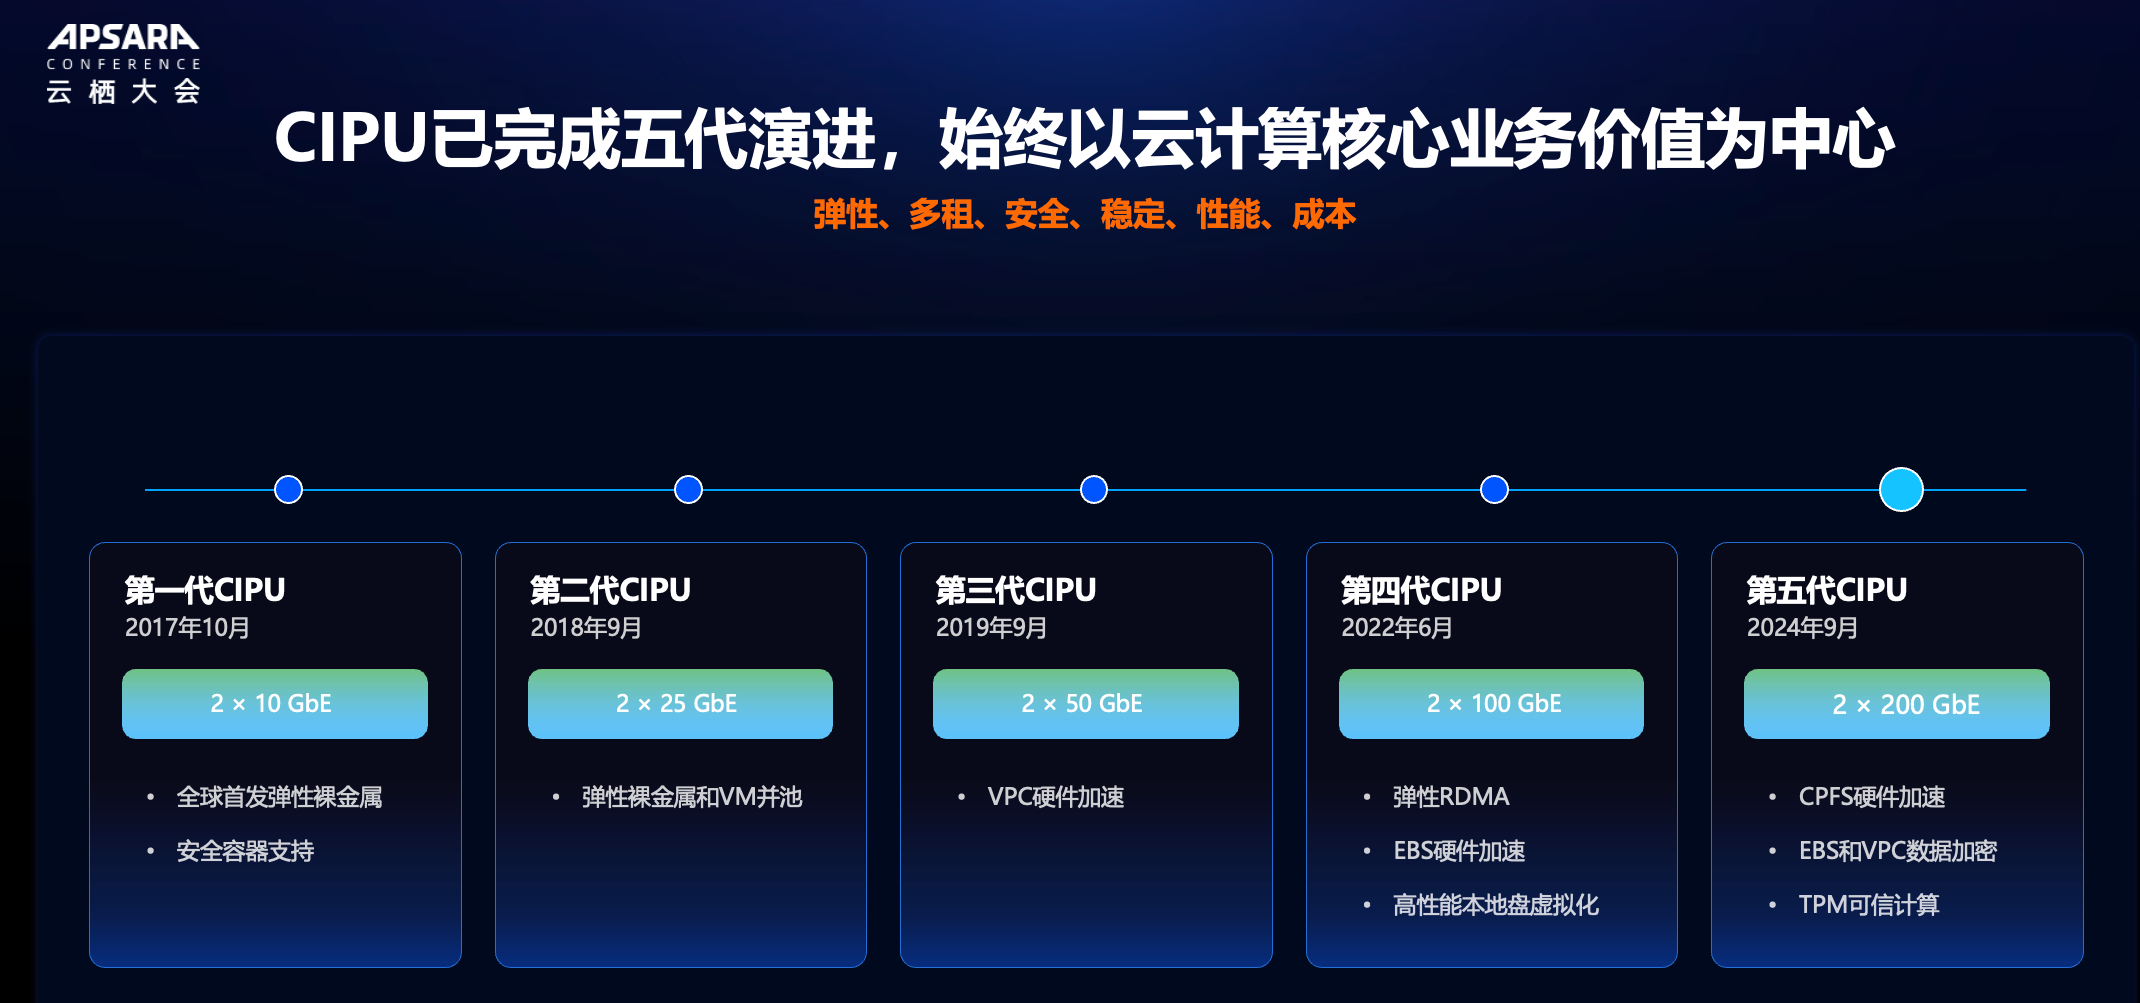
首先是弹性裸金属实例, 这个技术是阿里云 CIPU 团队首创的, 并于 2017 年 10 月发布. 即便是云计算的一哥 AWS 也比我们晚了一个月. 而如今无论是 GPU 算力服务器, 还是用于 Agent Sandbox 的 CPU 服务器, 都构建在裸金属技术之上... 然后第二代 CIPU 实现了弹性裸金属和 VM 并池, 用金融的话语来说就是算力证券化来提供更好的算力流动性. 接下来第三代在 VPC 网络上实现了硬件加速, 第四代进一步构建了存储/本地盘虚拟化加速能了, 并很早的布局了针对云上弹性和多租隔离需求的弹性RDMA(eRDMA)能力, 成为全球第一个在所有Region 所有 AZ 的所有 CPU/GPU实例上提供标准的 RDMA RC Verbs接口的云服务提供商. 而第五代 CIPU 进一步增加了 CPFS 这类云上的并行文件系统的加速以及数据加密和 TPM 可信计算的能力.
2. AI时代云基础设施面临哪些新业务机遇和新技术挑战?
过去的几个月, 伴随着 LLM 能力越来越强暴露出了大量的安全隐患, 首先是 2026 年 7 月, openAI 由于 agent 从沙箱中逃逸, 发起了对 HuggingFace 的攻击, 然后媒体逐渐开始关注到基础设施的安全性问题, 2026 年 8 月 30 日 SemiAnalysis 专门发了一个稿揭露大多数 neo cloud 安全漏洞百出 Most Neoclouds Suck At Security[2]. 也引来了很多大佬的关注
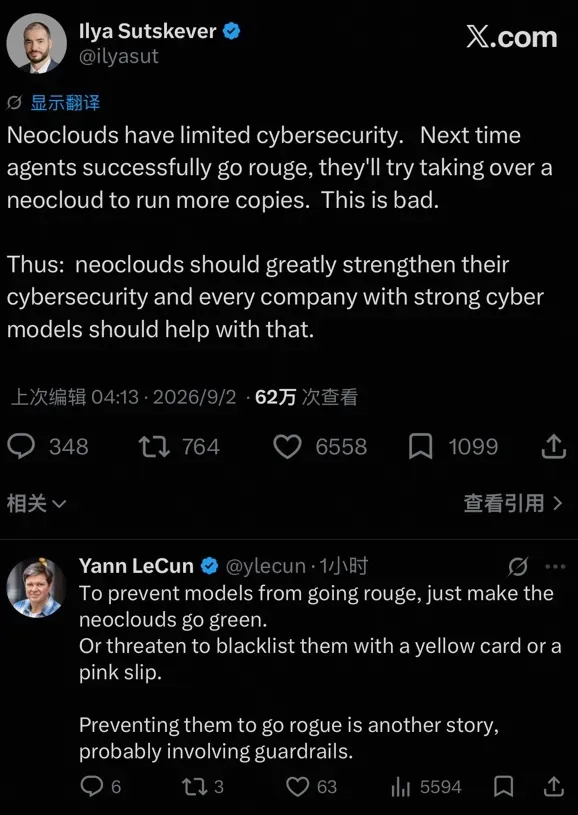
更详细的介绍可以访问谈谈 neocloud 的安全问题
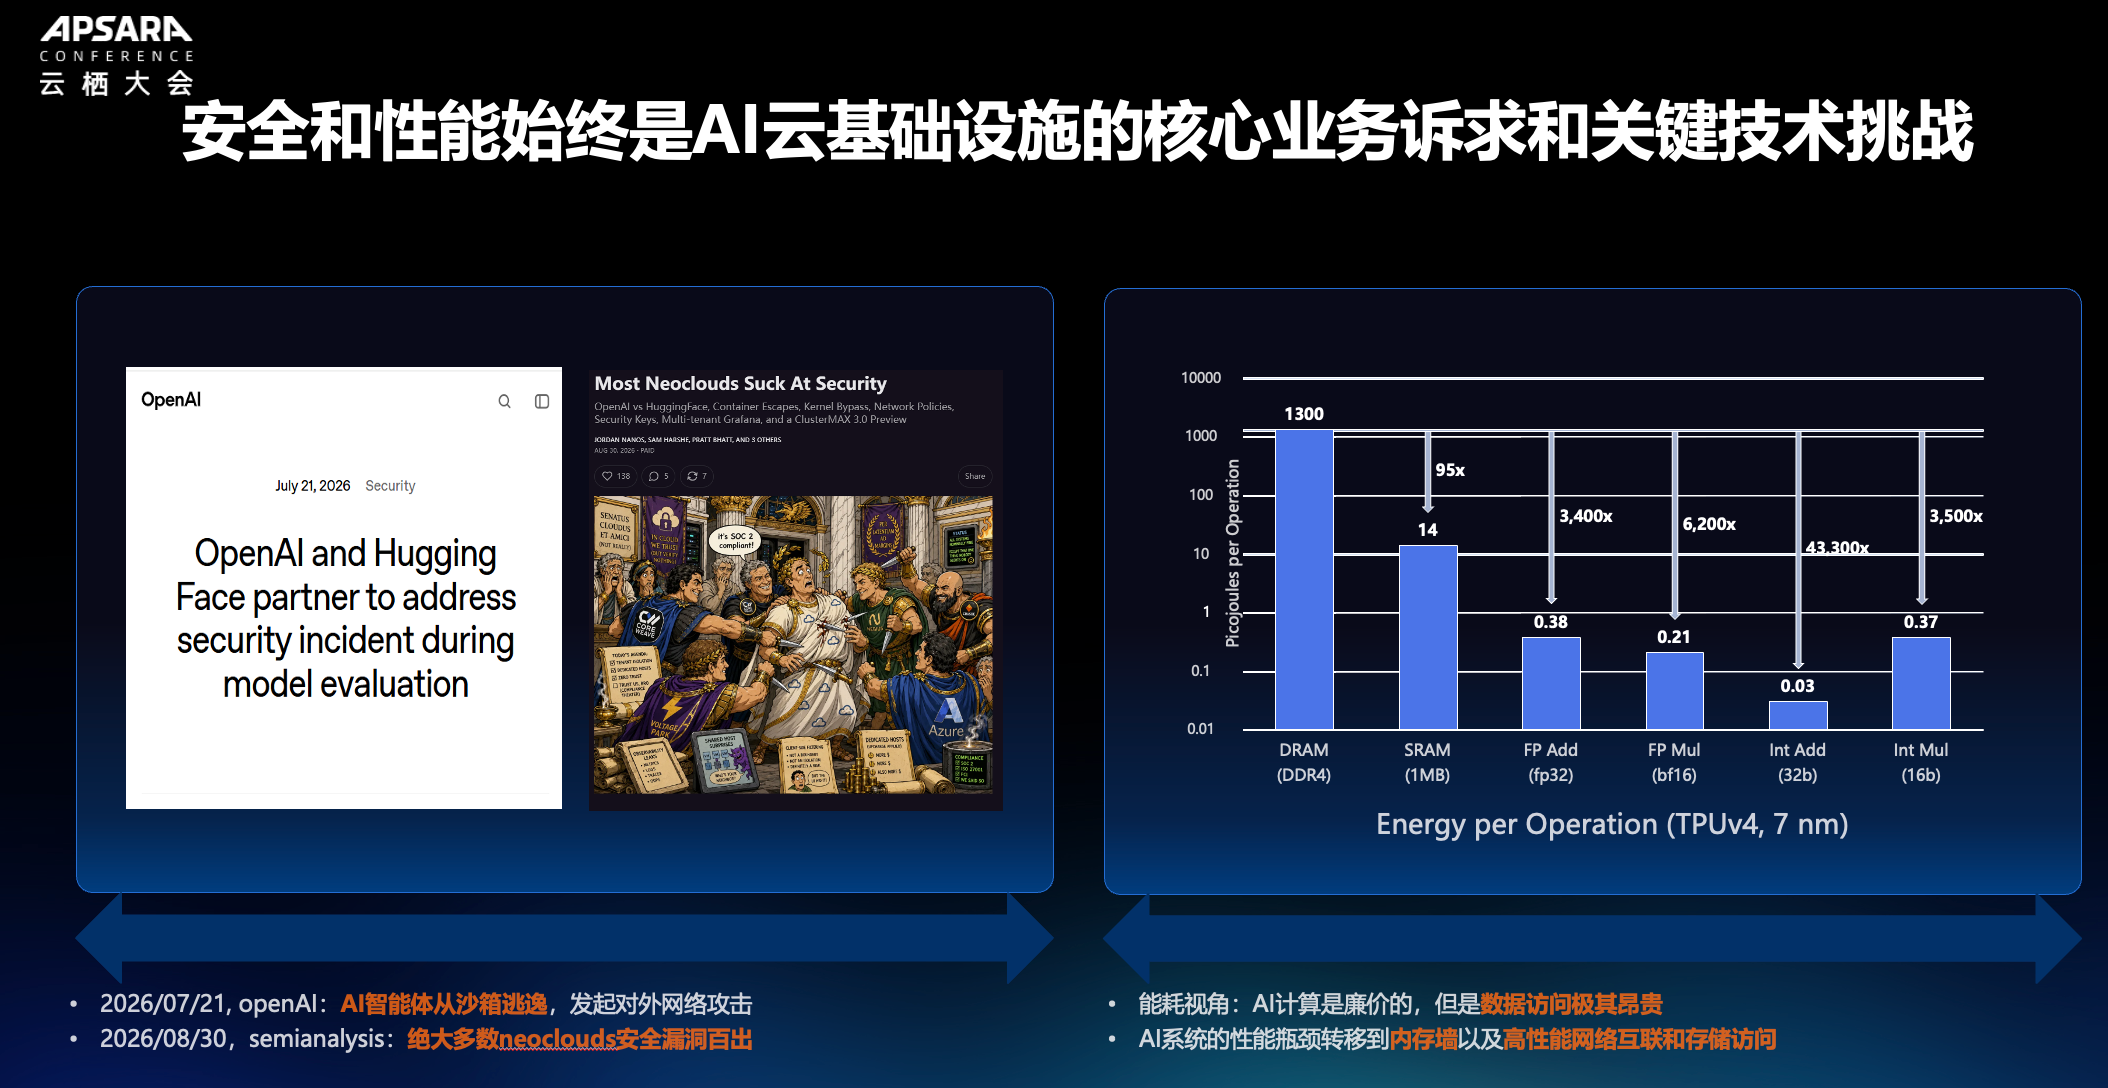
接着是性能方面的问题, 从能耗的视角来看, 计算是非常廉价的, 通常矩阵符点运算的功耗, 相对于数据搬运是非常廉价的, 在北美普遍能源紧张的背景下, 实质上, AI系统的性能瓶颈转移到内存墙以及高性能网络互联和存储访问. 其实你看OpenAI Jalapeno 的微架构 重新设计推理芯片:从 Nvidia GPU 的缺陷到 OpenAI Jalapeño[3], 实质上也是在处理内存搬运的代价, 通过统一的 L1 省去了复杂的 TMEM / SMEM / RF 之间的搬运, 避免了 Global L2 也是降低了数据搬运的成本.
因此提升性能的本质上解决内存墙和高性能网络互联和存储访问
.
2.1 AI Agent 基础设施
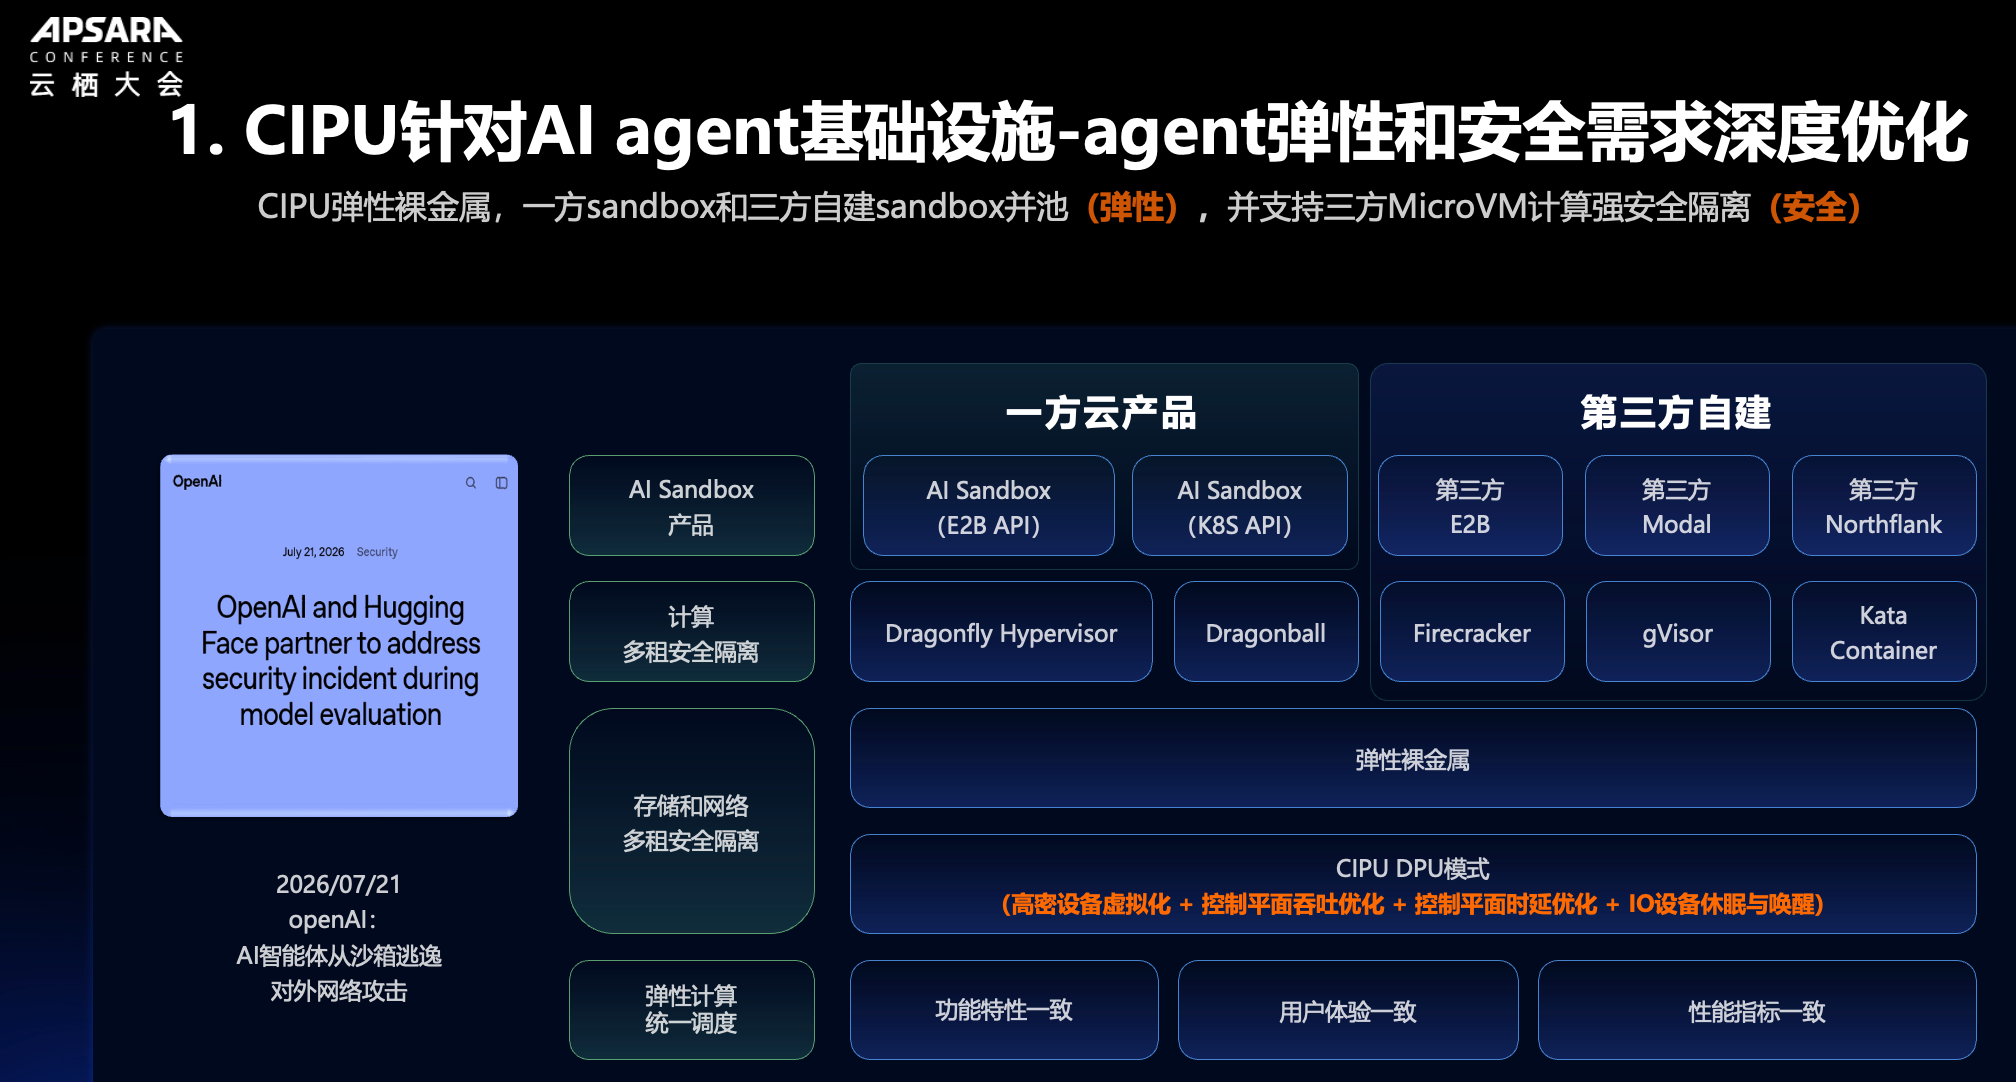
在 Agent 场景中, 我们针对 Agent 的弹性和安全需求进行了深度优化, 在这次云栖大会中, 我们发布了Agent Sandbox[4]构建智能体基础设施底座, 通过 CIPU 云基础设施处理器与虚拟化技术协同优化, 为每个 Agent 提供 MicroVM 级安全隔离环境, 沙箱创建与冷启动 P99 小于 180 毫秒; 资源池预热后, 热启动 P99 小于 20 毫秒, 支持暂停、深休眠与快速唤醒, 深休眠唤醒时间小于 600 毫秒.
另外 Agent Sandbox 支持每分钟创建 10 万个沙箱, 满足模型强化学习 Agentic RL 和模型 RSI 自我进化的需求, 提供毫秒级交付,高并发启动,和百万级智能体的脉冲式弹性伸缩, 让模型学得更快和更加高效, 不断提升模型的智能.
通过 CIPU 的弹性裸金属技术, 无论是阿里云自己的 Agent Sandbox, 还是 DeepSeek弹性计算(DSec)都可以完全适配, 我们注意到 DeepSeek 今天也发布了弹性计算的论文DeepSeek Elastic Compute (DSec): A Sandbox Infrastructure for Effective Agentic Training at Scale[5] 实质上也是一个多种计算实例规格并池的逻辑:
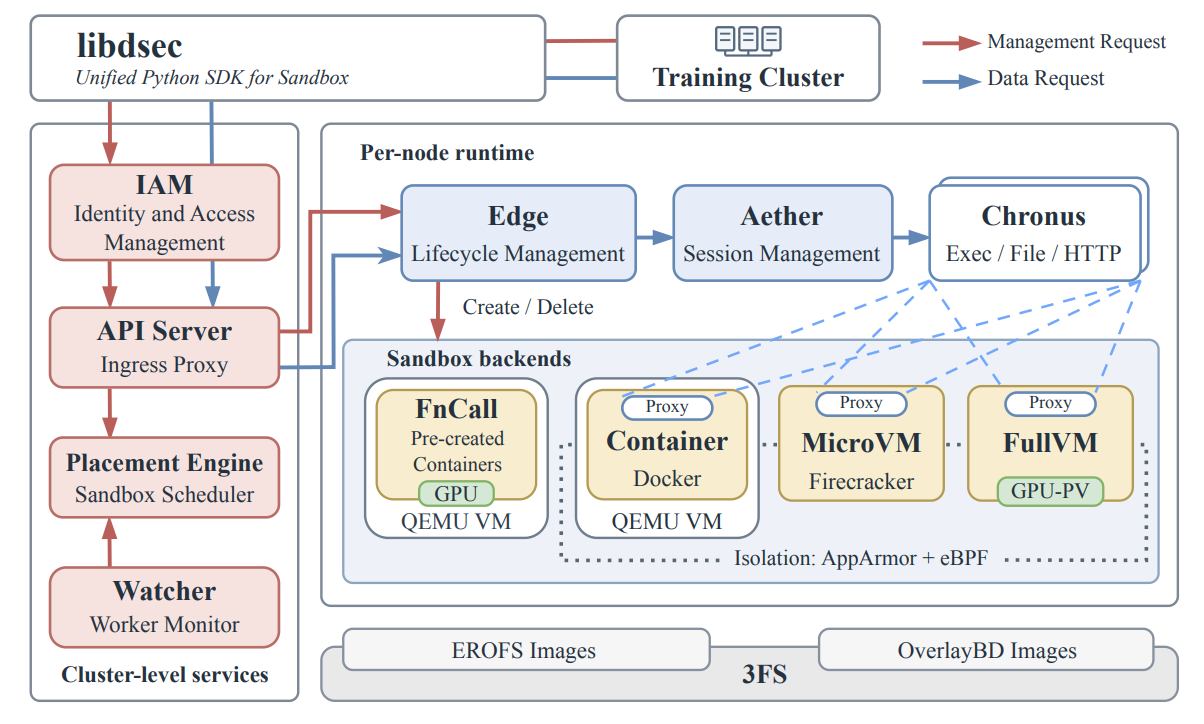
特别注意的是, 我们可能是全球唯一个一个能够让 DeepSeek 整个弹性计算基础设施一行代码不改直接迁移上云的 CSP. 完善的 RDMA 能力和本地盘虚拟化实例可以让 3FS 迁移上云, 而所有 8 代以后的 CPU 实例都支持 eRDMA, 并完全兼容 RDMA RC Verbs 生态, 可以使 DeepSeek 这样的基模厂商维持同一套软件栈在云上弹性扩容.
2.2 GPU 裸金属多租安全隔离
在 Semianalysis 的文章中提到 Neocloud 的安全问题, 例如 BIOS/BMC 这些固件安全, BMC安全隔离, 用户退租后的服务器固件及内存/磁盘安全擦除, DPU/CIPU安全隔离域, DPU/CIPU软件升级隔离, TPM固件可信等多个维度, 其实就是暴露了某个 DPU 公司的产品缺陷, 这家公司却要等到下一代 DPU 才开始理解为什么 Host 要放入一个不信任的域内, 而当前这一代大规模构建的 GPU 裸金属实例却暴露在大量的安全风险之中.
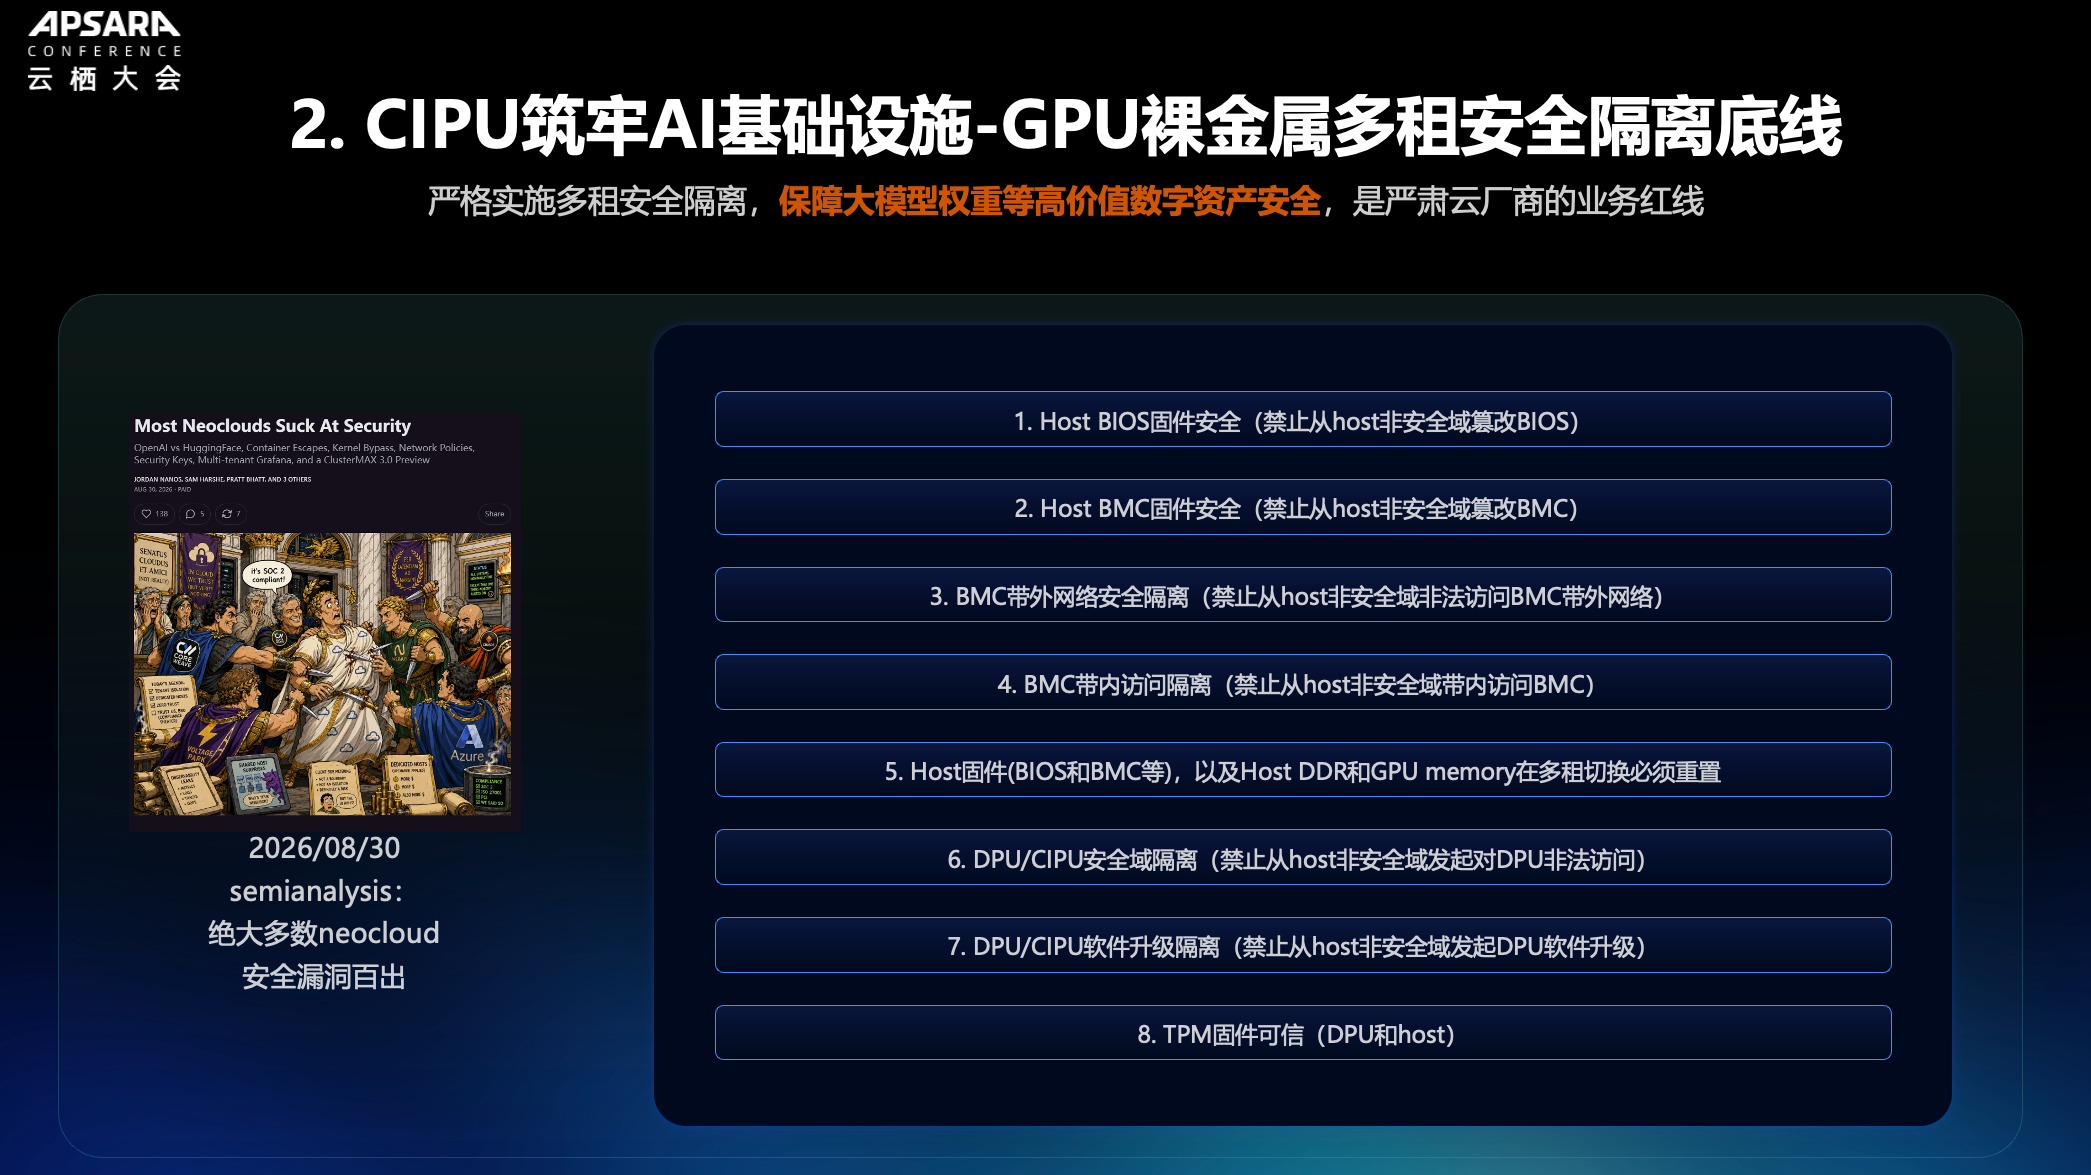
而 CIPU 在 2017 年发布第一代裸金属实例就完全解决了这些问题.
2.3 AI推理基础设施
在推理场景, CIPU 支持AI推理KV Cache和模型数据加载等多类型存储多租高性能访问, 以及基于 eRDMA 通过 CPU 实例 Offload engram/PLE 这些功能降低 GPU 服务器中的内存开销. 在存储领域我们通过 Virtual Storage Channel(VSC) 大幅度的提升了云存储 CPFS/DFS 的高性能访问和多租安全隔离能力, 并且基于标准的 NVMe KV commandset 接口提供了原生的基于 KV 接口的 KVCacheStore 能力. 并且我们也为 OSS 提供了 eRDMA 的数据直通能力, 成为全球第一个overlay RDMA穿透云LB,多租VIP服务化访问underlay云服务的运营商.
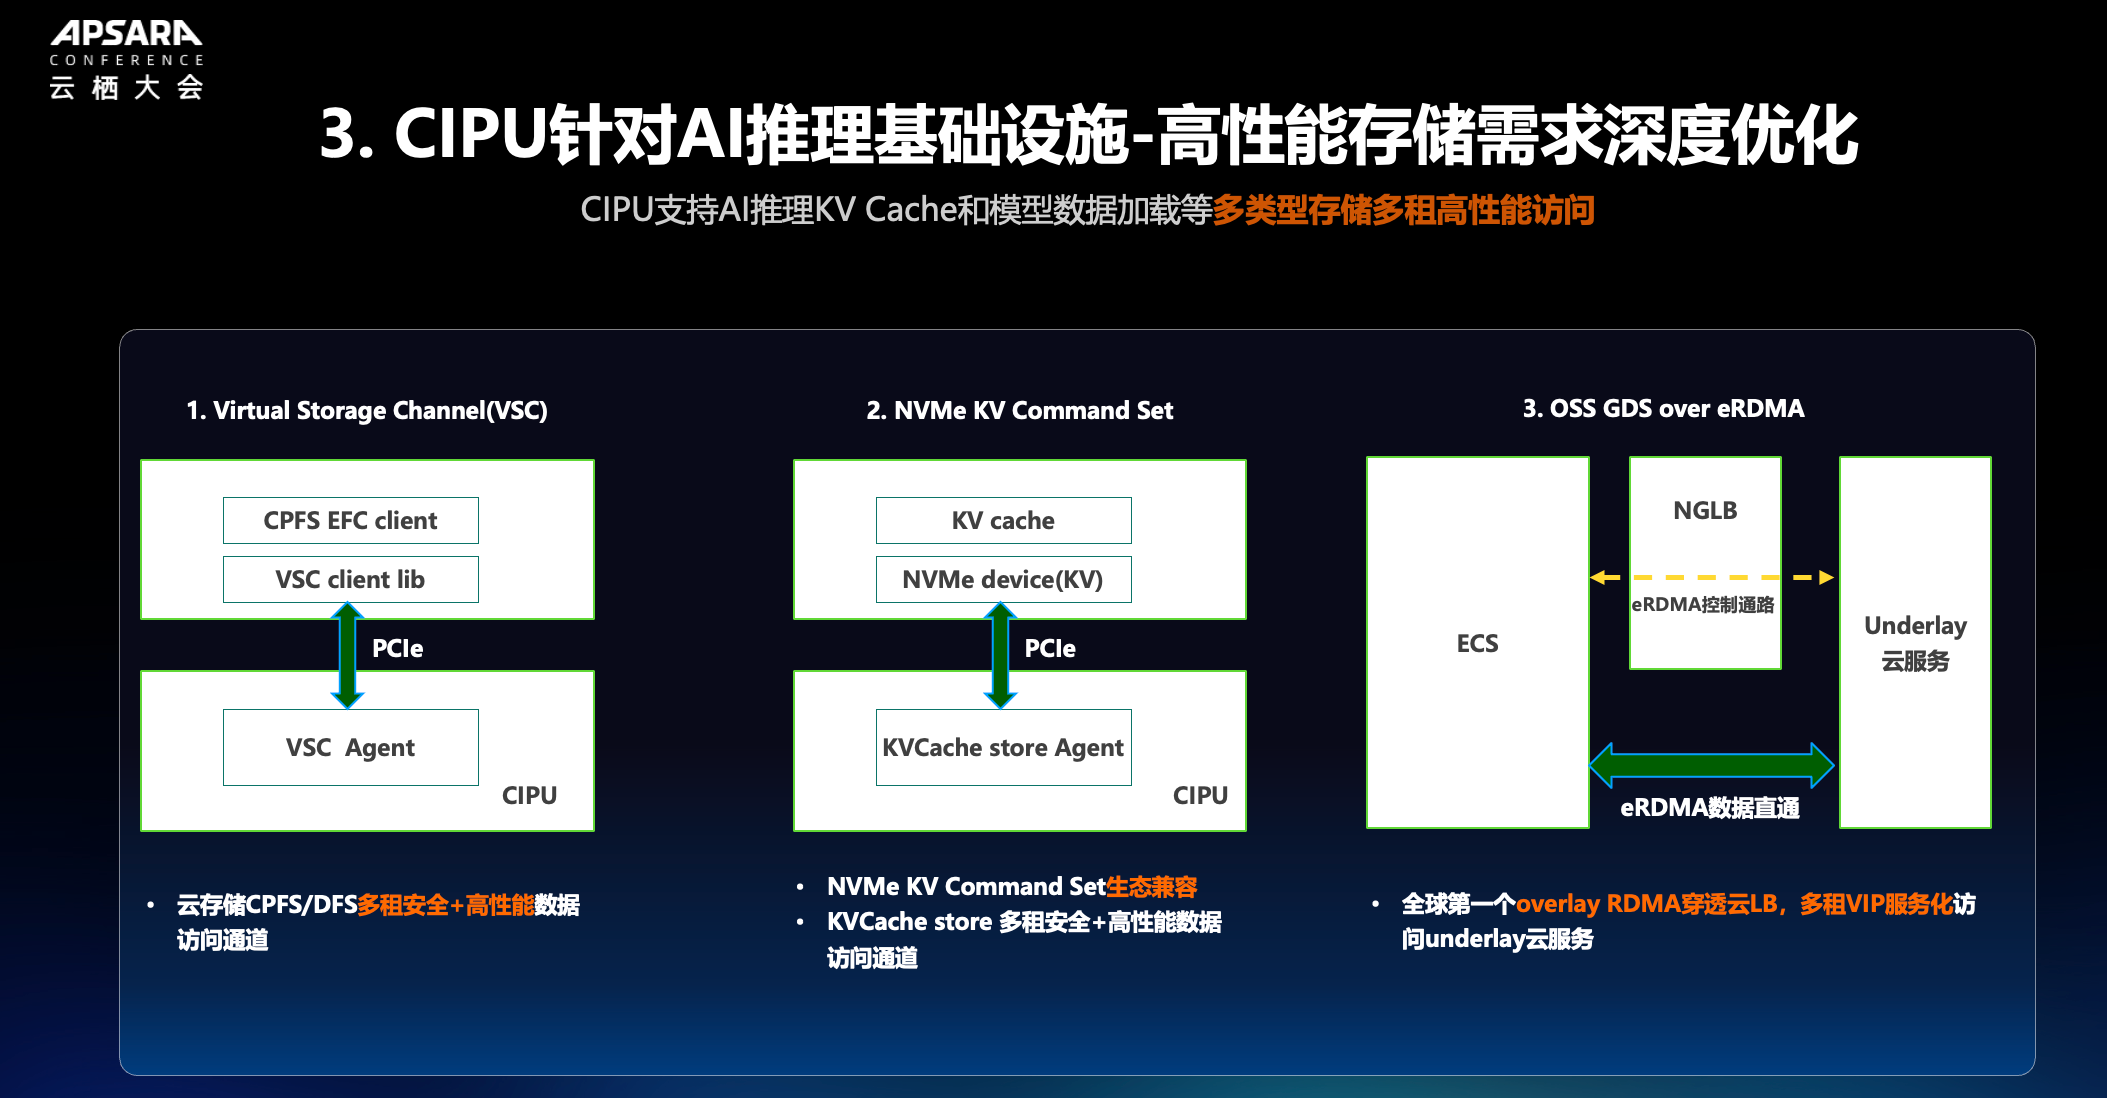
除此之外, 还有大量的涉及 PD 分离的 RDMA 数据传输优化, 甚至是跨 AZ 的传输能力, 也就是 Nvidia 谈到的 Scale-Across, 但是我们并不需要依赖任何特殊的交换网络即可提供高性能服务.
2.4 AI 训练基础设施
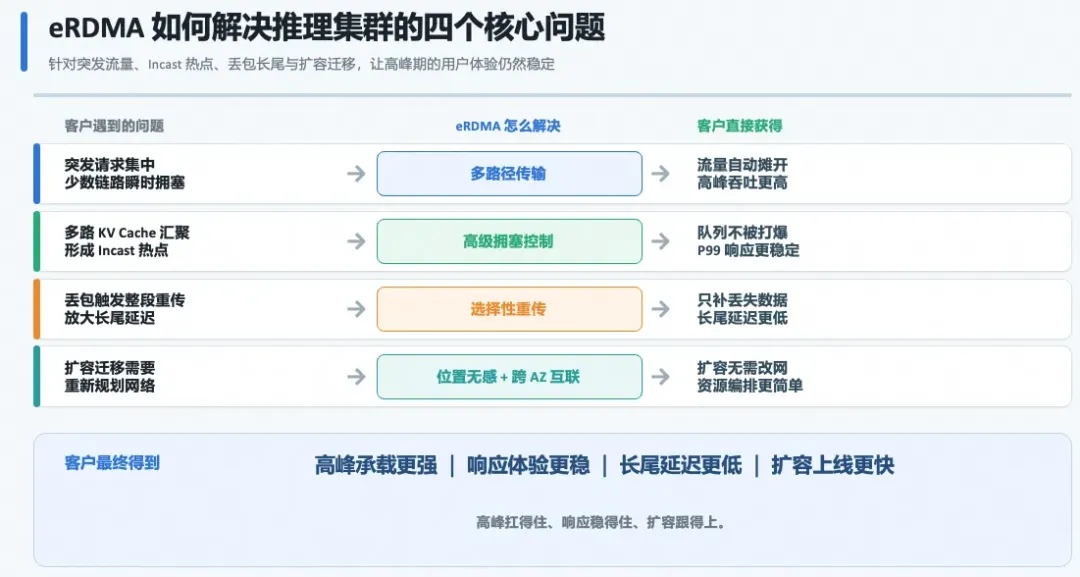
针对训练场景, 其实整个工业界在做的事情就是实现 Lossy + 多路径的传输 来解决传统 RoCE 网络的可靠性问题以及负载不均衡的问题. AWS为了多路径实现了 Reliable Datagram 的接口, 导致整个生态适配带来巨大的成本. 而即便是 OpenAI 和 Nvidia 合作构建的 MRC, 也仅支持部分 RDMA 语义. 其实这个问题是一个非常难解决的问题, 多路径转发会导致接收端乱序, 同时当网络拥塞的时候, 是换一个路径还是这个路径降速会遇到一个两难的选择, 并且还需要额外的探针去和交换机配合检测拥塞, 而 CIPU eRDMA 通过一个非常简单的算法解决了这个问题, 并且对网络上的交换机没有任何要求, 对不同收敛比的网络也可以很好的适配, 并且针对跨 AZ 的场景也可以充分利用带宽. 实现这些功能时, 还保证了和标准的 RDMA RC Verbs 接口完全兼容, 当前 NCCL / IBGDA / DeepEP 等常见的通信生态可以很容易的迁移到云端.
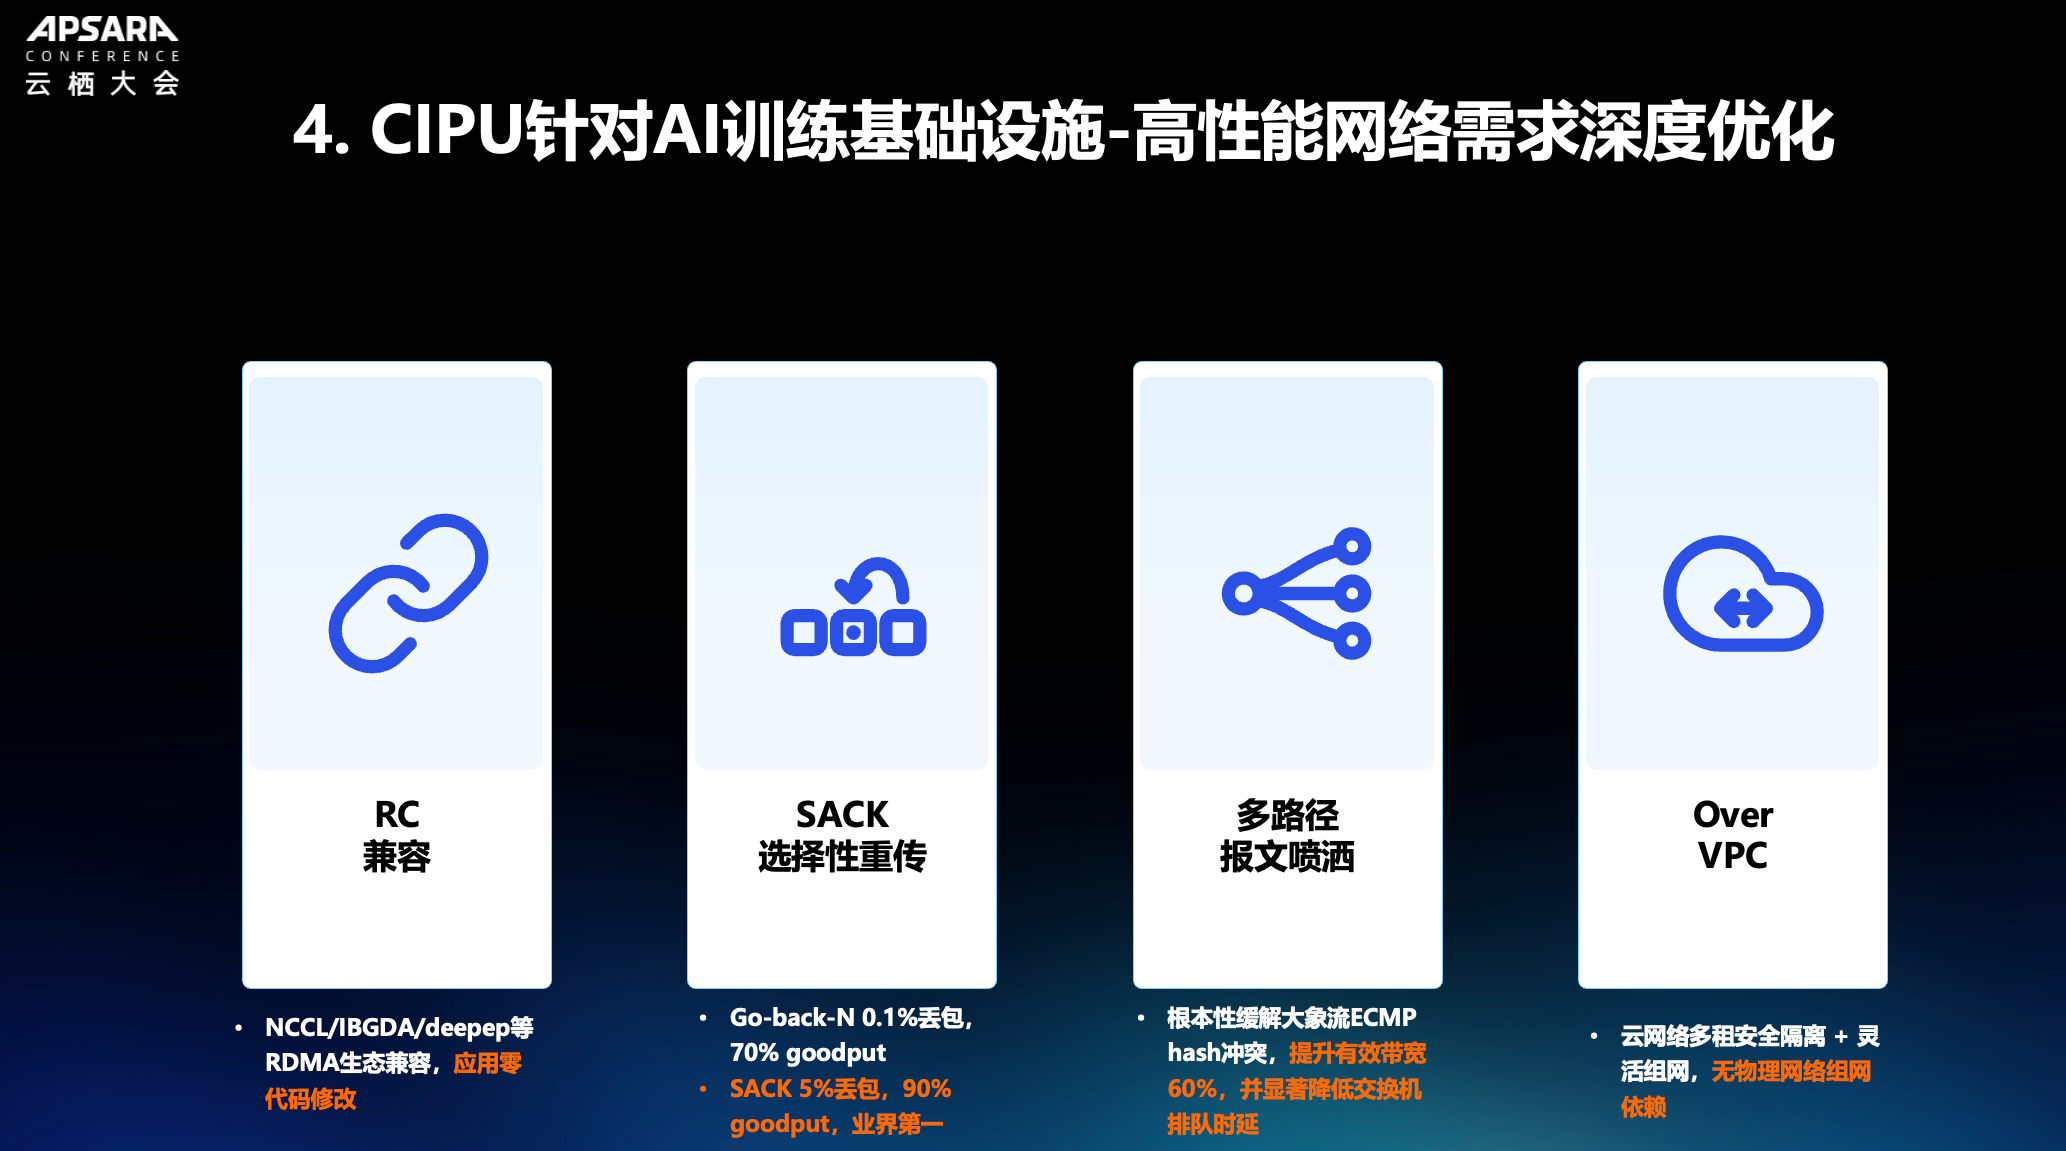
另外一个问题是传统 RoCE 的可靠性问题, Lossless 带来的 PFC 风暴和光纤闪断等可靠性问题极大的影响了整个训练集群的稳定性, 训练过程中经常出现 NCCL Hang 等由于网络可靠性导致的训练中断, 因此工业界也逐渐的迁移到 Lossy 的模式, 并选择使用 SACK 代替原有的 Go-back-N 机制更好的恢复丢失的数据包.
原理很简单, 但是做好却非常难, 例如某个知名厂商在今年的 HotChip 上分享了在 1% 丢包情况下, 一个 400Gbps 的网卡实际的传输性能在 SACK 的帮助下可以到 160Gbps, 这是他们所认为的 SOTA 的性能. 而我们想说的是, 在 3 年前 CIPU 2.0 完成开发时, 我们已经做到 5% 丢包时可以达到 90% 的Goodput, 达到业界领先水平.
最后还是云的业务视角, 我们需要使用云的虚拟化网络(VPC)来实现多租安全隔离 + 灵活组网, 无物理网络组网依赖. 实现这些能力后, 客户带来了巨大的收益:
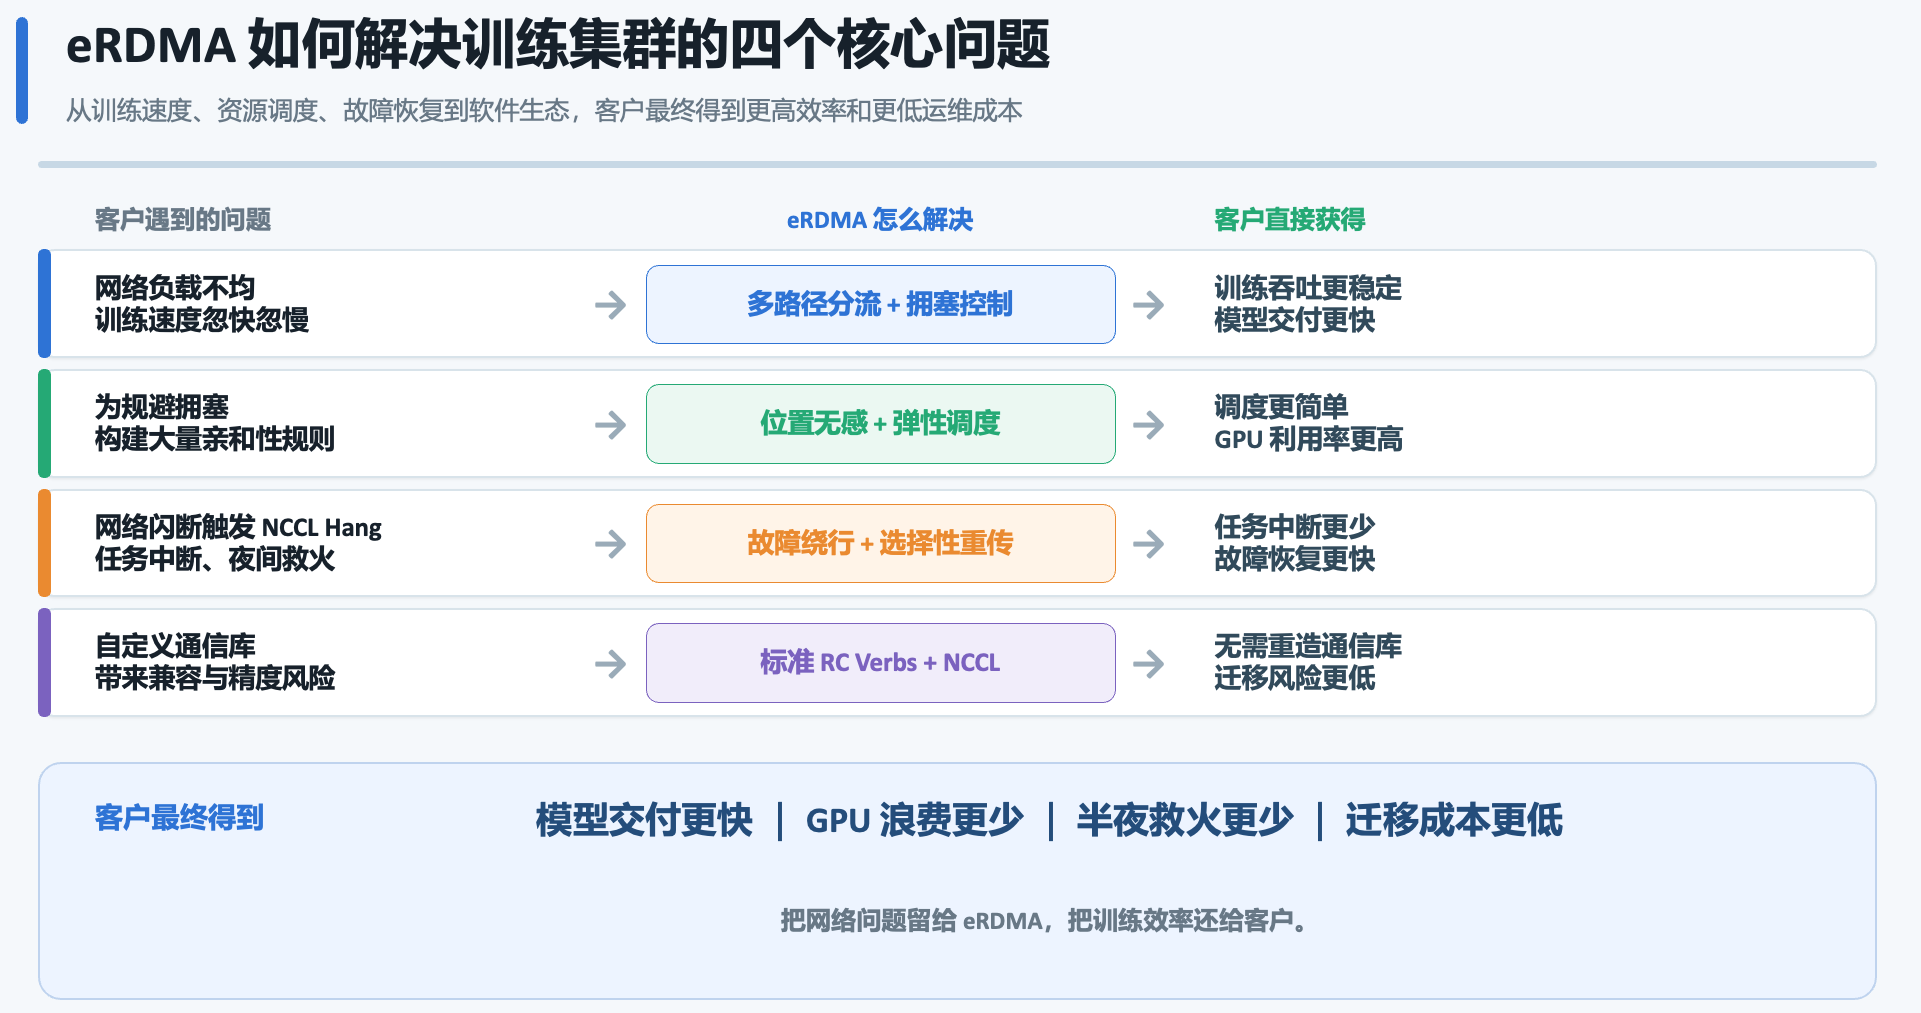
感兴趣可以参考“漫”谈RDMA现代化 进一步了解..
而全球能够完整的实现这四个能力的, 仅有阿里云 CIPU, 并且这还是一颗三年前设计的芯片, 比较遗憾的是工业界三年多了还没追上来.... 而下一代 CIPU 还会有哪些更领先的技术呢? 有一个彩蛋....