DeepSeek-V4.1 Flash:
把 KV Cache 压缩推到极致
TL;DR
DeepSeek-V4.1 Flash 发布的时候, 觉得可能就是一个后训练迭代的版本... 但是用了一下发现差不多接近 420 Tokens/s 的速度, 然后崔老师又说要下架所有的 DeepSeek-V4 Pro 的模型... 突然就觉得这事情不简单了...直到完全公开 Technical Report 《DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression》[1]才意识到它应该叫 DeepSeek-V5 Flash...
正如论文标题阐述的, DeepSeek-V4.1 Flash 的目的就是把 KVCache 的压缩推到极致. 主要的原因就是 Long-horizon 的 Agent Workflow 导致 Context 越来越长, 同时各种工具调用带来的 prefill 计算压力很大. KVCache 在 HBM 和外部 SSD 中的存储压力很大, 这些都是导致无法 Scale 的原因. 因此模型模型结构上做了一系列优化, 特别是在对KVCache的压缩和 Prefill的算力优化.
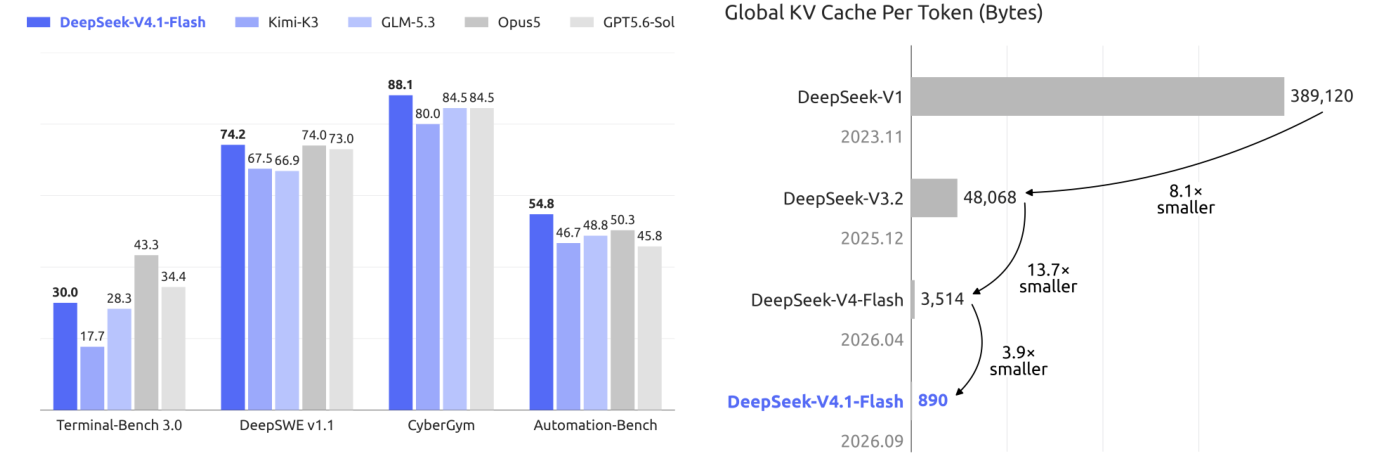
Prefill算力优化 : 借鉴了YOCO, 整个模型 40 层, Prefill时仅需要 20 层. 因此 Prefill 激活参数仅 8B, Decode 激活参数 16B KVCache 压缩 : 工程上把 KVCache 压缩分为几个维度: 类似于 GQA 的头数量压缩, 然后是 CSA 这样基于 block 的压缩以及本文的 CSA2 进行跨层的压缩. 同时还对Sparse Attention 的 indexer 计算进行了优化. 最后是一些数值精度的优化, 例如 DS41F 采用了 FP4 的 KVCache.
最终在维持模型高质量完成任务的前提下, KVCache 进一步压缩了 4 倍:
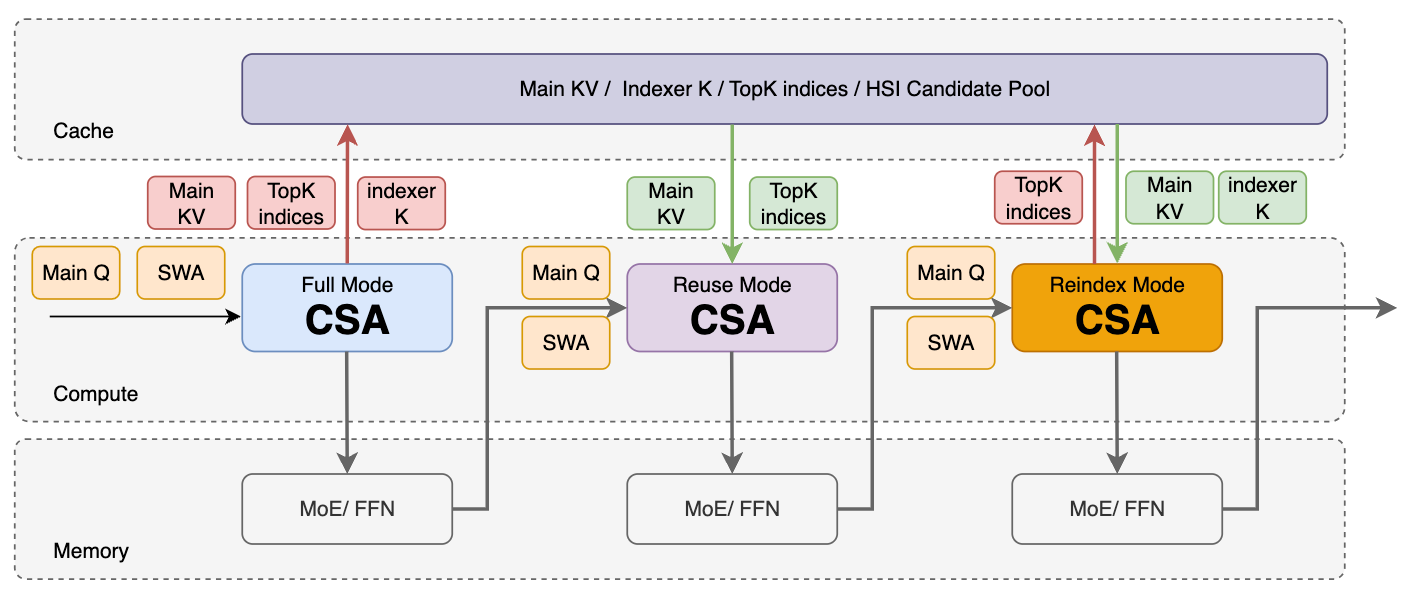
另外论文原始的撰写还是有些复杂的, 特别是 CED 的描述, 实际上如果我们以 KVCache 为中心并结合计算机体系结构的视角重新画一个图, 似乎就豁然开朗了, 它可以看做是一种 Recursive Transformer 的架构, 在递归的过程中修改 Q 并复用 KV 的方式.
关于Recursive Transformer 的架构, 可以参考《谈谈未来的Transformer: Loops Are Not What You Need》, 接下来我们将按照技术报告的章节结构进行详细的解读分析, 本文是这个系列的第一篇详细分析模型结构, 比较关键的内容是第三章.
1. Overview
1.1 为什么需要压缩 KVCache
首先报告阐述了近年来 Long-horizon Agent 使超长上下文(ultra-long-context)处理成为越来越重要的模型工作负载. 支持这类工作负载不仅需要高效处理长序列, 还需要对大型 KVCache 进行持久化存储、复用和传输. 因此, KVCache 管理已经成为模型部署的一项基础能力, 同时也在计算、存储和通信方面带来了重大挑战.
然后展开介绍了 DeepSeek-V4 架构, 它通过一个完全覆盖上下文的 Sparse Attention 与一个覆盖局部窗口的滑动窗口 Attention(SWA)结合的方式来进行处理. 虽然 Sparse Attention 相关的进展已经显著降低了长序列处理的计算成本, 使持久化存储和数据搬运逐渐成为更加突出的瓶颈. 长上下文中 Global KV Cache 的用量 将占据主导地位, 并且为了前缀复用而被持久化, 它会大量占用 Host 内存容量和 SSD 容量, 并且也会对 KVCache 搬运的互联带宽带来很高的需求. 这些限制了服务的吞吐, 提高部署成本, 最终阻碍智能体向更长任务跨度和更广应用场景部署与推广.
因此, 进一步减小键值缓存占用, 对于缓解存储和通信瓶颈以及降低长上下文服务成本至关重要. DeepSeek-V4.1-Flash 是一个面向更激进 KVCache 压缩设计的多模态混合专家模型. DeepSeek-V4.1-Flash 参数规模 552B , 原生支持多模态输入, 并支持最长达 100 万 token 的上下文. 它采用因果 Encoder - Decoder (Causal Encoder-Decoder, CED)架构, 其中 Decoder 的 Global KVCache 由 Encoder 最终隐状态投影得到. 这一设计使模型在 Prefill 阶段每个 token 激活 8B 个参数, 在 Decoding 阶段激活 16B 个参数, 对输入占主导地位的 Agent 场景尤其具有成本效益. 尽管 DeepSeek-V4.1-Flash 明显大于 DeepSeek-V4-Flash, 在相同序列长度下, 它所需的运行时 KVCache 存储量只有后者约 1/4, 持久化 KVCache 存储量只有后者约 1/8. 此外, DeepSeek-V4.1-Flash 的整体性能优于 DeepSeek-V4-Flash.
这些针对 KVCache 的压缩主要来自模型架构、缓存精度和部署策略的联合优化. 对于 DSv4 它是一个以 SWA 为骨架然后配合全局的压缩注意力(CSA/HCA)增强的模型. 基于这个视角, DeepSeek 团队进行了一系列优化, 首先值得注意的是它们放弃了 HCA 那样分块的高压缩比结构, 转而对 CSA 进行更多的优化, 构成了 CSA2. 主要优化从三个维度压缩 KV Cache:
在通道维度, 用512维潜在向量共享表示各注意力头所需的键和值; 在序列维度, Encoder 通过逐通道学习权重将相邻2个位置合并为1条缓存, Decoder 保留逐位置条目; 在层维度, 多层共享同一份全局 KV, 全网只保留3份 Encoder 缓存和1份 Decoder 缓存.
再结合FP4量化, 全局主KV与 Indexer 的存储增长约为每 token 890字节.
1.2 模型结构概述
整个模型结构如下:
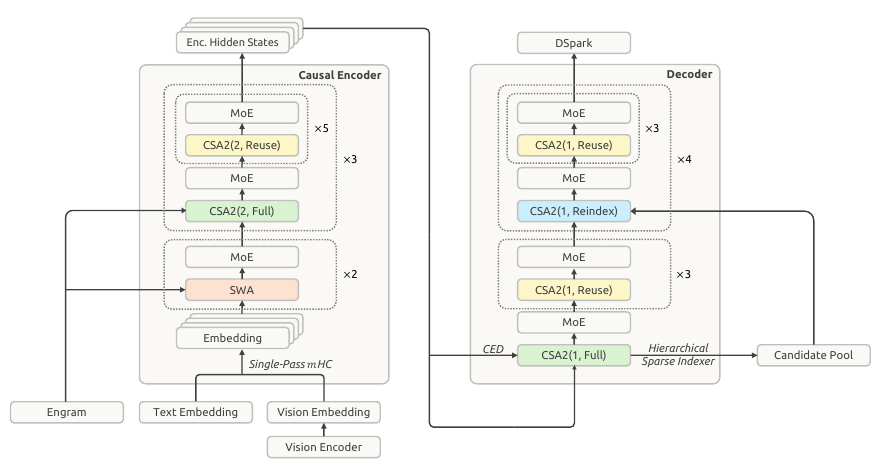
论文报告主干参数约 , Engram 参数约 , prefill 和 decode 每 token 激活参数分别约为 和 .核心是用 CED 降低长上下文 Prefill 计算, 用 CSA2 降低注意力和 KV 缓存开销, 再结合 Engram 条件记忆与 DSpark 推测解码.
模型共 层, 隐维 , 词表大小为 . 每层包含注意力和 MoE, 通过 mHC 残差连接组织. 整个注意力机制分为 Encoder 和 Decoder 两个模块, 构成因果 Encoder - Decoder (Causal Encoder-Decoder, CED)架构, CED 的关键是** Decoder 的全局 KV 来自 Encoder 末端表示**, 后续 Decoder 层共享这些 KV. 因此, 长 prompt 的大部分位置只需经过前 20 层,
其中关键的 CSA2 采用局部滑动窗口 + 全局稀疏检索 + KVCache 跨层复用 的机制, 滑动窗口大小为 128, 注意力使用 个 Q 头, 共享 维 KV latent, 其中 RoPE 为 维, NoPE 为 维. Q 采用秩 的低秩投影, 输出投影分 组, 每组秩 . 整个模型的相关参数如下:
| 类别 | 字段 | 值 | 含义 |
|---|---|---|---|
| 主干 | dim |
5120 | 隐维 |
n_layers |
40 | 前 20 层为 Encoder 后 20 层为 Decoder |
|
n_mtp_layers |
3 | DSpark 三个 SWA-128 block | |
vocab_size |
129280 | — | |
| 注意力 | n_heads |
64 | |
head_dim |
512 | Latent 维度 | |
rope_head_dim |
64 | RoPE 分量维度 NoPE 分量 |
|
q_lora_rank |
1280 | ||
o_lora_rank /o_groups |
1024 / 8 | 输出投影分 8 组, 每组秩 1024 | |
window_size |
128 | SWA滑动窗口 | |
| CSA2 | compress_ratios |
[0,0, 2×18, 1×20, 0,0,0] |
Encoder层压缩比为 2 Decoder层压缩比为 1 |
kv_source_layers |
[2,8,14,20] |
Full 模式层 | |
index_source_layers |
[2,8,14,20,24,28,32,36] |
Full + Reindex 模式层 | |
index_n_heads /index_head_dim |
32 / 128 | indexer 规模 | |
index_topk |
512 | Top-K数量 | |
candidate_source_layer |
20 | 候选池构建层 | |
candidate_topk_blocks /candidate_block_size |
2048 / 8 | 候选 | |
| RoPE | original_seq_len |
65536 | |
rope_factor |
16 | ||
rope_theta /compress_rope_theta |
10000 / 160000 | ||
| MoE | n_routed_experts /n_activated_experts |
384 / 6 | Top-6 of 384 |
moe_inter_dim |
2304 | 专家中间维 | |
score_func |
sqrtsoftplus |
继续沿用 sqrtsoftplus | |
route_scale /swiglu_limit |
1.5 / 10.0 | — | |
| mHC | hc_mult |
4 | 条残差流 |
hc_sinkhorn_iters |
20 | sk迭代 20 次 | |
| Engram | engram_layer_ids |
[1, 14] |
第 1 层与第 14 层注入 |
engram_num_embeddings |
[384006168, 384016682] |
两张表的行数 | |
engram_max_ngram_size /engram_n_heads |
4 / 8 | N-gram 阶 , 8 头 | |
engram_head_dim |
256 | , 每阶总嵌入维 2048 |
|
engram_vocab_size |
16000000 | 约 16M 条目 | |
| DSpark | dspark_block_size |
5 | Draft |
dspark_target_layer_ids |
[37,38,39] |
||
dspark_n_routed_experts |
128 | 草稿层用更小的 MoE | |
| 视觉 | vision_n_layers / vision_dim |
32 / 1024 | — |
vision_patch_size /vision_downsample_ratio |
14 / 3 | 3×3 下采样 → 9 倍 token 削减 | |
vision_max_n_token |
1024 | 单图 token 上限 |
其中:
mHC:每个 token 维护 条 维残差流. 残差混合矩阵通过 次 Sinkhorn 迭代约束为近似双随机矩阵. Single-Pass 的关键是使用前一个子层产生的输入混合系数, 解除当前系数计算的依赖, 便于融合 kernel 并减少内存读写. DSpark: 额外的 个 SWA-128 草稿 block, 每层采用 个路由专家中的 Top-3 的小规模MoE. 读取主干网络层号 入口处四条残差流的均值, 一次并行计算 个草稿位置, 配合 Markov head 建模依赖, confidence head 辅助决定验证长度. 视觉分支: 层, 隐维 的 ViT, patch 大小为 . 特征经过 pixel-unshuffle, token 数减少至原来的 , 再由 MLP 映射至 维并插入文本序列, 单图最多 个视觉 tokens.
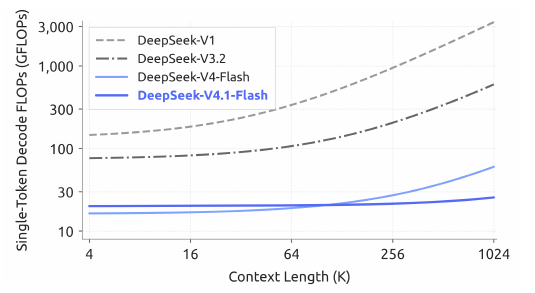
关于 CED 和 CSA2 我们将在第二章详细展开介绍, 最终所需要的算力随着 Context 增长, DeepSeek V4.1 Flash 在 1M 范围内几乎为线性增长, 算力开销远小于前几代模型
2. 模型架构
2.1 多模态架构
DeepSeek-V4.1-Flash 的视觉路径可以概括为: 在较细的图像 patch 网格上完成视觉编码, 把相邻特征重排为较少的宽向量, 再投影到语言主干的输入空间. 其中:
vision_patch_size=14: 是原始图像的 patch 大小vision_downsample_ratio=3: 是 ViT 输出特征网格的合并范围
整个处理流程如下图所示, ViT先在高分辨率特征上完成图内的交互, 在通过空间重排和压缩投影送入 LLM.
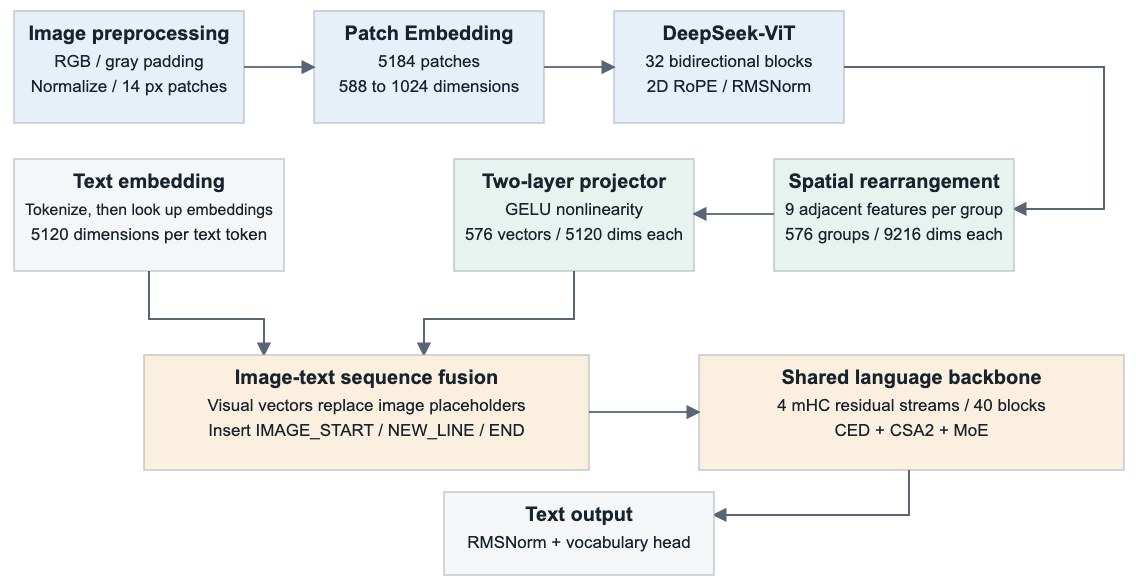
上图为一个预处理 padding 后的 1008 x 1008 像素的方图为例:
| 阶段 | 操作 | 示例形状 | 说明 |
|---|---|---|---|
| 图像预处理 | RGB, 尺寸规划, resize/pad, 归一化 | 保留二维布局 | |
| 切分 patch | 不重叠的 块 | 网格为 | |
| Patch embedding | 展平后线性投影 | 每个 patch 独立使用同一组权重 | |
| DeepSeek-ViT | 32 层双向视觉 Transformer | 保留所有 patch 位置, 无 CLS 汇聚路径 | |
| 空间重排 | 非重叠分组 | 网格由 变为 | |
| 两层 projector | Linear, GELU, Linear | 中间层也是 维 | |
| 图像 span 组装 | 插入行分隔及起止标记 | 包含 个位置 | |
| 图文融合 | 与文本 embedding 按原始顺序交错 | 包括文本和全部图像 span | |
| mHC 扩展 | 建立 4 条残差流 | 每个位置进入共享语言主干 | |
| 语言主干 | 40 层 CED/CSA2/MoE | 隐状态维保持不变 | 最终通过词表头输出文本 |
图像预处理 : 需要注意的是它并没有执行 OCR 一类的文本识别. 文件加载后直接通过load_image 解码并转换为 RGB. 然后检查最小像素面积. 若原图面积低于 , 便按比例放大目标尺寸. 随后把两条边通过向上对齐到 vision_patch_size=14 的倍数, 对齐空白处补 RGB 灰色. 并且注意, 它检查展开后的图像 span 是否超vision_max_n_token=1024预算. 超预算时, 根据宽高比重新求一个更小的目标画布.
设预处理后的像素尺寸为 , patch 边长为 , 空间合并因子为 . 代码先使像素边长成为 的整数倍:
Aligner 允许 patch 网格不能被 3 整除, 因为它会在特征网格右侧和底部补零:
合并后的视觉网格及其内容 token 数为:
而本地预处理函数实际预算的是:
其中每行一个 IMAGE_NEW_LINE, 再加 IMAGE_START 和 IMAGE_END.
对于论文中"supporting input resolutions up to approximately 1344 ×1344 pixels" 实质上是受到 vision_max_n_token=1024 约束. 例如按照论文中的 , , 然后后续的 downsampling 后的 token 数为 1024, 但是考虑span 内加入标签会超过 vision_max_n_token=1024预算, 因此这个图会被缩放到 , 即 个token, 再加上 31 个 NL 标签和 2 个 START/END标签, 总计 994 个 token.
而常见的屏幕分辨率 等分辨率会被缩放到 , 共计 968 个 token.
然后会根据 RGB 通道进行图像归一化为:
继续以 的图为例, 代码随后把图像切为不重叠的 块. 若图像块行列坐标为 , 块内坐标为 , 它取出的值就是 . 先遍历一行内的列, 再进入下一行, 得到 个图像块, 形状为 . 切块把空间坐标改写为块编号和块内坐标.
Patch Embedding: 每块的全部 个数,然后将每块展平, 所有块共享同一个带偏置的线性层. 最终得到一个 的矩阵, 注意论文中阐述了为什么需要将卷积替换为线性投影, 主要原因是确保与 Muon 优化器兼容.
DeepSeek-ViT: 接下来进行 32 层的 ViT 处理使它们获得图内上下文. 输入和最终输出都为 ,每层先对当前特征做 RMSNorm, 再计算注意力并加回残差; 随后再次归一化, 执行 SwiGLU 前馈网络并加回残差. 32 层结束后还有一次视觉塔末尾的 RMSNorm.
以其中一层的注意力为例, 一个线性层先从归一化特征生成 Q, K, V, 总输出宽度为 . 三者分别整理为 , 也就是 16 个头, 每头 64 维. 在计算分数之前, 2D RoPE 按原来的 行列坐标旋转 Q 和 K, 不旋转 V. 注意力解决的是跨位置交流, 随后的 SwiGLU 主要在每个位置内部做通道变换. 它先投影为 维并拆成两支, 对门控支施加 SiLU, 与另一支逐元素相乘, 再投影回 1024 维. 这样一层同时包含 "向其他位置取信息" 和 "在本位置重新组织特征" 两种处理.
空间重排: 它将 9 个相邻特征装入同一个宽向量, 并采用 下采样, 具体做法如下:
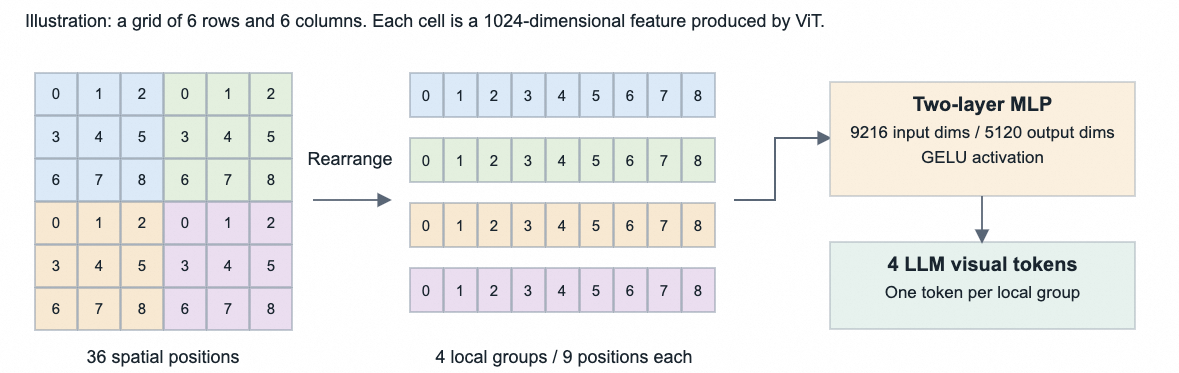
2-Layer MLP: 用于生成为和 LLM 的 token, 对齐 hidden_dim = 5120.
最后图像生成的token span 内还需要补充一些标记, 如下图所示:
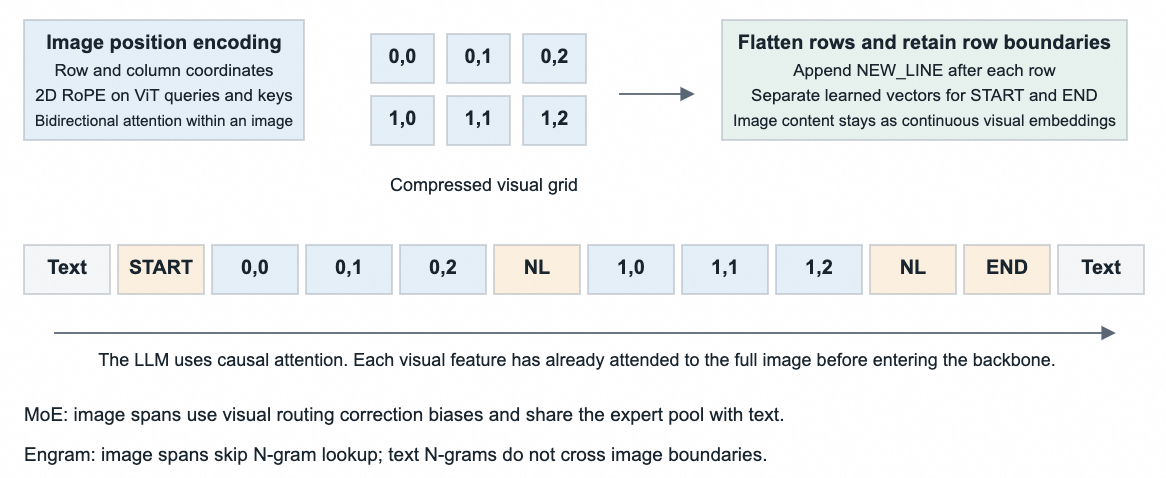
然后这些 token 将会送入到主干网络, 这里还有一个优化 用于 MoE 的多模态无辅助损失负载均衡. 图像和文本词元表现出不同的表征分布, 并可能在 MoE 中形成不同的专家路由偏好. 因此, 平衡其汇总负载可能掩盖各模态内部的不均衡. 为解决这一问题, DeepSeek 团队为文本和图像词元分别维护一组逐专家校正偏置. 路由时, 每个 token 使用所属模态对应的校正偏置进行专家选择, 同时保留原始路由分数, 用于对选中专家的输出进行加权. 每个训练步骤结束后, 根据各自的专家负载, 独立更新这两组偏置. 这种设计在每种模态内部平衡专家使用情况, 有助于稳定而高效的多模态训练.
2.2 Causal Encoder-Decoder(CED)
2.2.1 为什么需要CED ?
实质问题是在 Agent 工作流中, 频繁的工具调用将会产生大量 prefill 请求, 当 KV Cache 未命中时会造成沉重的计算开销.
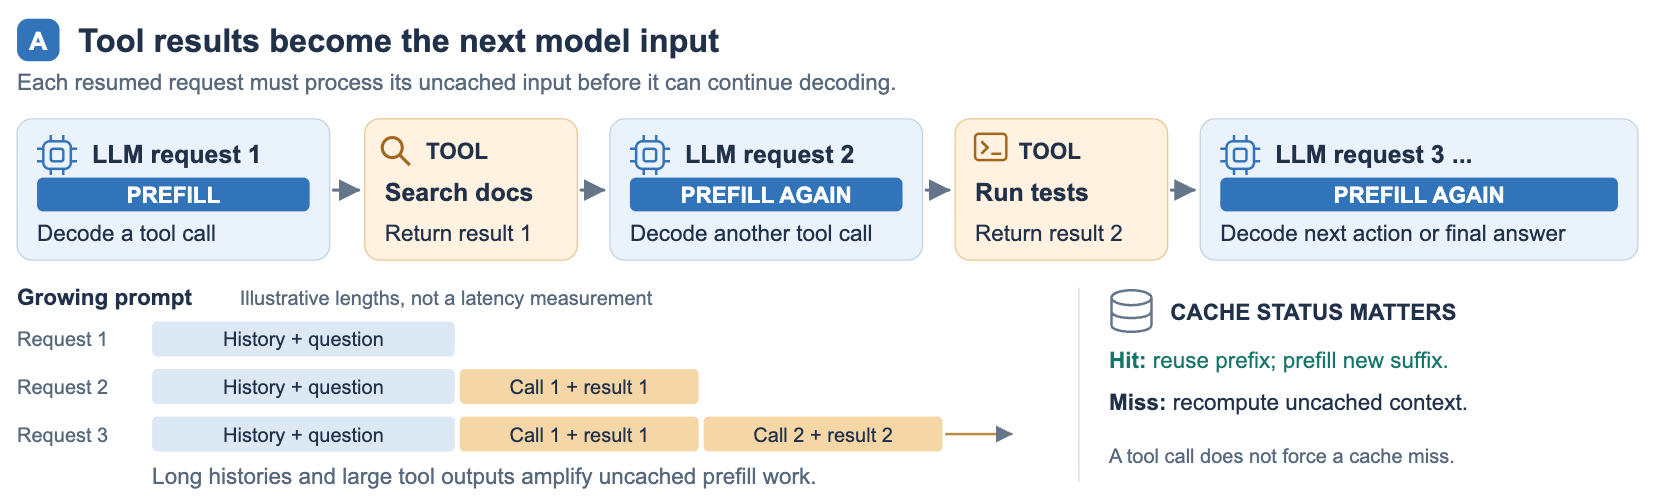
为缓解这一 prefill 瓶颈, 作者提出受 YoCo 《You Only Cache Once:Decoder-Decoder Architectures for Language Models》[2] 启发的因果 Encoder - Decoder (CED)架构. YoCo 通过让上半部分层直接共享下半部分层产生的 KV Cache 来减少 prefill 计算.
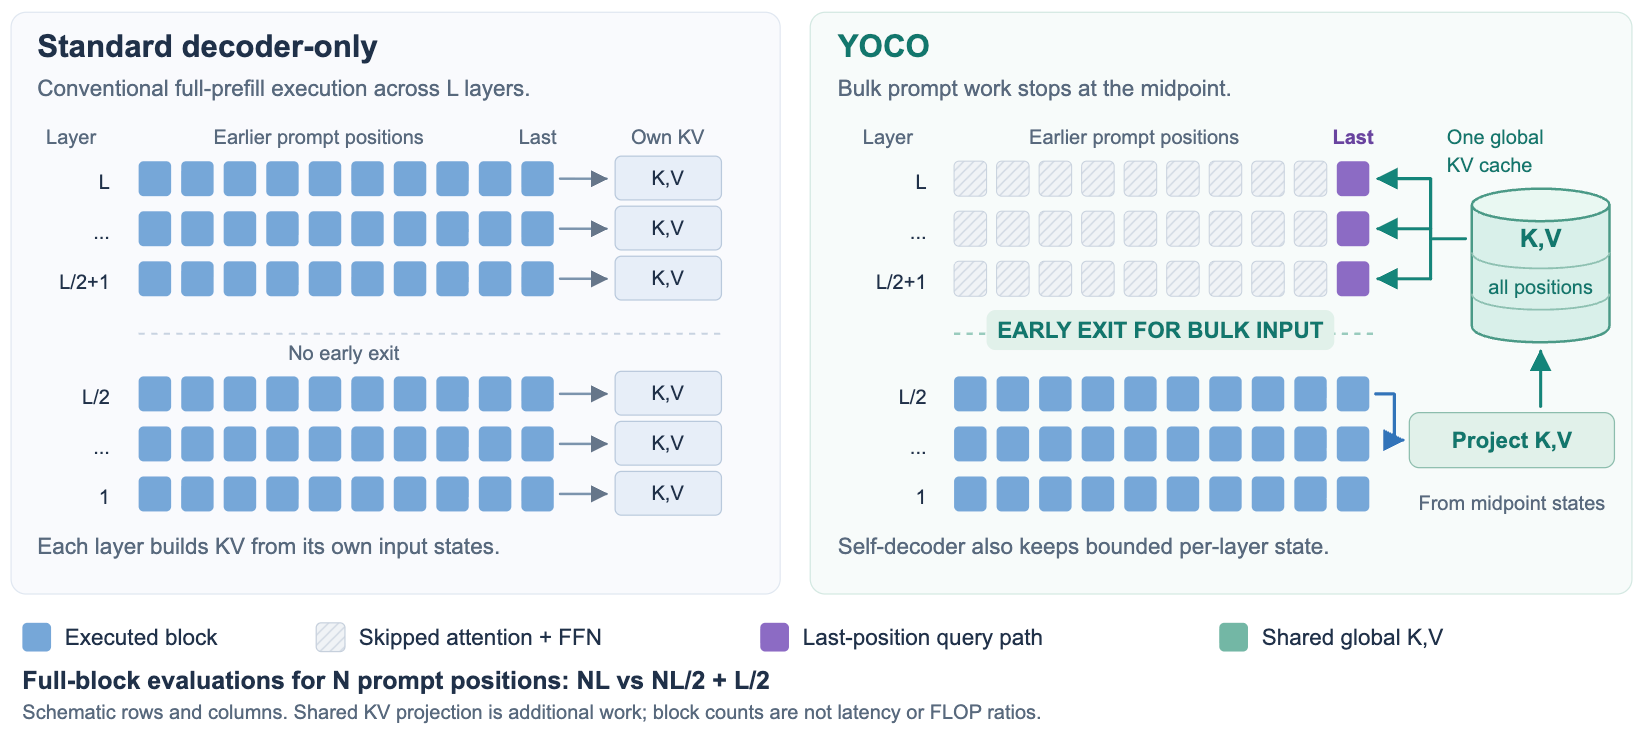
具体的实现上, YoCo 把历史记忆的生产与消费分开: 下半部分建立记忆, 上半部分反复读取记忆, 但不再生成后续推理必须保存的逐层历史 KV.
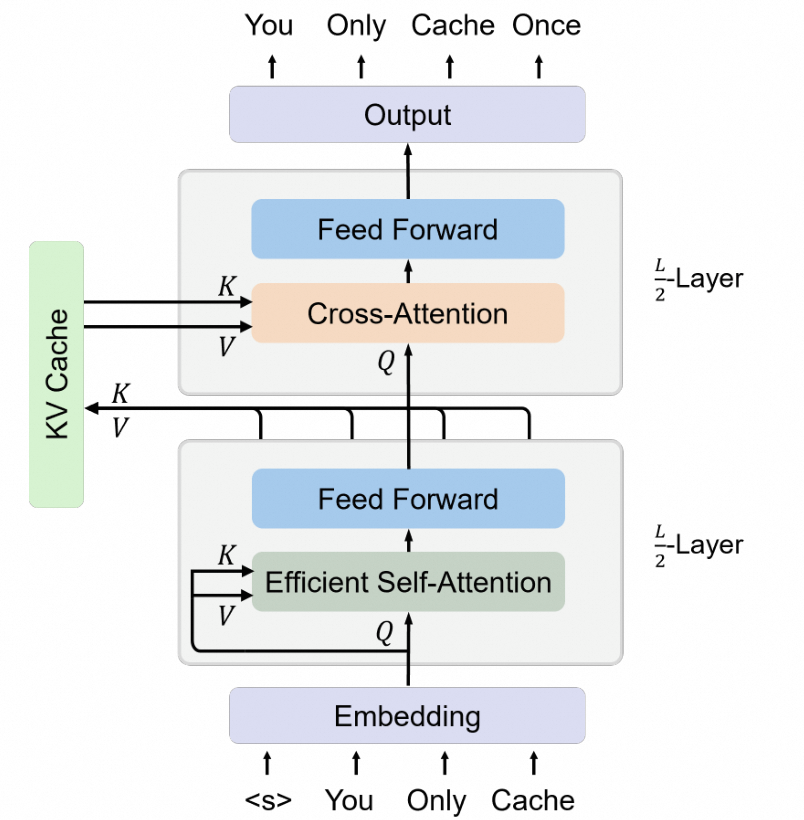
这里稍微展开阐述一下 YoCo 的整个架构演进过程. 首先 Decoder-Only 的模型每层的注意力机制使得 Prefill 时每层都有 KV 的计算, 这是导致效率低的根源.
第一个中间方案是用 SWA 算法, 通过固定的滑动窗口, 每一层产生 的 KV, 也就是 YoCo 原始论文中所谈到的 Efficient Self-Attn(ESA), 但是如果全部的层都用了 SWA 将会丢掉了全局的注意力机制(注: 原论文中ESA可选 SWA 也可以选择 gRet..). 另一种方案就是把整个模型从深度上分开, 前半段使用 ESA 产生全局 KV, 后半段采用标准的 Attention 读前半段的 KV 这样就可以恢复全局注意力机制. 但是我们需要确定后半段的 KV 从哪一层来?
最终确定的方案就是后半段的 KV 由第 层隐状态经 投影, 这就构成了 YoCo 的架构.
其实 YoCo 的方案在某些基模团队都有尝试, 通常会换一个叫 KV-Mirror 的名字描述, 有些团队未公开, 公开可以查到的是腾讯的 WeLM 《Building Effective Sparse MoE Models with Moderate Resources》[3].
2.2.2 CED具体实现
在 YoCo 概念之上, CED 引入一系列结构改进, 同时提升 KV Cache 的整体容量与 KV 生成的计算深度, 最终在保持与 baseline 相当性能的同时, 成功将 prefill 计算减少近一半.
对全局注意力, CED 把 Transformer 的底部 层视为因果 Encoder . 对上半部分的层(即 Decoder , ), KV 条目不再由各自的隐状态 导出, 而是直接从第 层的隐状态 经层相关投影权重( 与 )投影得到:
其中 与 分别表示 KV 条目及对应的压缩权重. 这一设计使 CED 在 prefill 阶段只需计算前半部分层, 就能以极低的计算代价获得上半层的全局 KV Cache.
具体来看, CED 将模型分为 Causal-Encoder 和 Decoder 两部分, 两部分各 20 层. 对比一下 YoCo 将两部分命名为 Self-Decoder 和 Cross-Decoder, 主要从注意力的信息来源区分两个部分. 前半部通过高效自注意力处理序列, 后半部则用自身各层产生的查询, 读取前半部生成的共享 KV. DeepSeek 换了一个观察角度: 既然前半部的关键职责是生成可复用的上下文表示, 那么可以把它看成一个 Encoder; 上半部利用这些表示继续计算预测, 则称为 Decoder. 在 YoCo 的论文观点中, 主要是强调 Self-Decoder 是 "怎样高效处理序列", Causal Encoder 强调 "它为后续网络提供什么", Encoder/Decodr名字的区分仅是视角不同而已.
在 YoCo 中前半段采用 ESA (gRet 或 SWA), 而在 CED 中, Causal-Encoder 前两层也为 SWA, 后续的 18 层则采用了 CSA2, 它是一种带压缩的 Sparse Attention 并结合了 SWA, 它将 Sparse Attention 构建的 KV 称为 Global KV, 将 SWA 构建的 KV 称为 Local KV, 通过拼接后和 Q 进行 Attn-Score 的计算, 我们将在后面一个小节详细展开, 并结合 CSA2 详细阐述 CED 的架构.
对 SWA, CED 在所有层保持常规的逐层计算: 任意层 的局部 KV 直接从当前层隐状态 导出, 这实际上增加了局部 KV 生成的计算深度. 但维持逐层计算需要一个 SWA 重放过程: prefill 阶段为 Decoder 计算 SWA KV Cache 需要额外处理 个 token( 为窗口大小). 对每轮 prompt 较短的多轮交互, 这部分 Decoder 开销不可忽略. 幸运的是, 先前工作(Chen et al., 2025)表明 SWA 的实际有效感受野远小于理论值 . 受这一观察启发, 作者引入 Decoder SWA Bounded Replay: 只为 Decoder 的 SWA 计算 prefill prompt 的最后 个 token, 从而显著降低计算成本.
1. 为什么 SWA 实际上增加了局部 KV 生成的计算深度?
先记 Encoder 深度为 , Decoder 深度为 , 窗口大小为 .CED 的全局 KV 来自 Encoder 边界表示:
前半部分虽然有很多层, 但 Decoder 读取的全局记忆仍然来自 的投影. 后续层可以产生不同的查询, 却不会因此把历史全局 KV 的来源变成更深层的表示. 而后续每一层都添加了基于 SWA 的局部 KV, 它保留了"每层从自己的输入表示生成 KV"这条路径. "深度增加"指的是: 最近这些位置的 KV, 可以包含更深层的计算结果, 而不只是同一份 Encoder 边界 表示的不同投影.
2. 为什么需要 Bounded Replay?
但是这些 Local KV 也会带来一些问题, 对于普通的完整 prefill, 没有这个问题: 全部提示词经过全部层, 各层的局部 KV 自然随前向计算生成.
但 CED 希望让大多数历史位置在 Encoder 结束后就停止计算. 此时虽然全局 KV 已经可以准备好, 这些历史位置却没有经过 Decoder, 所以 Decoder 深层的 Local KV 尚未生成. Decoder SWA Bounded Replay 是为了补齐 CED 提前结束 prefill 后缺失的Decoder Local KV, 同时避免恢复这些 KV 的成本抵消提前退出的收益.
既然 SWA 只保存最近 个位置的局部 KV, 看起来重放最后 个位置就够了. 但问题是: 这些位置在深层的表示, 还依赖窗口之外的更早位置. 例如, 每层窗口为 4. 为了计算位置 100 的第二层表示, 需要第一层位置 97 至 100 的表示. 而第一层位置 97, 又需要读取输入位置 94 至 97. 因此, 越往深层恢复, 越需要向前追溯. 对 层 Decoder , 精确恢复的历史跨度大约是:
如果每次工具调用只新增几十个词, 却要为了恢复缓存而让几千个( )历史位置经过 Decoder, prefill 提前退出省下的计算就可能被大量重放消耗掉. 作者参考了《PowerAttention: Exponentially Scaling of Receptive Fields for Effective Sparse Attention》[4] 的工作. 这是一篇研究稀疏注意力感受野与跨层信息传播的论文, 其中 4.3 节有一个实验, 在密码检索任务上对模型进行了评估, 在其约 2K 窗口的 SWA 实验中, 作者估计信息经过约 6 层传播后已衰减得很弱.
因此 DeepSeek 采用了 Bounded Replay的方式, Bounded 的作用就是限制这项开销: 只重放最后 个位置, 不再为了精确恢复而不断向前追溯. 代价是重建的 Local KV 属于近似状态. 重放片段开头缺少更早的局部依赖, 后续深层表示也可能因此变化.
但是, 我们注意到 CSA2 中这些被截短的是** Local SWA 状态的重建范围**, 不是全局记忆. 重放最后 个位置时, Decoder 仍可按因果与稀疏注意力规则读取更长历史的 Global KV. 因此, DeepSeek 接受这一近似, 并通过质量评估和后训练适配控制影响.
3. 为什么这个问题很重要?
长提示词下, 尾部重放只是 Encoder 大规模计算之外的一小段工作. 但在 Agent 多轮交互中, 大部分历史可能已命中全局缓存, 本轮真正新增的内容很短. 设本轮新增长度为 . 新内容的 Encoder 主体工作大致随 增长, 而恢复 Decoder 局部状态的代价, 却不会自动随 一起缩小. 例如 , 时, 精确恢复的历史跨度约为 个位置. 即使本轮只新增几十个位置, 仍可能为了恢复局部状态而回看很长的尾部, 再执行多层计算.
有界重放把这项恢复工作限制为最近 个位置经过 Decoder , 将每轮恢复状态限制为固定开销.
总体而言, 对序列长度 , CED 把 prefill 复杂度从 降到 , 实际上把总计算减半.
为什么计算量减半?
对长提示词的冷启动 prefill, Encoder 处理全部 个位置:, Decoder 只处理 个尾部位置:
所以主体工作量为:
代入 , 并与完整计算 比较:
当 时, 第二项很小, 比例才接近 . 以DeepSeek V4.1 Flash 的 , 为例, 假设提示词长度为 . 完整计算约为 个 token-layer; CED 的 Encoder 加有界重放约为 个, 是前者的 .
2.3 CSA2
2.3.1 为什么需要 CSA2 ?
为长上下文提供服务需要同时控制 KV 缓存存储和注意力计算. 这些成本可以沿三个具有乘法关系的维度减少:
条目大小维度: 例如 GQA 减少 KV 头的数量, MLA 在不同头之间共享一个小型潜在表示 序列维度: 其中每 个 token 压缩成一个条目, 例如 DeepSeek-V4 中的 CSA 和 HCA; 层维度: 其中某些层复用其他层的缓存和选择结果, 而不保留自己的缓存和选择结果, 或者被更高效的层整体替换.
在层维度的工作中:
《Reducing Transformer Key-Value Cache Size with Cross-Layer Attention》[5] 提出跨层注意力, 让一部分注意力层直接读取前面层产生的 KV, 从而避免每层保存独立 KV 缓存. 《IndexCache: Accelerating Sparse Attention via Cross-Layer Index Reuse》[6] 在层间复用 Top-K 索引以减少 Indexer 计算 《You Only Index Once: Cross-Layer Sparse Attention with Shared Routing》[7]只计算一次稀疏路由, 并将其共享给所有层 《HySparse: A Hybrid Sparse Attention Architecture with Oracle Token Selection and KV Cache Sharing》[8]则让稀疏层复用稠密层的 KV 缓存.
然而, 单纯复用索引并不能节省主 KV 存储, 在整个网络范围共享路由会限制性能, 混合设计仍然保留完整注意力层; 更重要的是, 这些方法都没有覆盖全部三个具有乘法关系的维度.
仔细分析, Cross-Layer Attention(CLA)虽然可以跨层共享 KV, 减少独立 KV 副本, 但是各层仍计算自己的注意力, KV存储省了但是算力没有省; IndexCache 在部分层之间共享 Top-K 索引, 可以减少 Indexer 运行次数, 但主 KV 仍按层保存, 虽然节省了一些 Indexer 算力, 但是存储没有省. 而 YOIO 在复用了 YOCO Decoder-Decoder 的结构, 节省了一半的 KVCache, 但是 cross-decoder 中的 Sparse Attention 多层需要共用一次选出的 TopK 候选集合, 对模型的性能存在影响. HySparse 使用 Full Attention 产生 KV, 虽然稀疏层可以复用这些 KV, 但是完整的 Attention 计算效率仍然会影响性能.
在介绍 CSA2 之前, 我们可以详细回顾一下 DeepSeek 过去几年对 Attention 计算的优化, 在 MLA 中对所有头的 K/V 表示做联合低秩压缩, 在条目大小维度 进行了压缩, 然后在 DeepSeek V3.2 中引入了 Sparse Attention(DSA), 降低了 Attention 的算力需求. 接着在 DeepSeek-V4中 通过 CSA(压缩比4:1) 和 HCA (压缩比 128:1) 增加了序列维度 的压缩. 而 CSA2 则进一步的将压缩推向 层维度.
CSA2 联合利用这三个维度: 它跨层共享主 KV 和 Indexer K, 并允许层复用 Top-K 索引, 同时将缓存共享与索引复用解耦. 它将这些复用策略与简化的压缩器以及分层稀疏 Indexer 结合起来, 后者缩小了 Decoder 中后续索引层的搜索范围.
和CSA在计算上的一些细微区别: 与 CSA 类似, CSA2 包含一个轻量 Indexer, 使用 Indexer Q 和 Indexer K 对主 KV 条目评分, 为每个查询选出 Top-K 条目, 每个 Q 同时关注选中的条目和层内局部滑动窗口 KV (SWA KV).
CSA2 的 Compressor 也有一些区别, 首先它包含了压缩比为 1 的特例, 即不压缩 Main KV 的能力用于 Decoder Layer.
在具体实现中, Causal-Encoder 用压缩比 可以减少每份 Main KV 的条目数和索引候选数; Decoder 用 保留逐 token 的可寻址性. 与 CED 和跨层缓存共享结合后, Decoder 不需要为每层保存独立的长序列主 KV, 因而可以把一部分空间预算用于更细的序列粒度.
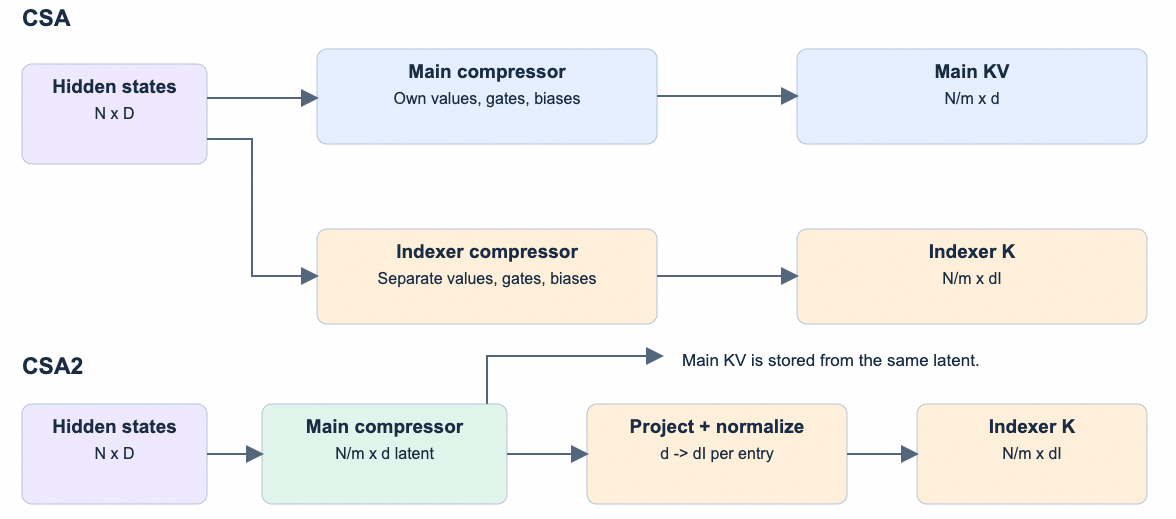
同时, CSA2 简化了 Compressor 和 Indexer. 在 CSA 中, 压缩比 意味着每个主 KV 条目由 个原始 KV 缓存条目产生, 相邻压缩条目所用的源条目之间存在重叠. 它还包含绝对位置嵌入, 以在压缩过程中编码这 个条目的位置. CSA2 移除了这种重叠和绝对位置嵌入.
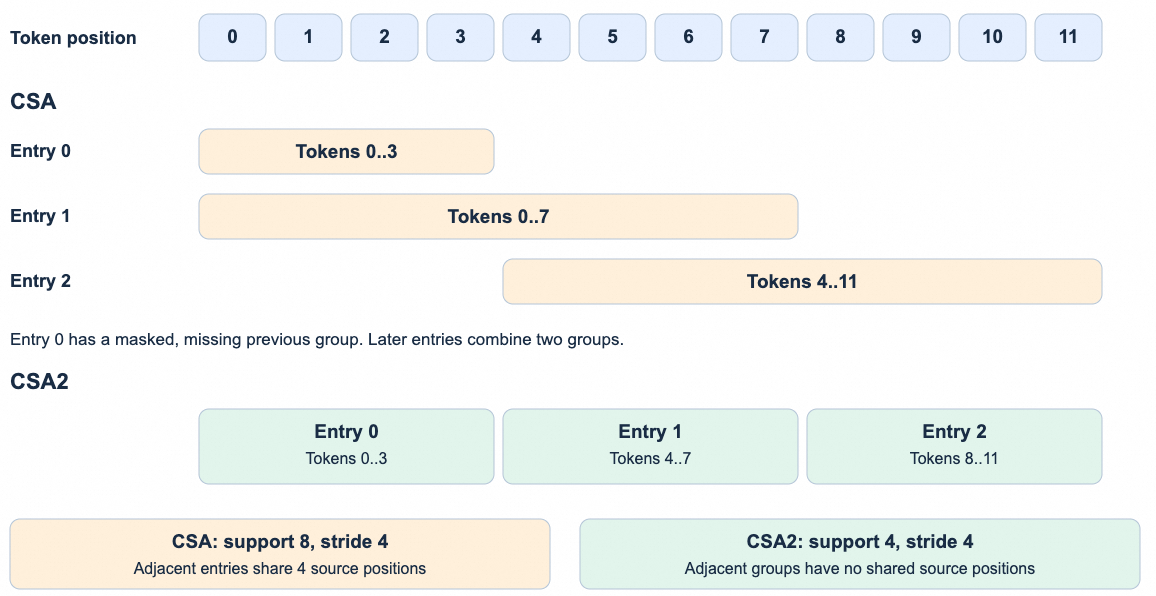
此外, CSA2 通过投影主 KV 条目获得 Indexer K, 替换了 CSA 从隐藏状态出发的独立压缩通路. 这两项设计均简化了实现, 并提高了训练效率.
2.3.2 跨层 KV 与 Index 复用
具体来看, CSA2 在 CSA 的基础上主要是增加了层维度 的数据复用. 从计算机体系结构的视角来看, 我们可以把 Attention block 看做是一个计算组件, MoE/FFN 作为一个存储组件, 而 KV 相关的则可以看做是计算的 Cache. 以这个视角, 我们可以把跨层 KV 和 Index 的复用看做是某种 Data Locality 的处理, 如下图所示:
跨层复用主要分为三种模式, 如下图所示:
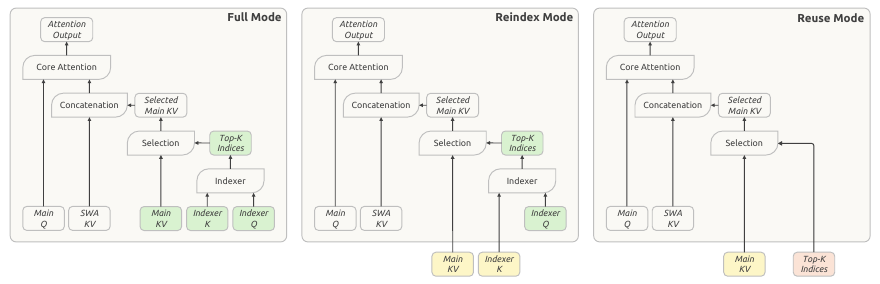
这些模式的区别在于如何获得 Main KV, Indexer K 和 Top-K Indices. 绿色方块表示在当前层计算的量; 黄色方块表示从最近一个完整模式层复用的主 KV 和 Indexer K; 红色方块表示从最近一个生成索引的层复用的 Top-K 索引. 另外, 三种模式都在当前层计算 Main Q 和 SWA KV.
Full模式 该层计算自己的 Main KV 和 Indexer Q, 从 Main KV 投影得到 Indexer K, 并运行 Indexer, 产生新的 Top-K 索引. 因此, 它执行完整的 CSA2 计算通路, 各组件承担的职责与 DeepSeek-V4 中一个完整的 CSA 层相同.
Reindex模式 该层复用前面某层中最近可用的 Main KV, 以及与之对应的 Indexer K. 并计算自己的 Indexer Q, 对复用的 Key 重新评分, 并生成新的 Top-K 索引. 这使稀疏选择能够跨层变化, 同时 Main KV 和 Indexer K 保持共享.
Reuse模式. 该层复用最近可用的 Main KV, 以及前面某个 Full 模式层或 Reindex 模式层针对该 Main KV 计算出的最新 Top-K 索引. 它使用这一选择执行注意力计算, 不计算 Indexer Q, 也不评估索引分数.
通过共享 Main KV 和 Indexer K 减少了 KVCache 的存储占用, 而复用 Top-K Indices 则可以避免额外的 Indexer 计算. Reindex 模式在保留缓存共享的同时, 允许选中的条目跨层变化. 具体的模式使用我们结合 CED 进行分析.
2.3.3 CED 和 CSA2 的结合
在 Causal-Encoder 中, 我们可以看作为如下几个宏观的 block 构成的结构. 首先是 2 层标准的 SWA block , 然后接着由三个宏观的 Encoder block 构成, Engram 在第二个 SWA block 和最后一个 Encoder block 前注入, 如下图所示:
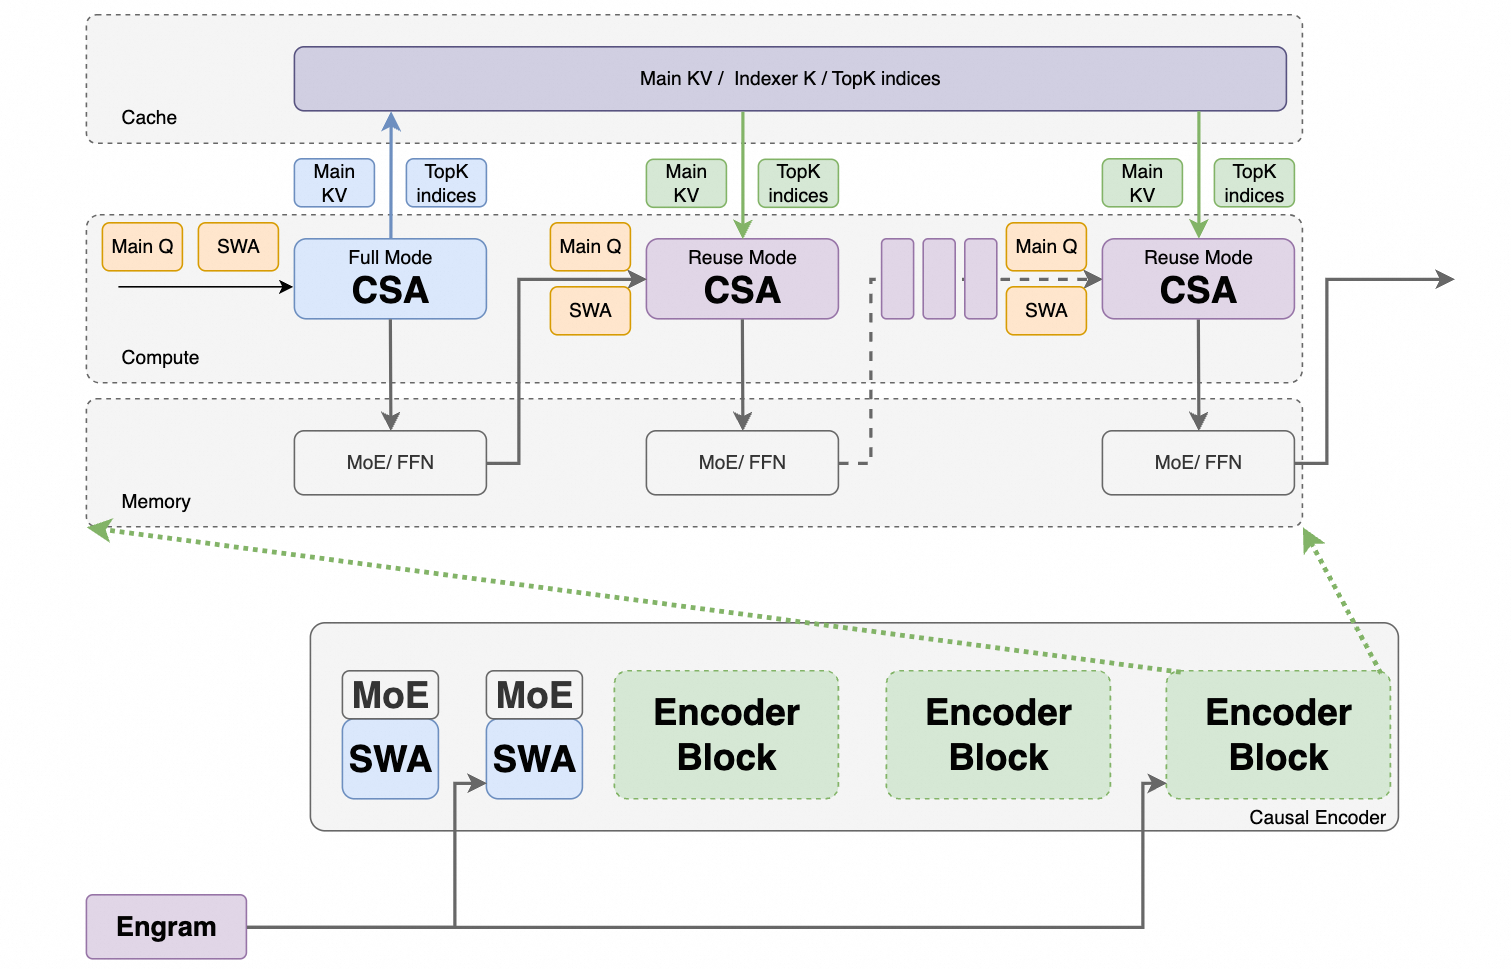
Encoder block 为一个 6 层的结构, 第一层为 Full模式的 CSA2, 后续 5 层为 Reuse 模式的 CSA2. 上图这样的方式能够更好的描述整个跨层复用的机制.
1. 为什么要把 1 层 Full + 5 层 Reuse 看成一个整体的 Encoder block?
第一层 Full 模式 CSA2 将会计算并写入整个 Main KV 和 TopK indices. 后续的 5 层 Reuse 模式的 CSA2 都会复用第一层产生的 Main KV 和 TopK indices. 简而言之, KV 和 TopK 选择都在 Reuse 模式的 block 被复用, 实际上每一层修改的是 Q.
因此对于整个包含 6 层的 Encoder block 结构, 我们可以看做一个通过每一层修改 Q 后进行递归的 Transformer 结构.
2. 前两层 SWA + Engram 的作用是什么?
一句话描述: 第一层提供局部上下文, Engram 注入由短模式寻址、由上下文控制的记忆, 第二层将二者整合成后续压缩可用的表示.
第一层 SWA 窗口大小为 , 位置 能读取的位置集合为:
例如同一个词在不同句子中, 会对附近不同位置分配不同权重. 第一层的输出通过 SWA 转换为经过局部上下文处理的表示. 然后是 Engram 的注入, 关于 Engram 在以前的文章《谈谈DeepSeek Engram: Conditional Memory》 有详细的分析.
Engram 读取以当前位置结尾的 2-gram, 3-gram 和 4-gram, 然后通过 Hash 查表后拼接, 因此, Engram 有能力把反复出现的短语模式、局部组合规律等编码到参数表中. 而第一层的 SWA 的输出为 Engram 提供了上下文门控, 注意, 相对于直接在第一层注入 Engram , 经过第一层 SWA 处理后的输出已经是一个结合局部上下文的表示.
Engram 的注入是直接做的是当前位置的残差更新, 它不会直接把当前位置的记忆写入其他位置. 但第二层 SWA 可以读取窗口中每个位置经过 Engram 增强后的表示.因此, 第二层 SWA 的 Q 和局部 KV 都可以受到 Engram 的影响增强相关的短语模式、局部组合规律等信息, 经过第二层 SWA 的处理, 完成了局部信息的整合. 因此, 前两层形成了这样的顺序:
另一方面, 两层 SWA 的结果扩大感受野长度到:, 因此在第三层开始的 CSA2 处理中, 输入包含了: token embedding / 两层局部上下文计算的结果 /被上下文门控后注入并整合的 Engram 记忆这些经过处理的局部表征. 这也是 CSA2 中 Compressor 不需要进行 Overlap 处理的一个原因.
然后我们再来看 Decoder 的结构, 我们可以把它也类似的看做由 5 个 Decoder Block 组成的结构:
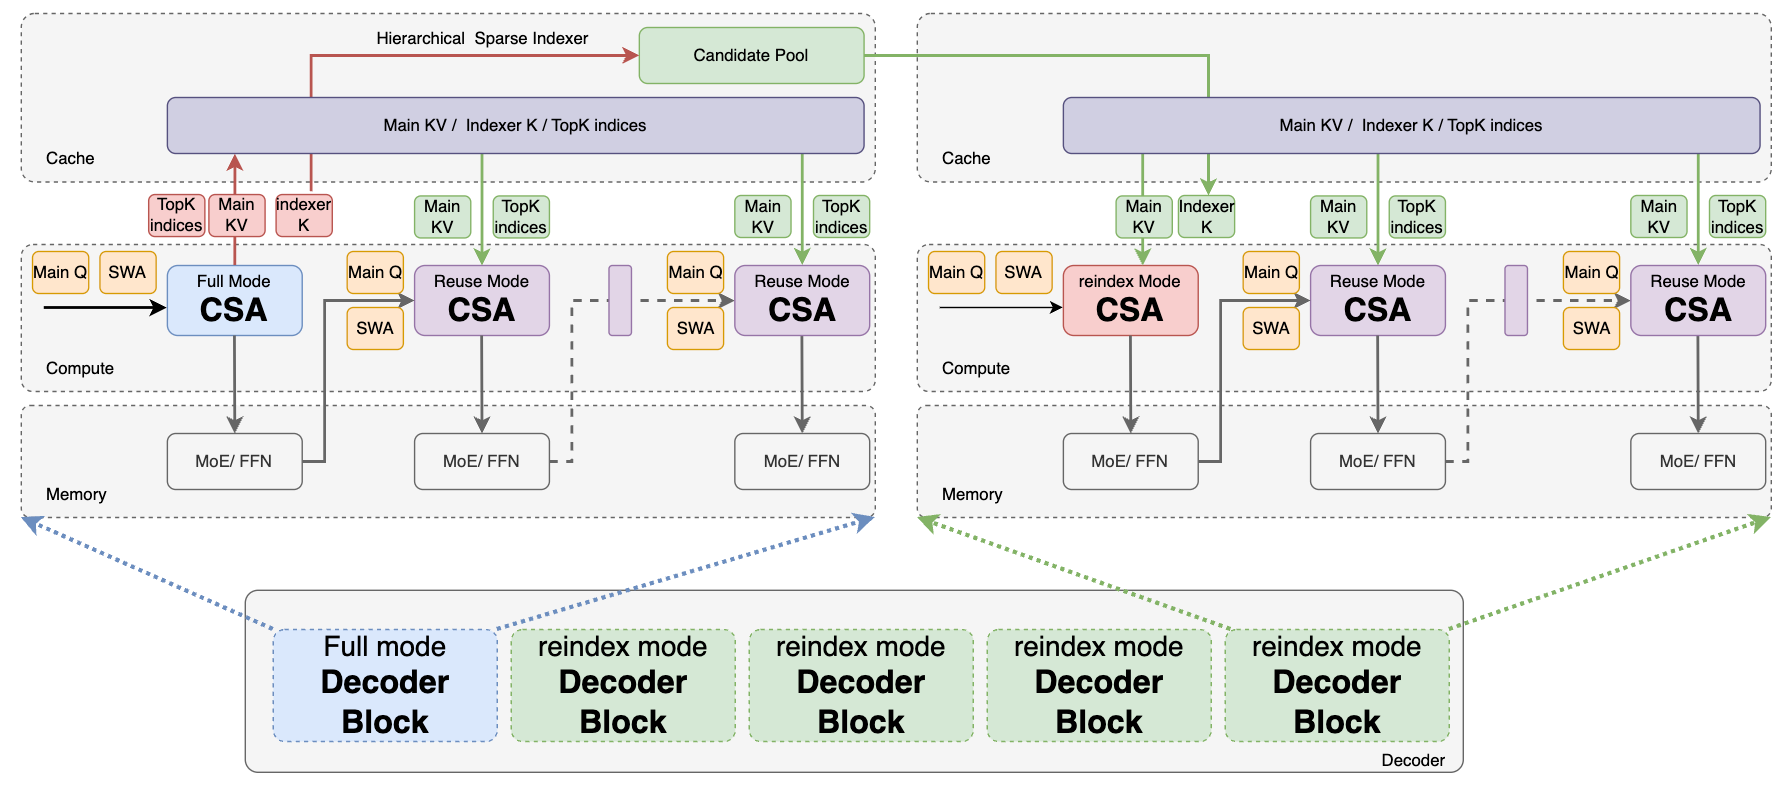
其中第一个 Decoder Block 中的第一个 CSA2 为 Full Mode, 因此我们也将其称为 Full Mode Decoder Block. 同理, 后续的 4 个 Decoder Block 也被称为 Reindex Mode Decoder Block. 注意所有的 CSA2 在 Decoder 中压缩比为 1, 并且仅有 Reindex Mode CSA2 在 Decoder 中使用.
Full Mode Decoder Block 的第一层为 Full Mode CSA2, 和 Causal-Encoder 中的 Full Mode CSA2 一样, 它会自己计算 Main KV 以及 Indexer K 和 TopK indices. Main KV 和 TopK indices 将被后续的 3 层的 Reuse Mode CSA2 复用. 但是它引入了一个层次化稀疏 Indexer(HSI)的处理方式, 通过在计算 Top-K Indices 时的分数构建块级选择作为后续 Reindex Mode CSA2 的 Candidate Pool, 我们将在后续一节详细展开.
Reindex Mode Decoder Block: 在 Decoder 中 Full Mode Decoder Block 后有 4 个 Reindex Mode Decoder Block. 它的内部第一层为 Reindex Mode CSA2, Reindex Mode CSA2 从会重新计算自己的 Indexer Q 进行打分, 并在 Candidate Pool 内选自己的 Top-K 条目.
2.3.4. 分层稀疏 Indexer (HSI)
跨层索引复用减少了 Indexer 评估次数, 但剩余的 Indexer 仍需对因果可见的全部上下文打分. 对超长上下文, 这一成本仍是主要计算瓶颈.
在《HISA: Efficient Hierarchical Indexing for Fine-Grained Sparse Attention》[9] 研究了如何用 "块级粗筛 + token 级精筛" 降低稀疏注意力索引器的开销.
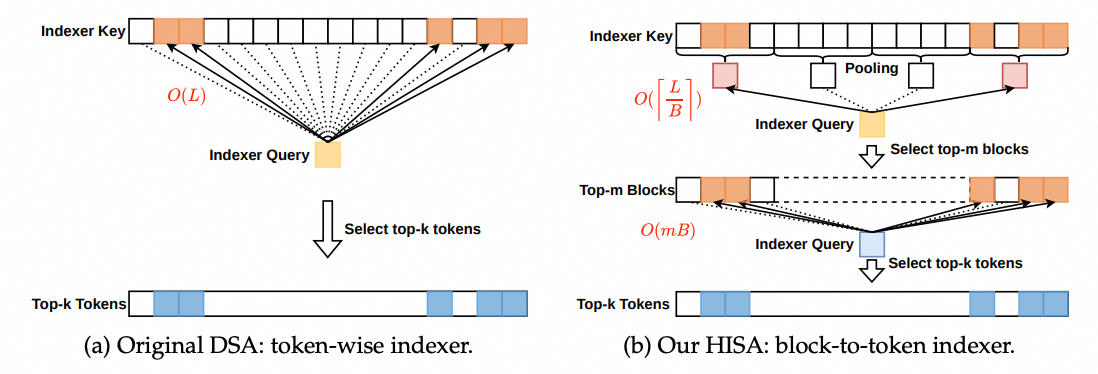
如图所示, 它将前缀按连续位置分成大小约为 的块, 第 块为 . 块数为 . 每个块维护 Indexer 的均值:
均值作为搜索用的辅助函数. 原始 token Indexer 和 Main KV 仍保留. 解码时可以为当前块维护向量和与计数, 新 token 只更新一个块, 已完成的历史块复用摘要.
第一阶段复用同一组 , 对块均值打分:
只保留高分块, 然后展开成候选位置集合:
第二阶段对 计算原来的 , 从候选中选出最终 个位置:
DeepSeek团队发现, 在 Decoder 中, 浅层 Indexer 的信息可以自然地用于限制深层 Indexer 考虑的候选, 且不需要增加任何额外状态. 因此作者引入分层稀疏 Indexer(HSI), 仅用于 CED 的解码器, 以减少 decode 期间的重复打分. 对每个查询, 第一个 Full Mode 层构建一个 Candidate Pool, 供后续 Reindex Mode 层作为搜索域. Candidate Pool 大小固定时, 深层 Indexer 的每查询成本从随上下文线性增长变为常数. 该机制是训练感知的, 在后训练阶段引入: 训练与推理施加完全相同的候选限制, 使深层 Indexer 在推理所用的搜索域下被优化.
HSI工作原理如下:
第一个 Full Mode CSA2 对所有因果可见的 main KV 位置打分, 为自己的注意力产出 Top-K 索引; 同时执行块级候选选择: 每个块取其内部位置的最大索引分数, 选出分数最高的若干块, 把这些块覆盖的位置收集成一个大于最终 Top-K 集合的候选池. 例如选出 2048 个块、每块 8 个位置, 得到 16384 个候选位置. 候选池决定后续 Indexer "在哪里搜", 最终 Top-K 决定每层"读哪些条目".
后续的 Reindex 模式层只对对应查询的候选位置打分, 并在池内选自己的 Top-K 条目; Reuse 模式层不做新索引, 直接使用针对所复用 main KV 计算的最新 Top-K 索引. 于是候选池跨索引层共享, 而最终选择可以各不相同.
候选池大小固定时, 后续每个 Indexer 每查询打分的位置数与上下文长度无关、有界; 第一个 Full 模式层仍需扫描整个因果可见范围. 因此分层索引在保留初始全范围扫描的同时, 降低了后续 Indexer 评估的成本.
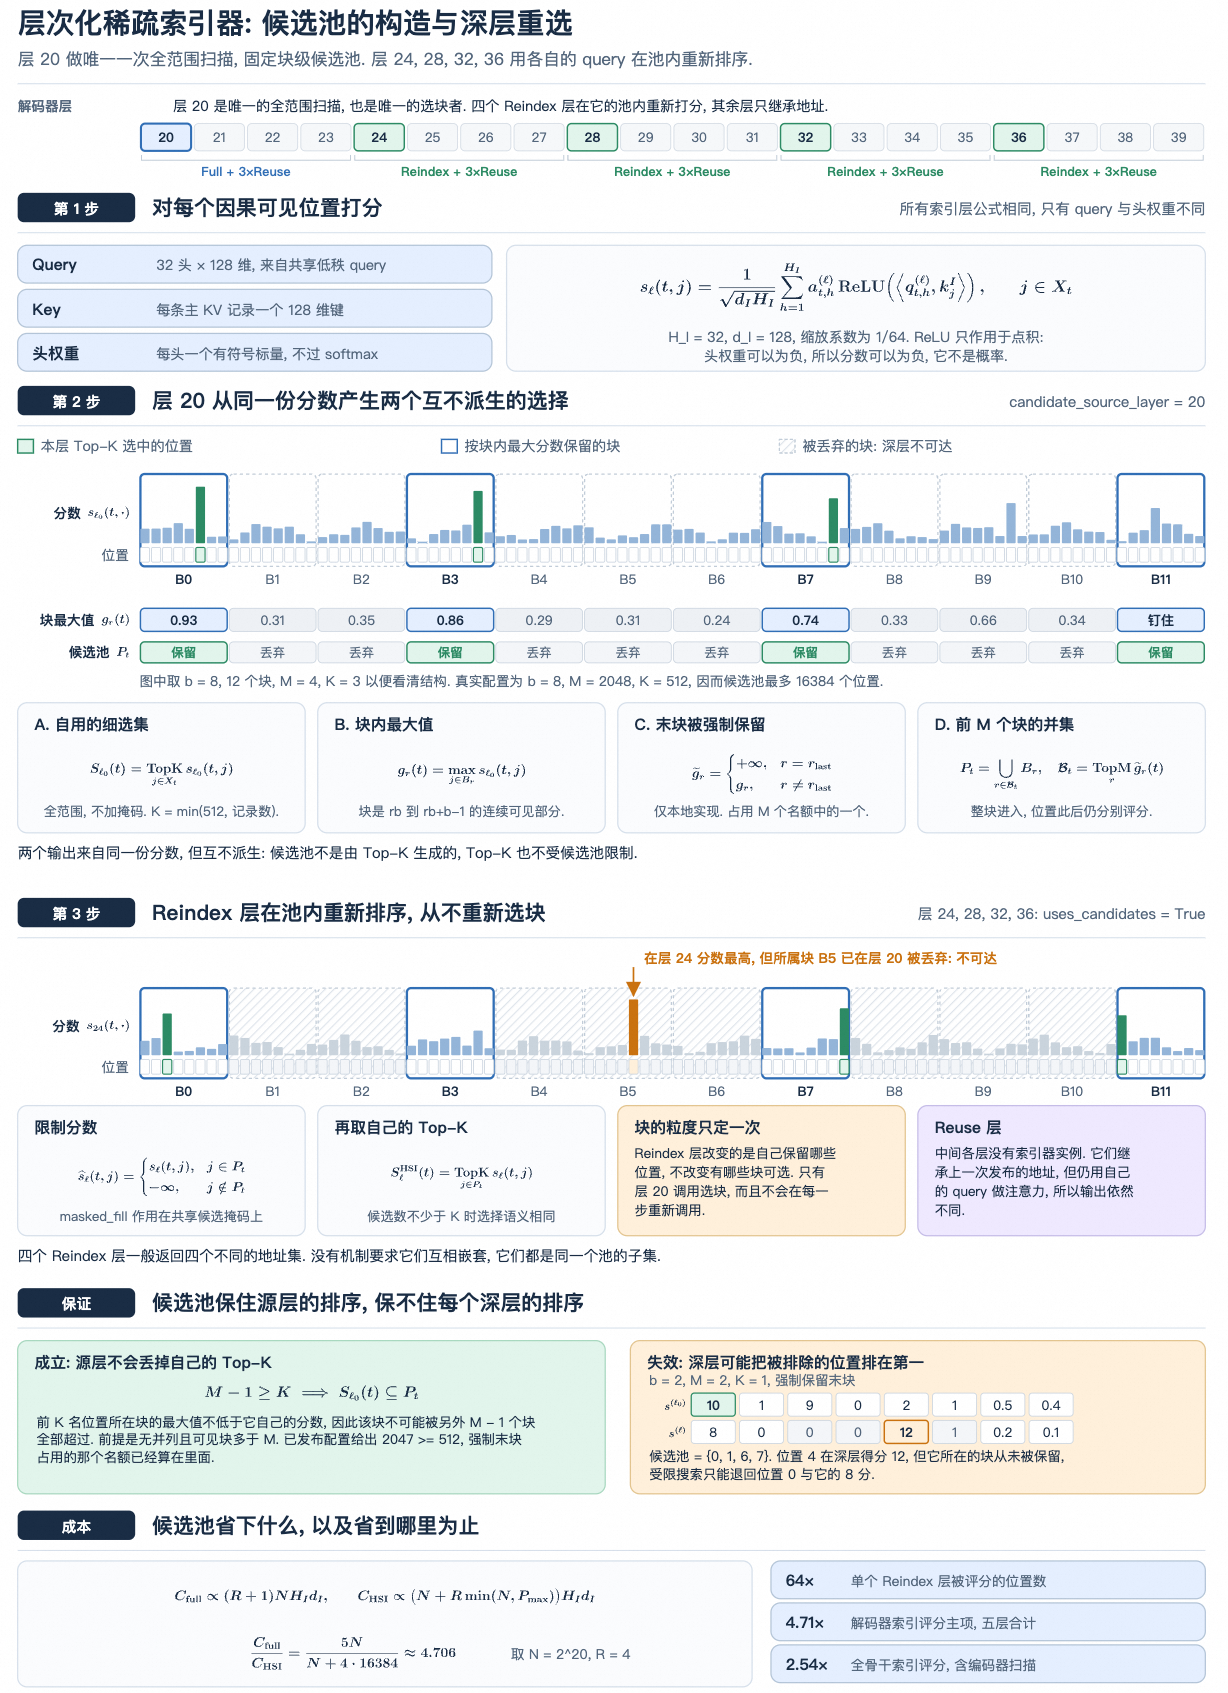
和 HISA 的区别是, HISA 需要每层都先进行块池化打分, 然后进行稀疏的 TopK 选择. 而 HSI 从浅层已经得到的完整位置分数取块最大值, 后续层共享候选范围, 并在后训练中适应限制. 二者都做粗筛再细选, 粗筛依据却不同.
另外, HSI 取块最大值避免了均值池化可能造成的峰值稀释.
1.Full Mode层如何生成 Candidate Pool? 候选块宽度candidate_block_size为 , 块数上限candidate_topk_blocks为 , 最终选TopK为 . 用 表示第 个因果可见块,
第一层先计算完整的 Indexer Score . 供自身产生 TopK indices
同一份分数还用于块最大值归约,
对应实现为中scores = F.pad(logits, (0, -width % block_size), value=-torch.inf) 用 补齐最后一个块, 然后 unflatten 将历史轴拆为块数与每块 8 个位置, amax(dim=-1) 正好实现 . 最后按块分数选出至多 个块
另外还增加了一个边界策略. 它把包含最新可见位置的块分数临时设为 , 强制该块占用一个选块名额. 即
对于选中的块会产生一个 bitmap, 然后通过repeat_interleave(block_size, dim=-1)[..., :width] 把块标志展开为与原分数等宽的 bitmap 构成 candidate pool用于后续的 reindex mode 计算.
另外, 我们还需要注意到论文中阐述 “该机制是训练感知的, 在后训练阶段引入: 训练与推理施加完全相同的候选限制, 使深层 Indexer 在推理所用的搜索域下被优化.” 但是此处没有公开具体的后训练方法.
假设不使用 HSI 时, Decoder 每个需要重新索引的层, 都可以到完整历史里寻找最相关的 512 个位置. 使用 HSI 后, 第一位检索者先把历史缩成一份最多包含 16384 个位置的名单, 后面的检索者只能在名单里各自挑选 512 个位置. 如果训练时仍允许后面几层搜索全部历史, 而上线时突然只给它们一个名单, 将会出现训推分布和选择不一致的情况影响性能.
我论文阐述DeepSeek-V4.1-Flash 在预训练阶段已经从头使用稀疏注意力, 先以 64K 序列训练, 再扩展到 1M, 并且明确阐述了 HSI 是在后训练阶段引入的. 也就是说预训练阶段应该在模型结构上没有 HSI. Reindex Mode 的层还是使用完整的计算. 在后训练阶段, 要让深层 Indexer 的专属参数真正学习, 还必须存在 Indexer 损失或其他梯度估计机制, 但是报告没有披露损失形式, 我们猜测它使用了一个混合的损失函数:
其中, 让主干在受限候选集上适应; 则可能用主注意力分布蒸馏 Indexer 的连续分数. 结合 DSA 的实现, 猜测为:
其中 表示停止梯度, 是该层具有有效监督的查询集合, 是明确指定的监督支持集. 是辅助目标系数.
2.4 高效的架构扩展
2.4.1 Single-Pass mHC
关于mHC 在以前的文章中《谈谈 DeepSeek mHC》有详细的分析, 它在相邻 Transformer 块之间维护 条残差流, 如下图所示
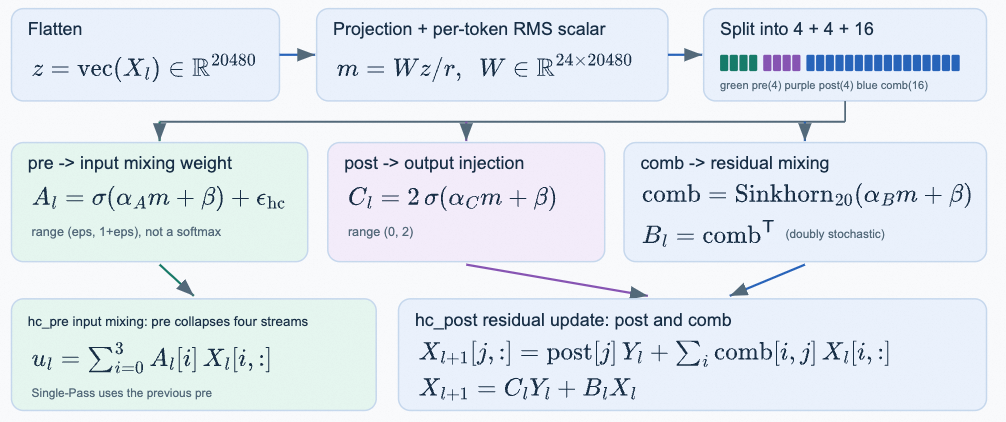
对于每个 token, 用 表示这些流, 其中 为块索引, 为隐藏维度. 这些流按如下方式更新:
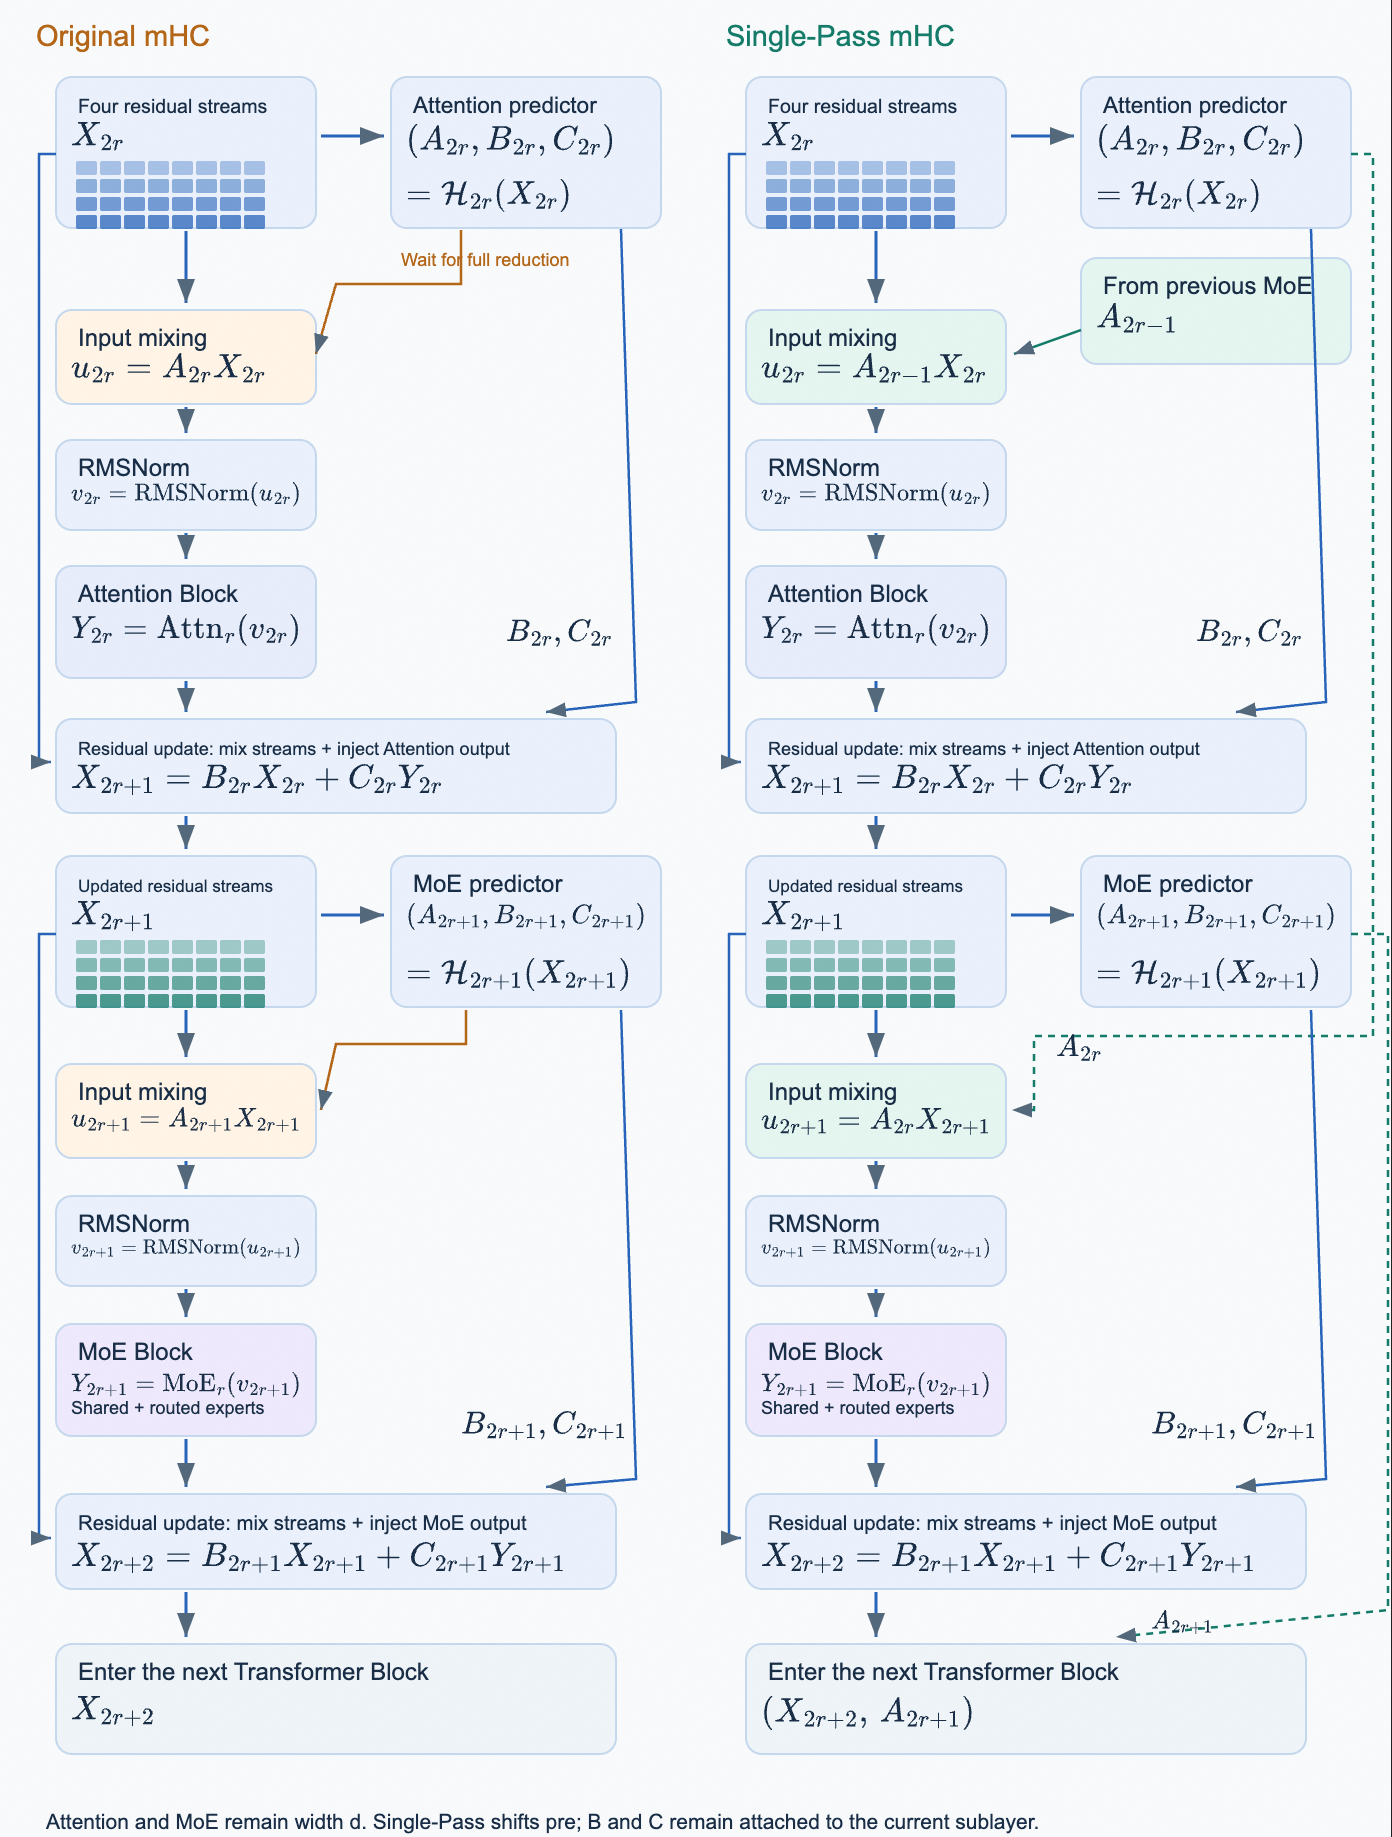
其中 , 和 是由 预测的逐词元系数. 系数预测器 包括归一化和投影. 但是计算的时候会有数据依赖, Single-Pass mHC 将输入混合系数移动一个块, 即每个块使用前一个块产生的混合系数, 从而消除依赖:
对比如图所示:
2.4.2 Engram
关于 Engram 在以前的文章《谈谈DeepSeek Engram: Conditional Memory》 有详细的分析, DeepSeek-V4.1-Flash 和原始论文模型结构的区别如下, n-gram 扩展到了 {2,3,4} 并省去短因果卷积, 因为它在推理软件栈的复杂性和性能增益上的取舍. 另外使用了基于动量的更新, 随后进行 Sinkhorn Balance 来优化 Engram Embedding.
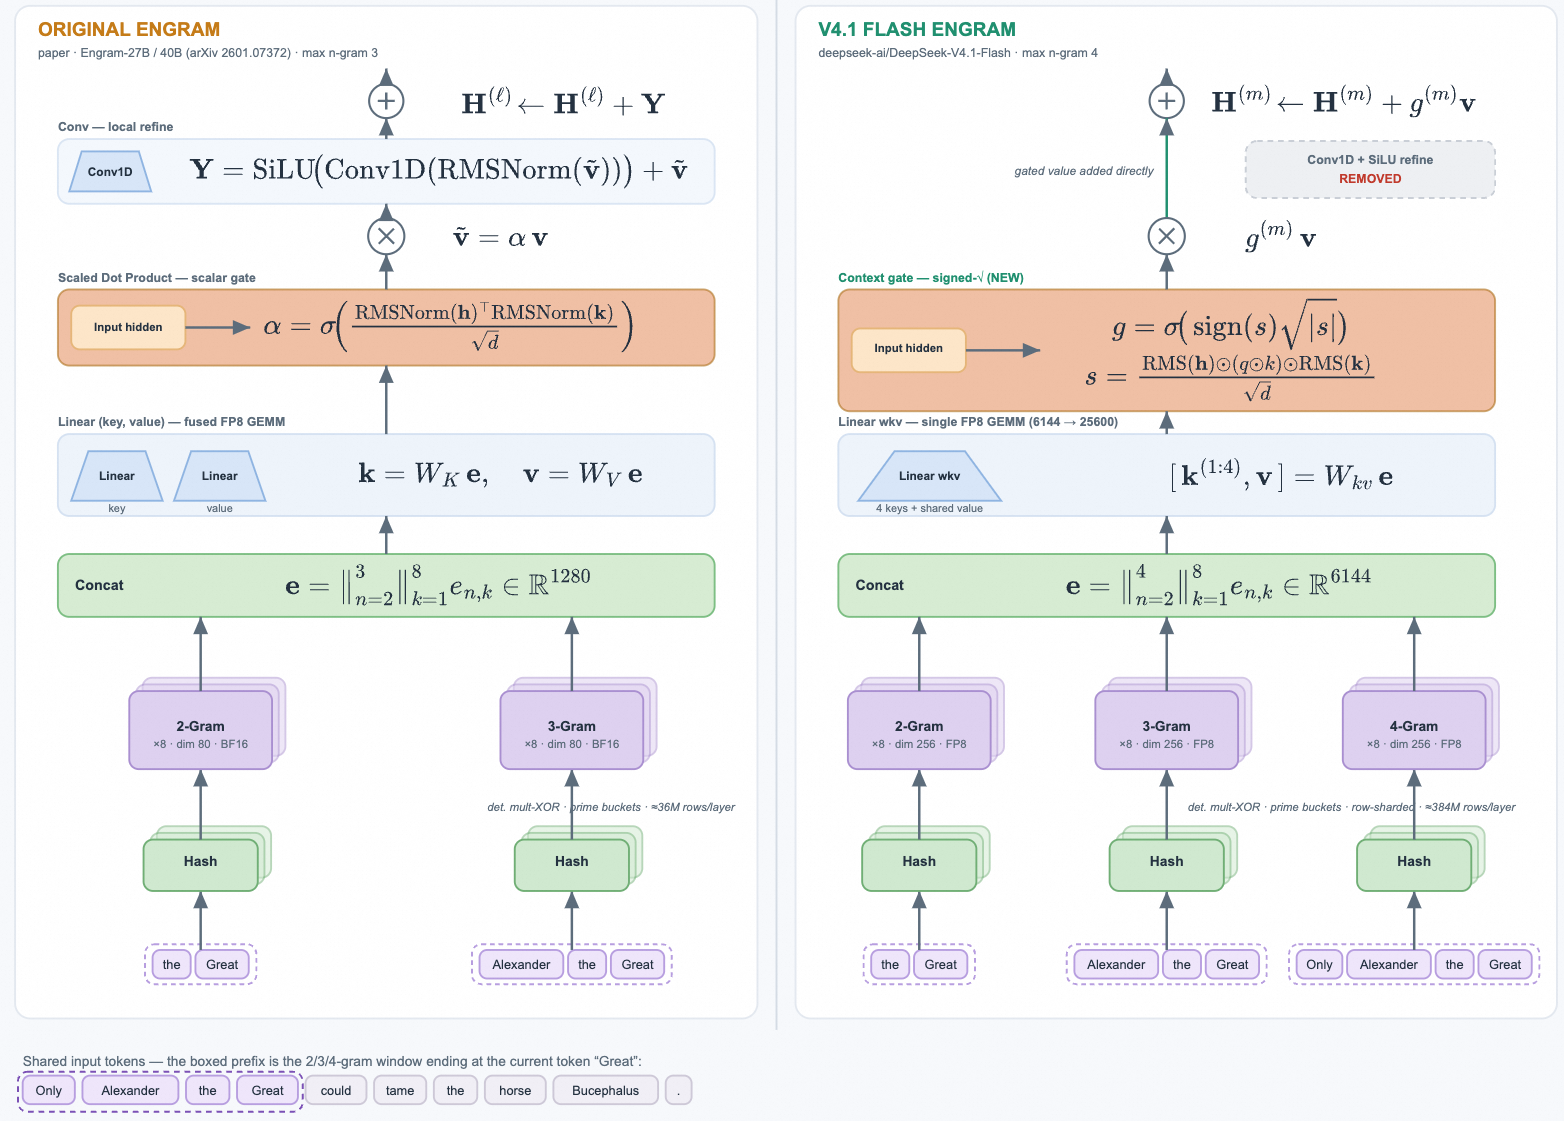
它将 196B 个 Engram 参数平均分配给两个模块. 每个模块采用 元组阶数 , 每个阶数包含 8 个哈希头, 总嵌入维度为 2048. 每个头索引一张约有 16M 个条目的表, 各表大小选择为互不相同的素数. 嵌入表和键/值投影均使用 FP8 精度. 模块放置在第1层和第14层,即在第二个 SWA 和最后一个 Encoder Block 中的 Full mode CSA2 之前, 以平衡训练流水线阶段之间的内存使用.
推理时, 确定性寻址允许通过后台 RDMA 传输从主机内存预取嵌入, 第一个模块的预取与第一个 Transformer 块的计算重叠.
2.4.3 DSpark
关于 Dspark 在以前的文章《详细谈谈DSpark投机解码的原理》已经有详细的分析了.
在 DeepSeek-V4.1-Flash 中 Draft Model 由三个 Transformer 块组成, 其滑动注意力窗口为 128 个 token , 一次前向计算会并行计算五个草稿位置的基础未归一化得分, 同时由一个轻量 Markov 头建模 Draft token 之间的依赖.
DSpark 在预训练之后的专门阶段引入. 在这个阶段只训练 DSpark, 同时保持主干冻结. 在后训练期间, 继续与主干一起训练 DSpark, 但不将 DSpark 目标的梯度传播到主干. 这使 DSpark 与不断演变的策略保持一致, 从而既可加速在线推理服务, 也可加速强化学习 RL 和同策略蒸馏 OPD 的轨迹生成.
2.4.4 FP4 Main KV Cache
丛数值精度上进一步降低 KVCache 的存储占用量, 在 DeepSeek-V4 已经对 FP4 Indexer Q 和 K 使用量化感知训练 QAT, 以加速索引计算并缩小索引器缓存. 这里主要是针对 Main KV 进行 FP4 处理. 为了支持尽可能多的硬件平台, 仍采用 OCP 标准 MXFP4 格式. 在这里 FP4 的作用是减少存储, 而非加速矩阵乘法. 在注意力计算之前对缓存值反量化为更准确的格式, 而无需原生支持这种格式的矩阵乘法, 从而保持跨硬件平台的兼容性.
下图为 NVFP4(E2M1) 作为参考:
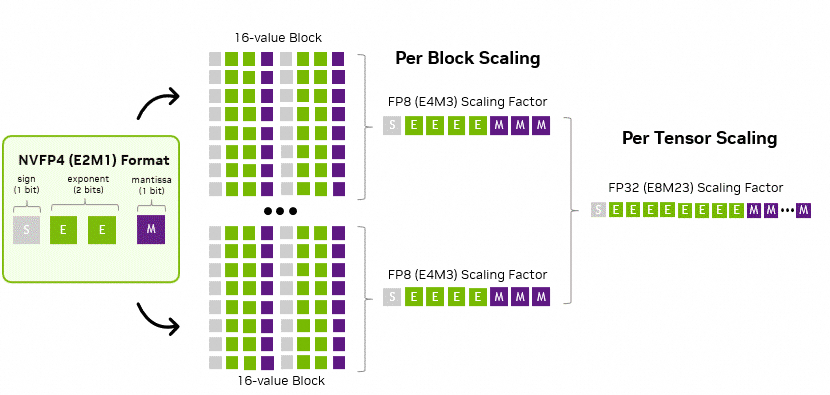
DeepSeek 选择 E2M1, 每 16 个通道共享一个 E4M3 缩放因子, 遵循 NVFP4, 但省略其第二级全局缩放因子, 以平衡精度与简单性. 如下图所示:
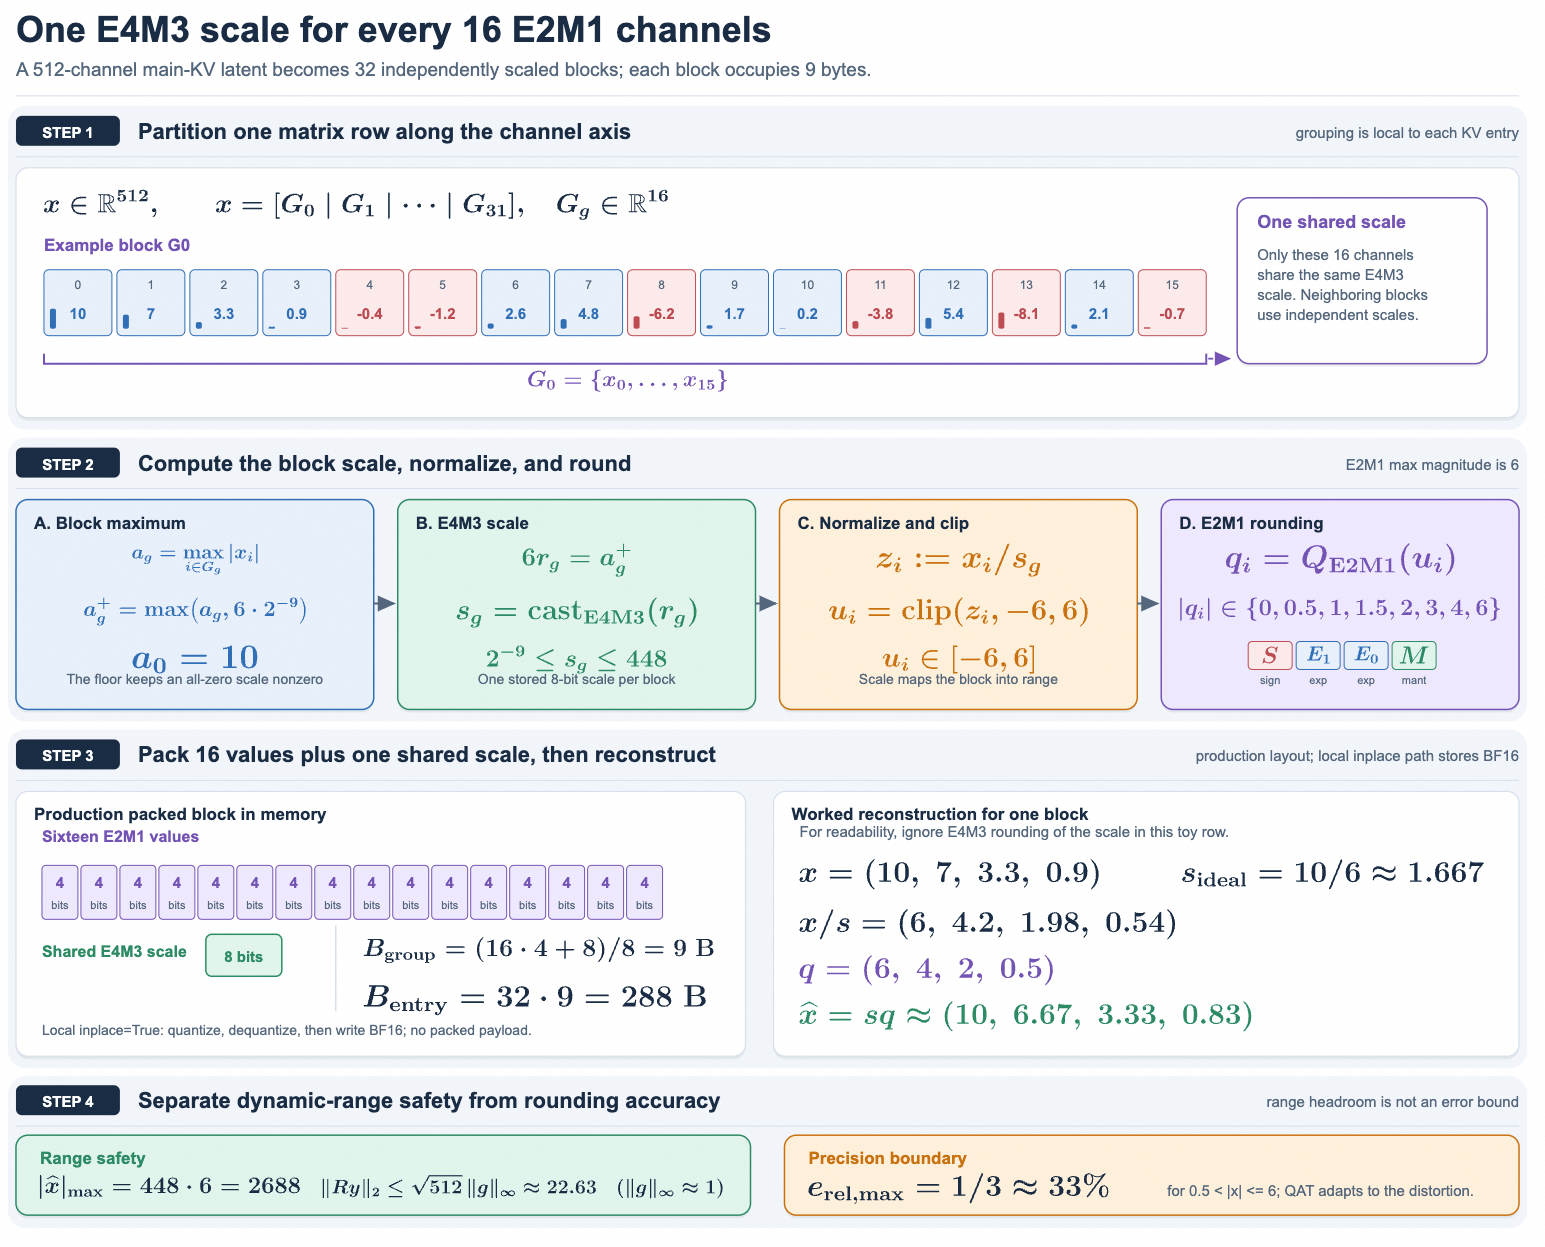
省略该缩放因子后, 主 KV 缓存仍具有充足的动态范围: 这种格式支持最大幅值 , 远高于缓存幅值的上界. 在 DeepSeek-V4.1-Flash 中, 训练得到的最大 RMSNorm 权重幅值约为 1. 经过 RMS 归一化后, 512 通道 KV 潜变量的 L2 范数最多约为 . RoPE 保持这一范数, 因而旋转之后各通道绝对值的最大值也被约 所界定. 此外, 训练期间观测到的最大幅值约为 10. 因此, 省去全局缩放因子没有造成可测量的精度下降, 并简化了缓存布局.
为支持 DeepSeek-V4.1-Flash 中 FP4 主 KV 缓存存储, 在后训练期间引入 QAT. 非 RoPE 分量与 RoPE 分量使用相同的量化格式. 另外在 RoPE 之后量化缓存: 在实验中, RoPE 之前量化只带来轻微的精度改善, 却会在解码期间引入额外开销. 由于滑动窗口注意力 SWA 的 KV 缓存对量化敏感, 保留了 FP8 的精度. 与 DeepSeek-V4 的 FP8 Main KV 缓存相比, 这种格式使 HBM 中以及卸载到 SSD 时的存储占用都接近减半.
3. 为什么可以省 KV ?
首先我们将在第一节统计 KV Cache 节省的来源. 总体来看, DeepSeek-V4.1 Flash 针对 KVCache 的优化分为几块, 首先 FP4 Main KV 节省了一半的开销, CED 减少了大量的 Prefill 时的算力消耗, 而最关键的还是在 CSA2 中构建的跨层共享的模式, reuse mode 和 reindex mode 的 CSA2 完全复用了 Full mode 产生的 Main KV. 实质性的问题正如下描述:
在标准的 Full Attention 中, 每一层的 Q K V 都在发生变化. 而 CSA2 跨层共享 Main KV / Indexer K , 并且能够高质量的完成训练, 实质上我们需要回答的一个问题是: 在固定 KV 的前提下, 通过多层 reuse mode CSA2 构成的一个递归的 Transformer架构, 如何通过仅改写 Q 达到和 Full Attention 相似的表现力? 这是我们第二节分析的重点.
3.1 KVCache 为什么是890B
首先我们来算一下, 为什么 KVCache 是 890B. DeepSeek-V4.1-Flash 每层维护两类 KV 状态
Global KV - 压缩后的全上下文分支, 包含两部分: main KV: 由压缩器产生的 MLA 潜向量 ( compress_kv_cache).indexer K: 稀疏索引器用来对位置打分的轻量键 ( k_cache).
Local KV (SWA KV): 最近 个 token 的滑动窗口缓存 ( window_kv_cache).
常驻在 HBM 中的是 Global KV, 即:
推导所用到的参数表如下:
| 符号 | 含义 | 取值 | 来源键 |
|---|---|---|---|
| 主干层数 | (20 Encoder + 20 Decoder) | num_hidden_layers |
|
| 主 KV 潜向量通道数 | head_dim |
||
| 索引器 K 通道数 | index_head_dim |
||
| SWA 窗口 | sliding_window |
||
| KV 来源层 (Full 模式) | kv_source_layer_ids |
||
| 索引来源层 | index_source_layer_ids |
||
| 第 层的压缩比 | Encoder=2 / Decoder=1 | compress_ratios |
两个全局缓存都用 FP4 量化感知训练存储. 单个条目的存储成本 = (FP4 载荷) + (缩放因子元数据). 对一个 通道向量, 每 通道配 1 字节缩放, 单条目字节数的通用公式为:
Main KV 条目 (, ):
Index K 条目 (, ):
压缩比为 的层每 个 token 存储一个条目, 故其每 token 存储 = (每条目字节数) . 在 Full 模式来源层 上求和:
来源层为 (在 ) 与 (在 ), 于是
Main KV 小计
Indexer K 小计
合计
汇总如下:
| 模块 | 层 | 贡献项 | 每条目字节 | 每 token 字节 | |
|---|---|---|---|---|---|
| Encoder | 2, 8, 14 | Main KV | 2 | 288 | |
| 2, 8, 14 | Indexer K | 2 | 68 | ||
| Decoder | 20 | Main KV | 1 | 288 | |
| 20 | Indexer K | 1 | 68 | ||
| Global KV Sum | 890 B/token |
对比 DeepSeek-V4-Flash, V4-Flash 主干 43 层: 2 层纯 SWA, 21 层 CSA (序列压缩 ), 20 层 HCA (). 与 V4.1 不同, 它是 CSA-HCA 混合, 且 每层独立持有自己的全局缓存 (无跨层复用). 每条目格式:
Main KV 条目: 448 通道非 RoPE FP8 (448 B) + 64 通道 RoPE BF16 (128 B) + FP8 Scale(8 B) = 584 B CSA Indexer K: 128 维 MXFP4 = B . HCA 无 Indexer.
相对于DeepSeek-V4-Flash, KV Cache节省的收益来源如下:
| 步骤 | 变化 | 或格式 | B/token | 因子 |
|---|---|---|---|---|
| V4-Flash | 41 层独立 (21 CSA + 20 HCA ) | - | 3514 | - |
| + 跨层复用 | 坍缩为 4 个存储来源 (仍 , 仍 V4 格式) | 652 | ||
| − 放松序列压缩 | : 4 2 (Encoder) / 1 (Decoder) | 1630 | ||
| + FP4 Main KV | 584 B 288 B / 条目 | - | 890 | |
| 净效果 | 890 |
3.2 从计算机体系结构的视角
在去年年初的文章《谈谈大模型架构的演进之路, The Art of memory.》 提到过一个观点, 把整个Transformer block 当作一台计算机来看:
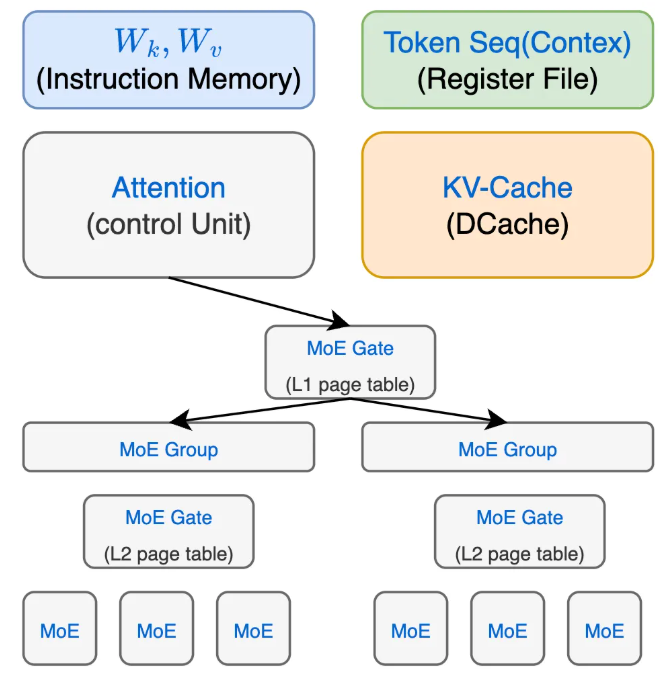
那么在体系结构的视角看, 我们要尽可能的提高 Cache 的命中率, 实质上就是需要跨层复用 KVCache. 而如果我们把一个整体的Encoder/Decoder ( 1x Full + B x Reuse ) block 看成一个递归 Transformer 的架构, 那么不同层的 MoE 正好构成不同的页表. 接下来根据这个观点, 把一层 CSA2 看成一台小计算机, 三种模式就是同一套数据通路在三种缓存命中状态下的运行.
按数据生命周期, 一层 CSA2 分为三个体系结构层次:
Compute (执行单元): 每层新算的 Main Q 与 SWA KV 是本地操作数 (像每条指令新取的寄存器操作数), 主注意力 sparse_attn是执行单元本身.Cache (片上共享缓存): Main KV, Indexer K, TopK indices, HSI 候选池是跨层共享的可复用状态, 由某个源层写入, 被后续多层读取. Memory (大容量后端): 每层的 MoE / FFN 是大容量存储与变换, 承接注意力输出.
关键对应: Main Q 与 SWA 永远是"新取操作数", 从不进共享缓存; 而 Main KV / Indexer K / TopK 是"可缓存状态", 是否重算取决于命中与否.
把三类共享状态的读写列成访问模式表:
| 模式 | Main KV | Indexer K | TopK indices |
|---|---|---|---|
| Full | 写 (fill) | 写 (fill) | 写 (compute) |
| Reindex | 读 (hit) | 读 (hit) | 写 (recompute) |
| Reuse | 读 (hit) | 不访问 | 读 (hit) |
于是三种模式恰是三种缓存状态:
Full = 缓存缺失后的写回填充 (write-allocate): 执行单元算出全部可缓存状态并写入, 代价最高. Reindex = 数据命中, 地址重算: 数据 (Main KV, Indexer K) 命中, 只重跑地址生成得到新 TopK, 像缓存行常驻但重做一次地址翻译. Reuse = 全命中 (full hit): 数据与地址都命中, 执行单元只用新操作数 (Main Q, SWA) 做一次读出, 是最接近纯 load 的路径.
CSA2 的 Indexer 对应 CPU 的地址生成单元 (AGU) 与 TLB: 它不搬运数据, 只产出"读哪些条目"的地址集合 TopK. 主注意力是数据通路, 按地址去共享缓存取 Main KV 再计算.
Full: AGU 全速运行, 扫描全部因果可见位置产生地址, 同时填充数据. Reindex: 数据缓存常驻, 只重启 AGU 在受限范围内重新翻译地址. Reuse: 连 AGU 都跳过, 直接复用上次的地址向量, 等于把昂贵的地址计算做了一次公共子表达式消除 (CSE) 与结果记忆化 (memoization).
地址生成与数据通路的解耦 HSI 候选池是一张 TLB 或工作集约束. layer 20 选出 2048 块共 16384 个位置, 等于为后续 Reindex 层建立一张限定可寻址范围的页表: Reindex 的地址重算只能落在覆盖页内 (), 池外位置根本不可寻址. 两级 TopK (先块后位置) 就是两级页表: 先用块级最大分数选页, 再在页内选具体条目.
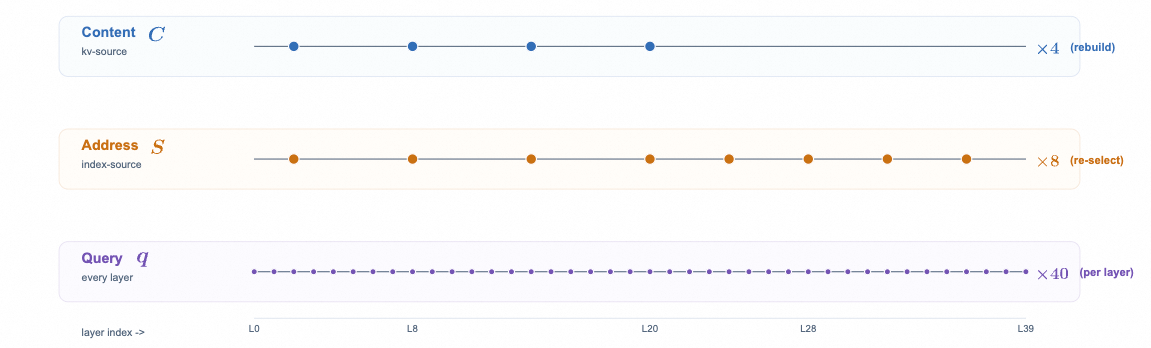
三个时钟域 :通常我们可以把 Q 看做是一个查询, TopK 一类的稀疏选择看做是一个地址, Main KV 看做内容(更加准确的定义参考下一节). 实际上 CSA2 的三个模式构成了三个刷新时间尺度 (内容 ×4, 地址 ×8, 查询 ×40) 像三个时钟域或三级存储的不同刷新率: 查询是寄存器级每拍更新, 地址是 L1 级中频回填, 内容是 L2/L3 级低频回填. 越靠近执行单元刷新越快越便宜, 越靠近共享后端刷新越慢越贵. CSA2 的模式调度就是把每类状态放到与其重算成本匹配的刷新率上.
3.3 跨层共享 KV 的数学原理
3.3.1 注意力的三类自由度 (内容, 地址,查询)
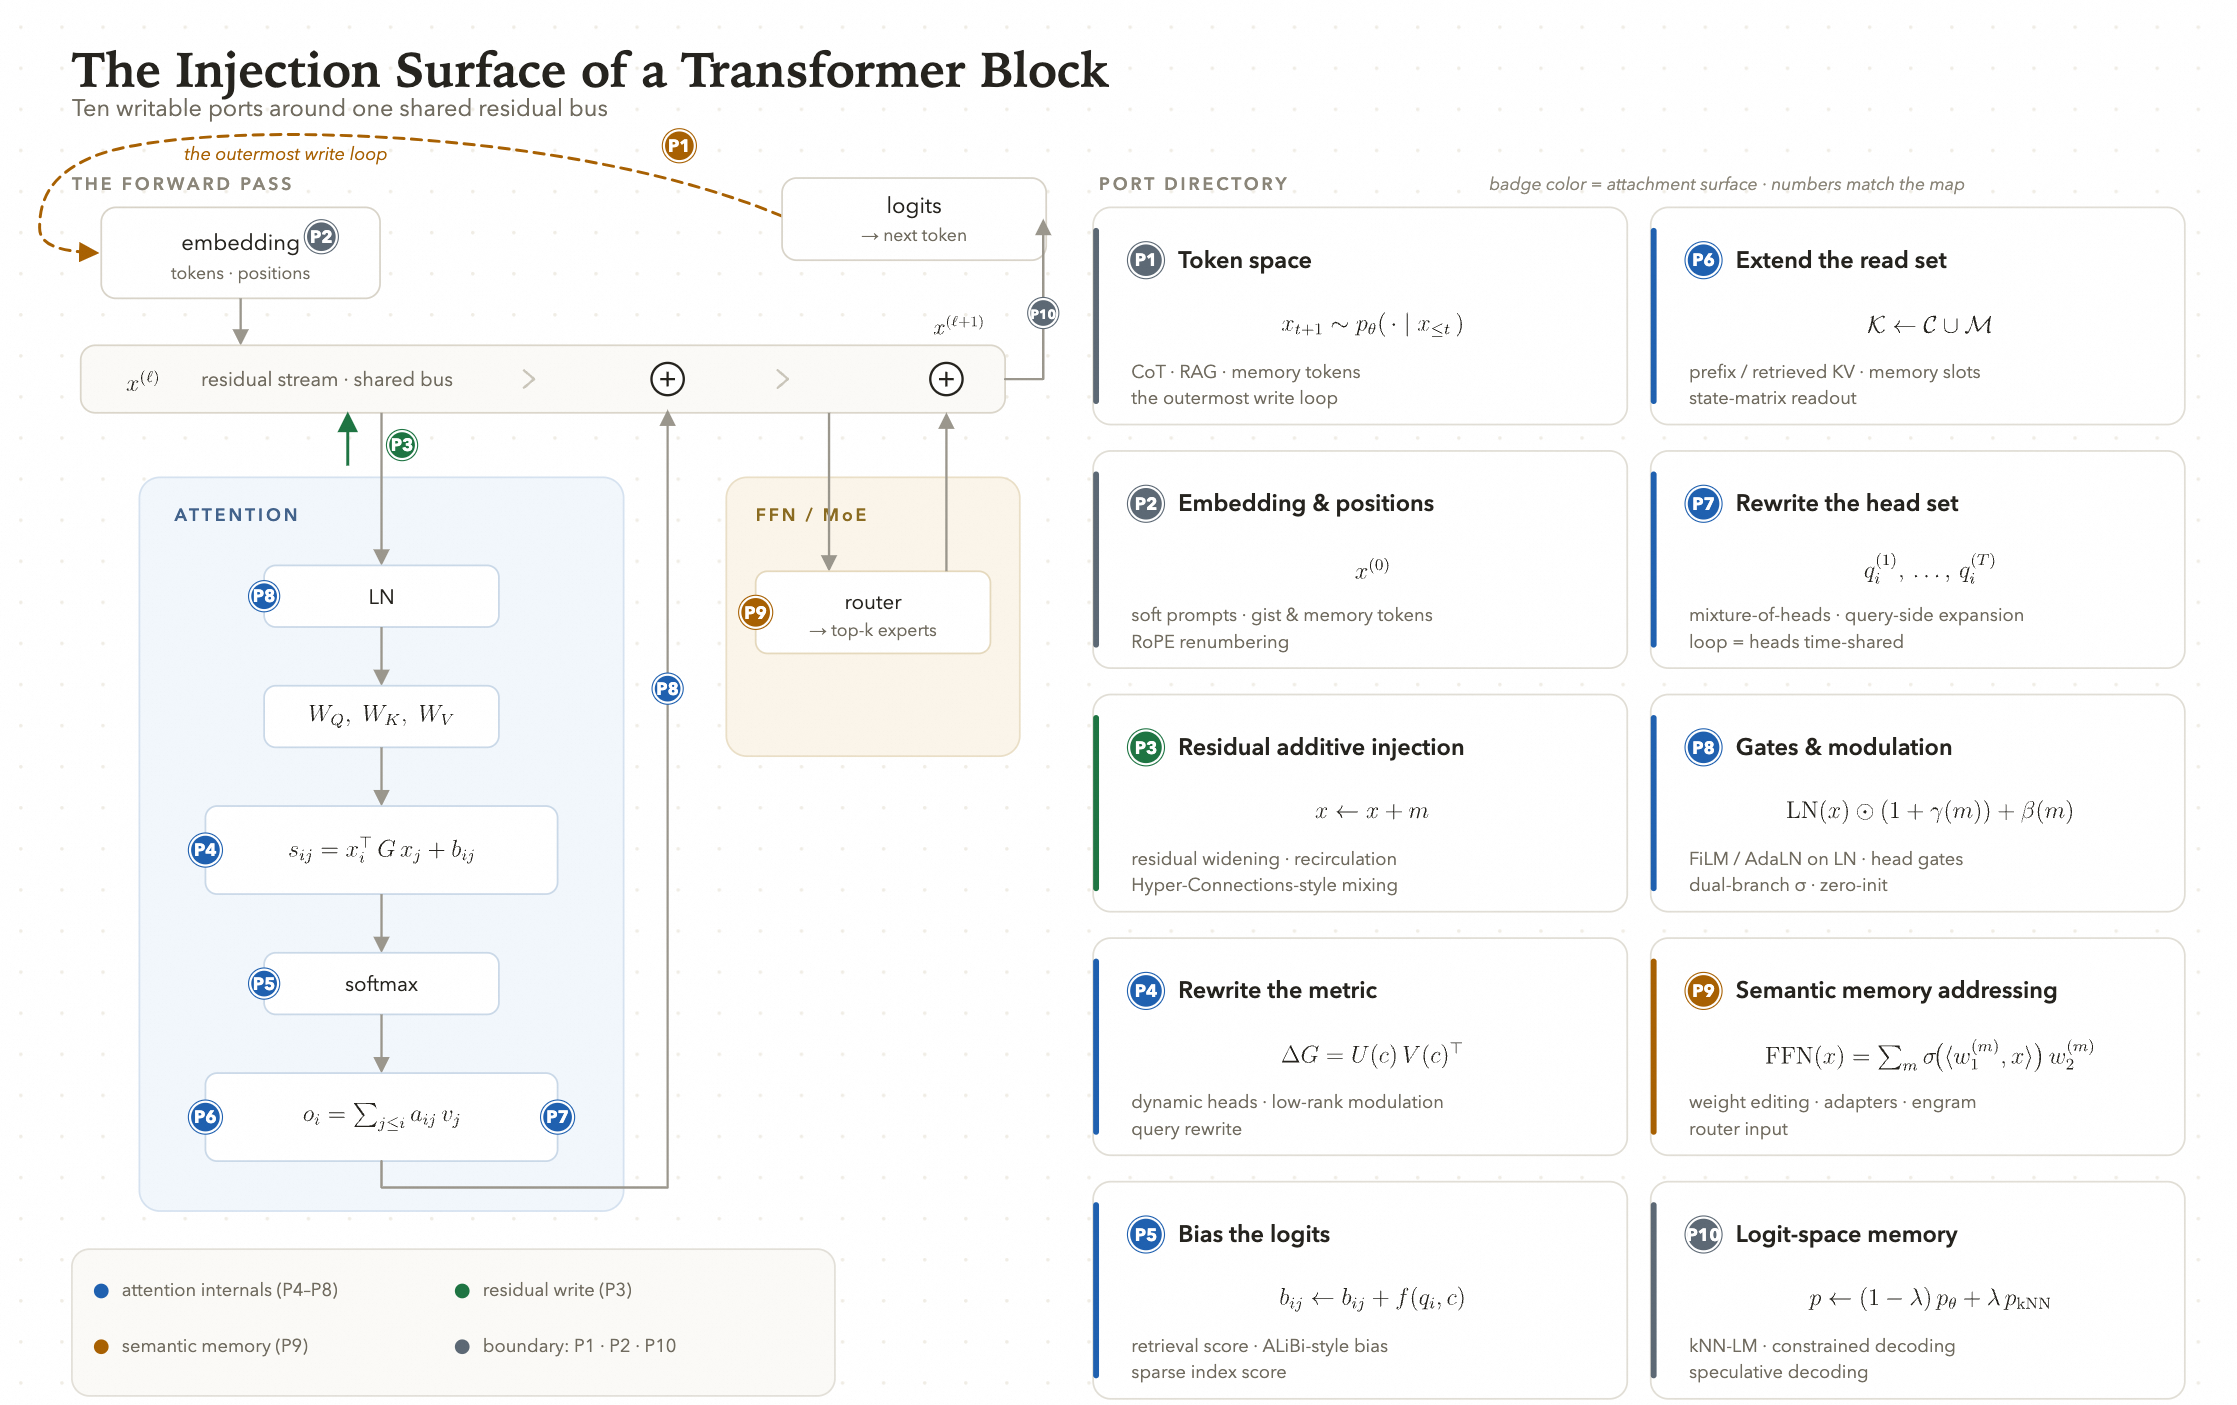
在《谈谈未来的Transformer: Loops Are Not What You Need》中介绍过, 对于一个 transformer block 上可注入的面为: 残差 , 归一化的增益偏置, 度量 , 偏置 , 求和范围 , head 集合 , 输出门, 以及后续 FFN, 总结了一个图如下:
针对 Sparse Attention, 任意一次稀疏注意力读出, 本质上只由三个可变输入决定. 把查询位置 的读出写成
三个可变输入扮演互不重叠的角色.
内容 是把历史压缩后得到的一组内容向量 . 参考实现里同一个 同时充当 K 和 V (key = value = ): 算权重时它作 Key, 出现在指数的内积 中; 出结果时它作 Value, 出现在加权和 中. 所以内容一次决定两件事, 一个条目与查询有多相似, 以及命中后读出什么 (读出载荷); 这与标准注意力把 K V 分成两套投影不同. 地址 决定这次求和在哪些内容向量上归一化, 即从哪些位置读; 查询 决定这些向量之间的权重方向. 输出 是被选内容向量的加权平均 (凸组合, 也称重心), 落在它们张成的凸包 内. 内容, 地址, 查询这三者就是"注意力的三类自由度".
三类自由度的定义, 数学类型, 语义角色与生成成本各不相同.
内容 : 读什么 (可读字典)
定义: , 由门控池化压缩器 在 kv-source 层对全部已发布主条目生成, 参考实现中 key = value = . 类型: 连续张量 , 光滑可微; 它是输出所在凸包 的顶点集. 角色: "读什么". 内容给出可被检索的语义载体; 没有它, 地址与查询都失去指向对象. 成本: 最贵. 压缩器要扫描全部可见历史, 是 级的全局计算.
地址 : 从哪读 (稀疏寻址)
定义: , 由 Indexer 对候选打分后选出. 类型: 离散组合对象 , ; 不可微 (TopK 几乎处处零梯度). 角色: "从哪读". 地址限定读出只在被选内容向量上归一化, 即选定凸包用哪些顶点. 成本: 中等. Indexer 需对候选集打分: Full 层扫全部因果可见位置, Reindex 层只扫候选池 (最多 ).
查询 : 怎么读 (读出方向)
定义: , 每层由本层参数从当前隐藏态算出 类型: 连续向量 , 光滑可微. 角色: "怎么读". 在 固定后, 查询决定权重分布 , 即被选内容向量之间的读出方向. 成本: 最便宜. 只是当前隐藏态的本层投影, 逐 token , 不扫历史.
三者的三重非对称性是 CSA2 全部设计的支点:
连续 vs 离散: 连续可微, 离散不可微. 训练梯度只能沿 流动, 只能由一条独立的, 以主注意力为教师的蒸馏路径来学 (第四部分). 本地 vs 全局: 是本层本地投影, 要压缩全局历史, 要对全体候选打分. 生成成本上 . 快变 vs 慢变: 历史的语义内容 层间变化最慢, 值得关注的地址 中速漂移, 每层的读出方向 变化最快.
三者还有一条单向依赖链. 地址由 Indexer 对内容打分得到, 故 依赖 ; 查询只在 给定后注入读出端决定权重. 记为
因此复用只能沿依赖链自上而下: 可以复用内容并连带复用地址 (Reuse), 可以复用内容却在同一内容上重选地址 (Reindex), 但不能换了内容却复用旧地址, 于是 CSA2 三种模式, 就是"刷新哪几类自由度"的三种选择:
| 模式 | 内容 | 地址 | 查询 | 刷新的自由度 |
|---|---|---|---|---|
| Full | 新算 | 新选 (全扫) | 新算 | 三类全刷 |
| Reindex | 复用 | 新选 (池内) | 新算 | 地址 + 查询 |
| Reuse | 复用 | 复用 | 新算 | 仅查询 |
3.3.2 Reuse 模式是基于查询扰动
固定一层 , 记其输入隐藏态为 , 单个 token 为 . 一层 CSA2 的主注意力需要四个张量: Main Q, Main KV 内容, Top-K 选择集, 局部 SWA KV. 下面先逐个给出定义, 再证明 reuse 模式把它们中三个冻结, 只留查询可变.
Main Q 由本层参数从当前隐藏态算出, 三种模式一致:
其中 是位置 的 RoPE, 只作用在 rope 尾通道, 每层有独立的 .
Main KV 内容只在 kv-source 层由压缩器 生成; 是门控池化, 时退化为逐 token 投影:
Top-K 选择集 只在 index-source 层由 Indexer 生成 , 为 Indexer查询, 为逐头权重:
局部 SWA KV 每层新算:
读出 把 SWA 与选中 Main KV 拼成一次联合 sparse attention :
其中 .
引入两个来源映射: 为层 的Main KV 源, 为其索引源; 层自身生成时取 或 . 用指示量 与 , 把内容与选择统一写成分段函数:
三种模式恰好是这对指示量的取值组合:
即 Full 同时新生成内容与选择, Reindex 复用内容但重生成选择, Reuse 两者都复用; 对 reuse 层 , 内容与选择都取自更早的源层, 与本层隐藏态 无关, 故其对 的偏导为零:
把这两个零偏导代回读出映射, 对本层输入的依赖就分解为两条新鲜通道加两个冻结常量:
对被冻结的全局记忆 而言, 唯一携带 依赖的通道是查询 ; SWA 是另一条独立的新鲜局部通道, 按固定 128 窗口逐层重建, 不触碰全局记忆. 因此 reuse 层对全局记忆的层间适应, 数学上恰好收缩为一次查询改写
其中 是索引源层发布选择时所用的基线查询, 是本层的可学习扰动. 这个 正是后续展开分析的对象.
3.3.2.1 主注意力可以写成固定字典的读出
设 reuse 层的候选集 , 把被复用的缓存向量按行堆成 . 因为 key = value = , 注意力输出是
由于 是一族非负, 求和为 的权重, 输出 是字典向量 的一个凸组合. 因此
输出被锁在一个顶点固定的凸多胞形里, 改写 只能移动它在该凸包内的位置.
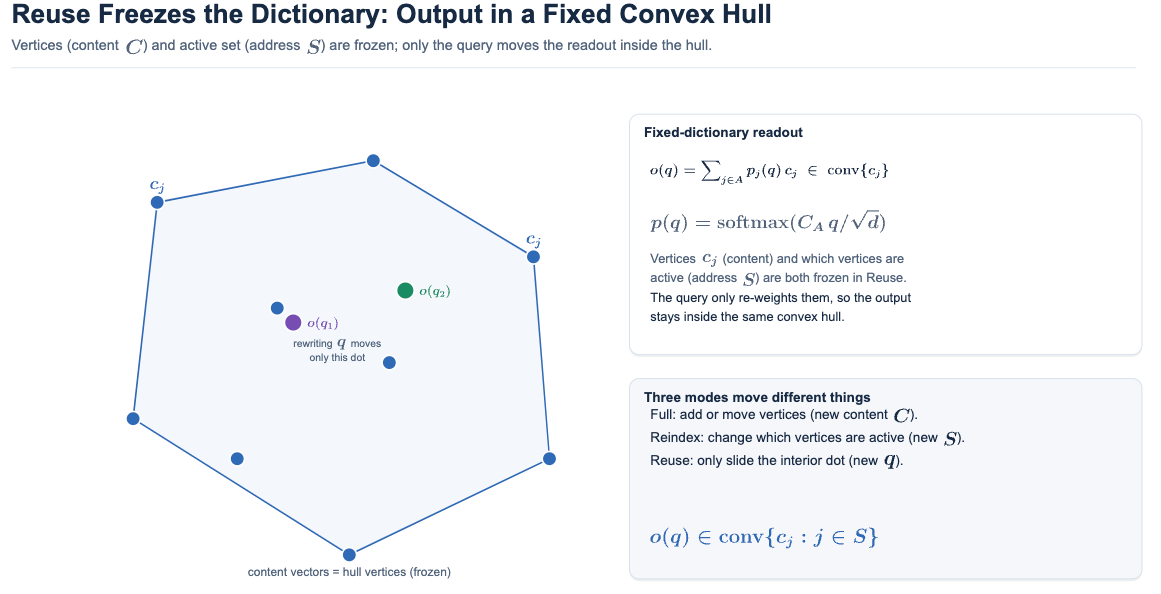
接下来要回答的问题是: 移动 究竟能覆盖这个凸包的多大范围?
在 DeepSeek-V4.1-Flash 配置里 (head_dim), (sliding_window), (index_topk), 故候选集大小 .
3.3.2.2 改写 Q 等价于对基线分布做指数倾斜
把源层的查询记为 , 基线分布 . reuse 层的任意查询都可写成扰动形式 . 代入 (D1), logit 只多了一项 , 于是
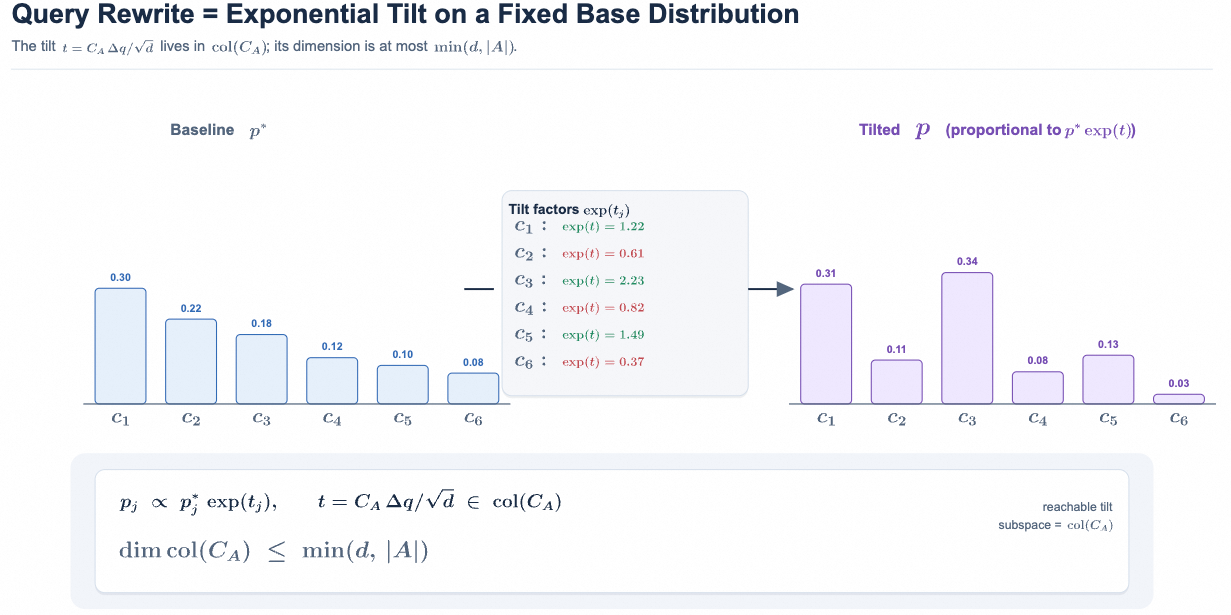
这说明查询扰动 把基线分布沿方向 做一次指数倾斜 (exponential tilting) 再归一化. 可实现的倾斜集合是
若 (需 ), 则任意重加权都可达. DeepSeek-V4.1-Flash 配置里 , 故倾斜被限制在一个至多 维的子空间内.
3.3.2.3 reuse 输出能覆盖多大范围
令字典向量 (即 的各行, ), 基准权重 (即基线分布 , 满足 ), 缩放常数 . 把查询整体记为 (吸收了 与 的合并), 定义
就是 (D1) 中的注意力权重 , 是其归一化所需的对数配分函数. 注意力输出记为均值映射
于是"输出能覆盖多大范围"这一问题, 可以看做"均值映射 的像集是什么". 在查询可自由遍历 , 或其有效线性子空间 , 且 时, 均值映射的像为
但是, 这是一个能力上界, 它描述"若查询完全自由, 最多能达到什么". 而真实模型的归一化, 共享查询瓶颈与有限参数不保证访问全部 .
3.3.2.4 仅改写 Q 的表达力
那么为什么这个查询扰动 在冻结 Main KV 时仍然有很强的表达力?
保留整个注意力单纯形. 在秩允许范围内, reuse 层仍能把质量压到单个被选条目 (逼近某顶点), 摊平, 或任意软插值. 共享地址不等于共享输出. 全程可微, 零重检索成本. 倾斜 对 光滑, 梯度正常回流, 每层可专门化对同一记忆的读法; 被跳过的 Indexer 打分与非可微 TopK 都不重复. 几何对齐. key = value = , 增大 同时上调 权重并把输出拉向 , 扰动对输出位置是直接可解释的控制. 全局与局部配比也归 管. SWA 与Main KV 同处一次 softmax, 还在冻结的全局记忆与新鲜局部窗口之间分配质量.
另一个潜在的推测是我们可以通过某种可学习的 Q 感知的参数, 将下一层的 KV 空间映射会当前层实现复用.
具体来看, 标准的 Transformer 中, 每一层的 KV 都会随着残差产生变化, 那么在层维度上构成一个高维空间的流形, 那么是否存在一种情况, 分离出, 将这些信息作为某种空间映射, 特别是在 mHC 又能够维持一个相对稳定的残差时, 使得后一层 KV 构成的空间可以通过一些参数 Q 感知的参数权重映射会前一层的 KV 构成的空间, 并让模型在训练阶段将这些空间映射的信息吸收到 MoE/FFN 和 Engram 中.
这样就使得 KV 可以固定, 而让 Q 感知的参数映射把它映射到一个恰当的位置? 即使存在一些缺陷无法弥补, 是否可以将这些缺陷从模型的层维度转换为更长的序列维度, 例如某种特殊的CoT 构成的一个新的固定的 KV 空间来表示?
这些内容在一些内部的文档中有所记载, 并正在进行相关的实验分析.
3.3.2.5 Reuse 与 Full 模式的差异
Full 层 有三个随层独立变化的自由度:
| 自由度 | Full | Reuse |
|---|---|---|
| (F1) 查询 | 有 | 有, 唯一保留 |
| (F2) 键值内容 , 移动多胞形顶点并改变倾斜几何 | 有 | 无, 冻结 |
| (F3) 选择集 , 哪些顶点存在, 离散 | 有 | 无, 冻结 |
对固定记忆 有严格包含 , 且 Full 还对所有 取并. 表达缺口恰好是三件 reuse 做不到的事:
召回上限: 的内容不在 中, 任何 都够不着, 并且上游 TopK 选择错误下游不可纠正. 顶点不可移: 输出被钉在固定凸包 内, Full 改 可把输出放到凸包之外. 倾斜几何不可换: reuse 的可达分布是由 决定的固定指数族, Full 重选 等于换掉整个族.
另外 RoPE 只是对 与 的 rope 尾施加位置相关正交旋转, 被吸收进内积 , 不改变上述凸包与倾斜论证.
3.3.3 Full / Reindex / Reuse 的协同
在模型层的维度上, 三种模式构成如下结构:
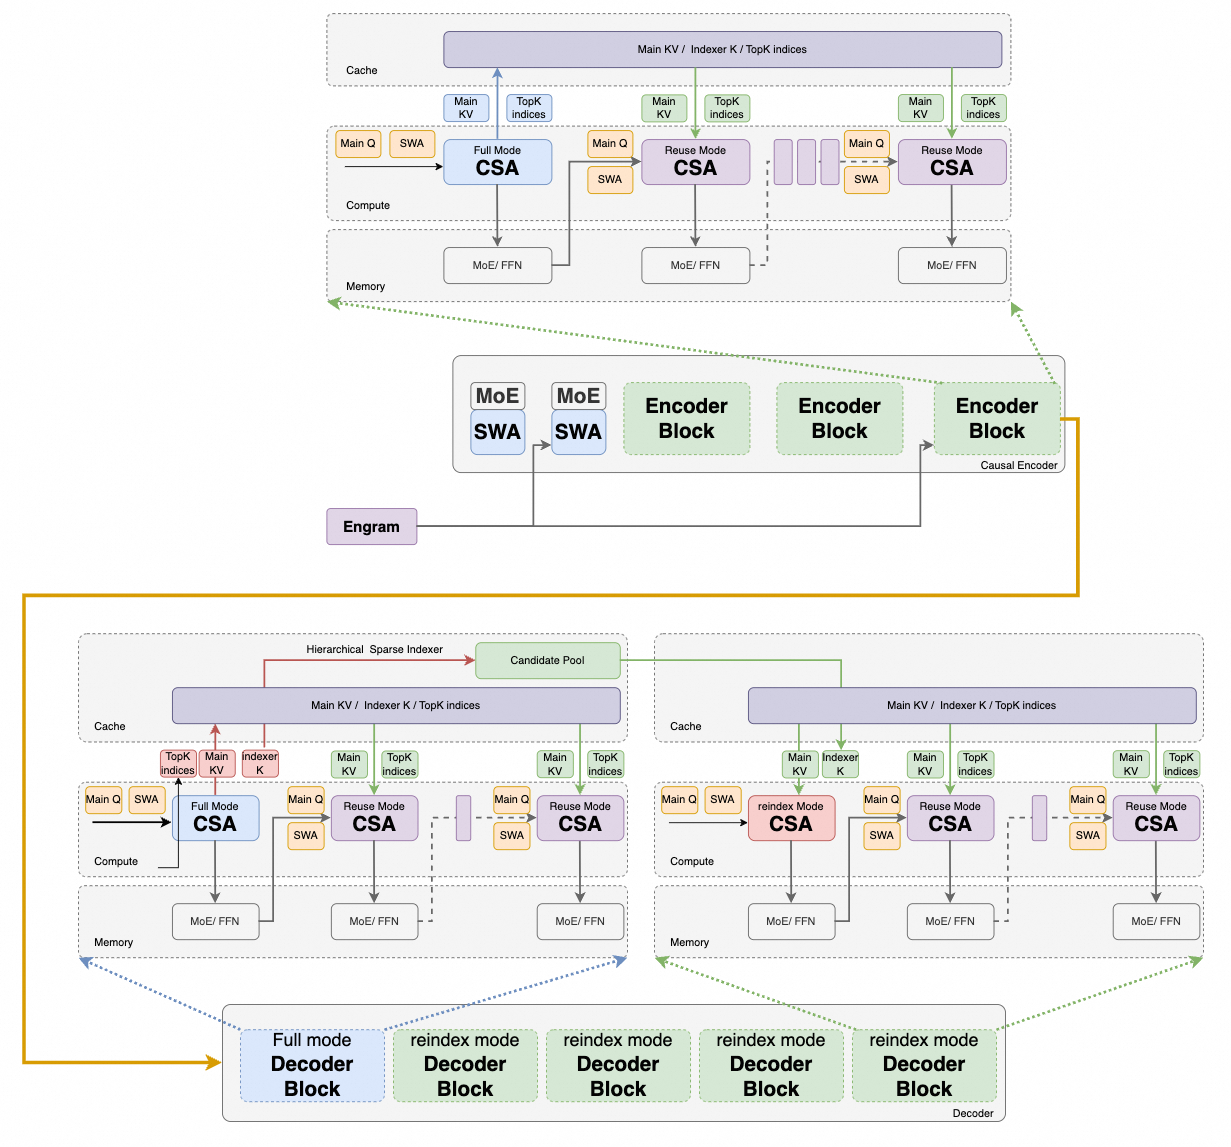
三种模式构成一个由粗到细的刷新调度, 对应三个时间尺度:
Full 重建 KV 缓存, 跑完整 Indexer 加 TopK, 是锚点. Reindex 保留内容, 在 HSI 候选池内重打分并重选 Top-K, 不重建 KV. Reuse 只做 Q 投影, SWA, 一次 sparse_attn, 不打分不 TopK 不写 KV.
在 Decoder 中还引入了 HSI, 于是三种模式在解码器里的分工是:
Full, 记为 (layer 20): 定义内容 , 定义候选池 (16384 个位置), 并给出自身 Top-512. Reindex, 记为 (24, 28, 32, 36): 内容不变, 在 内重选各自 Top-512, 即 . Reuse, 记为: 沿用最近索引层发布的 , 只改写查询.
DeepSeek-V4.1-Flash:Pushing the Limits of KV Cache Compression: https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/blob/main/DeepSeek_V41_Tech_Report.pdf
[2]You Only Cache Once:Decoder-Decoder Architectures for Language Models: https://arxiv.org/pdf/2405.05254
[3]Building Effective Sparse MoE Models with Moderate Resources: https://welm.weixin.qq.com/en/posts/building-effective-sparse-moe-models-with-moderate-resources/#kv-mirror
[4]PowerAttention: Exponentially Scaling of Receptive Fields for Effective Sparse Attention: https://arxiv.org/abs/2503.03588
[5]Reducing Transformer Key-Value Cache Size with Cross-Layer Attention: https://proceedings.neurips.cc/paper_files/paper/2024/file/9e23d020c18e4c40d81c6a0fc7a46f68-Paper-Conference.pdf
[6]IndexCache: Accelerating Sparse Attention via Cross-Layer Index Reuse: https://arxiv.org/abs/2603.12201
[7]You Only Index Once: Cross-Layer Sparse Attention with Shared Routing: https://arxiv.org/pdf/2606.06467
[8]HySparse: A Hybrid Sparse Attention Architecture with Oracle Token Selection and KV Cache Sharing: https://arxiv.org/pdf/2602.03560
[9]HISA: Efficient Hierarchical Indexing for Fine-Grained Sparse Attention: https://arxiv.org/pdf/2603.28458v1