本文基于 RL101, RL102, RL103, RL104 四篇材料重新组织. 阅读后你应该能够:
- 把 LLM 的生成过程翻译成 Reinforcement Learning 的语言.
- 理解 SFT, Reward Model, REINFORCE, Actor-Critic, PPO 和 GRPO 的关系.
- 看懂 Advantage, Importance Sampling, Clip 和 KL penalty 等核心公式.
- 区分 RLHF, ORM, PRM, RLAIF 和 RLVR 的奖励来源.
- 理解 DeepSeek-R1 为什么能用 RL 激励推理, 以及大规模训练为何仍然容易不稳定.
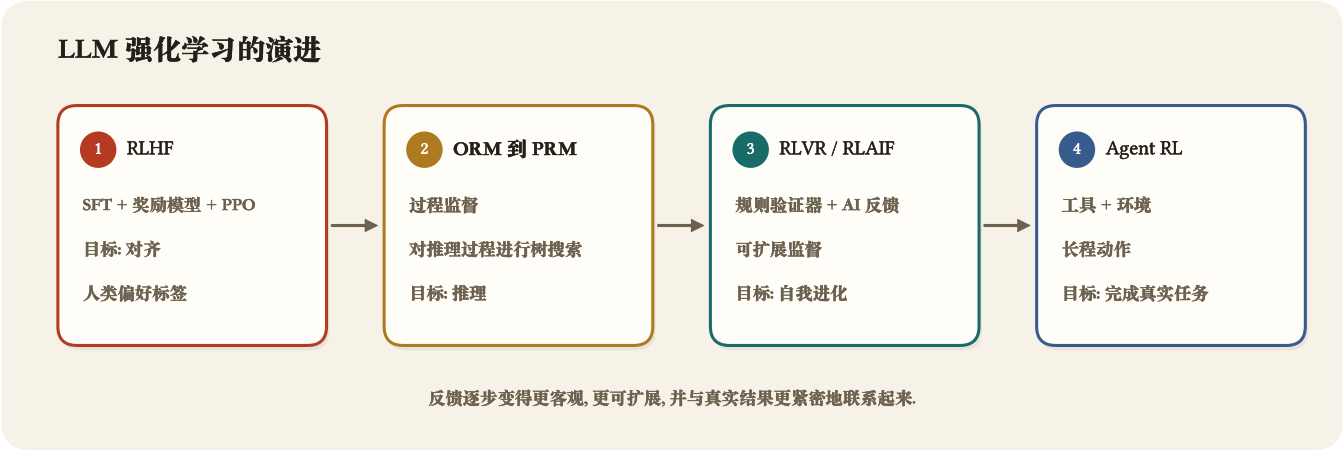
1. 先用一句话理解 LLM RL
LLM RL 做的事情可以概括成一句话:
让模型自己生成答案, 用 Reward 判断答案好坏, 再提高好答案的生成概率, 降低坏答案的生成概率.
这里最容易混淆的是 SFT 和 RL.
- SFT 说: "这是标准答案, 请模仿它."
- RL 说: "你先自己回答. 这个结果得了 8 分, 那个结果得了 2 分. 请改变策略, 以后更容易得到高分."
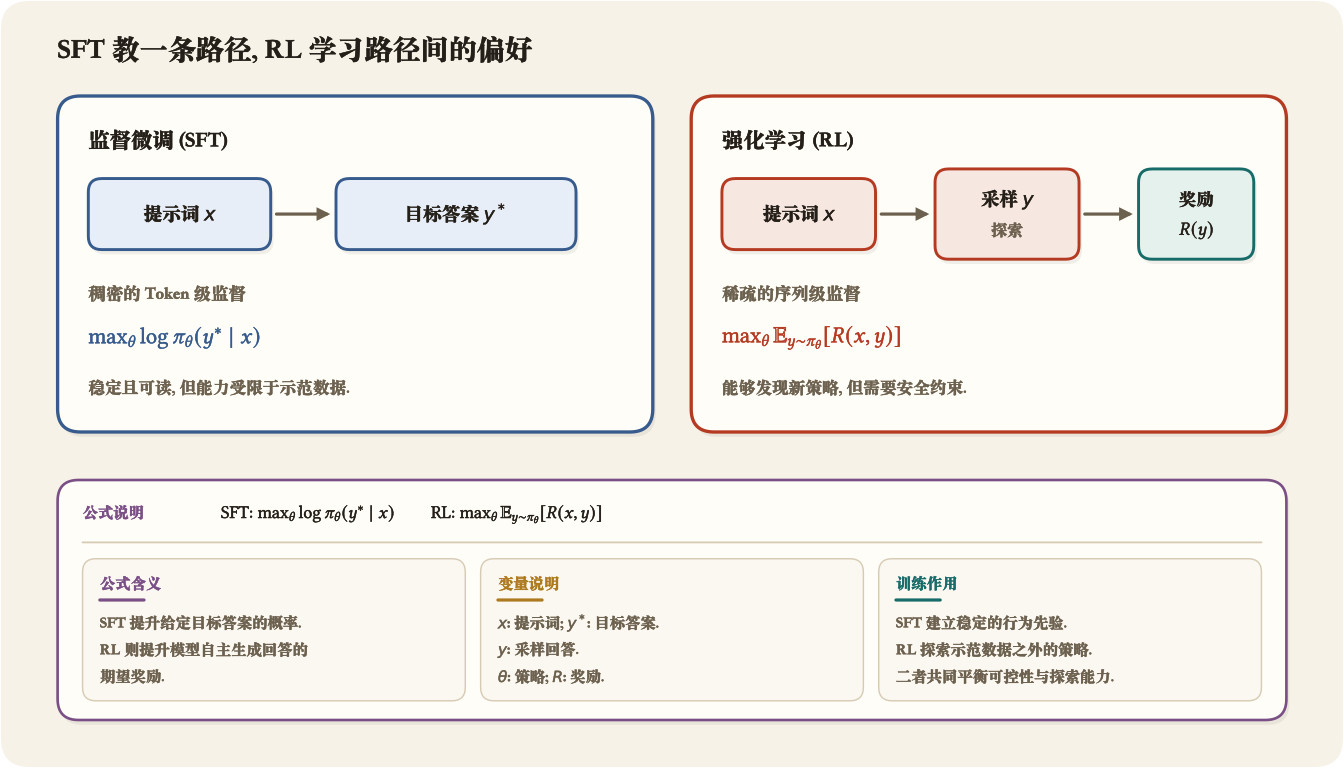
这一区别看起来很小, 实际上决定了能力上限. SFT 擅长稳定地传授格式, 风格和已知解法. RL 则允许模型探索训练数据中没有直接展示过的新策略. 代价是 RL 更昂贵, 更容易不稳定, 也更容易钻 Reward 的空子.
2. 把 LLM 翻译成 RL 的语言
传统 RL 常用机器人走迷宫来解释. 对 LLM 来说, 迷宫就是一段尚未写完的文本.
给定 Prompt $x$, 模型逐个生成 Token:
公式含义: 一次完整回答 $y$ 不是一个不可拆分的整体, 而是模型按时间顺序生成的 Token 序列. 每次只选择一个 Token, 连续选择 $T$ 次后才得到完整回答.
变量说明:
- $y$: 模型针对当前 Prompt 生成的完整 Response.
- $y_t$: 第 $t$ 个生成 Token, 也是第 $t$ 步采取的 Action.
- $t$: 生成步骤的索引, 从 $1$ 递增到 $T$.
- $T$: 回答的总 Token 数, 也可以理解为这次 Episode 的长度.
- $\ldots$: 表示中间尚未逐项写出的 Token.
在训练中的作用: 这个表示把文本生成转换成 Sequential Decision Making. 后续的 Log Probability, Reward 和 Advantage 都可以沿着这条 Token 序列计算或分配.
在第 $t$ 步:
- State $s_t$: Prompt 加上已经生成的前缀 $(x, y_{<t})$.
- Action $a_t$: 选择下一个 Token $y_t$.
- Policy $\pi_\theta$: LLM 给出的下一个 Token 概率分布.
- Trajectory $\tau$: 从第一个 Token 到完整回答的整条生成轨迹.
- Reward $R$: 对完整回答或中间步骤的评分.
- Episode: 一次完整回答.
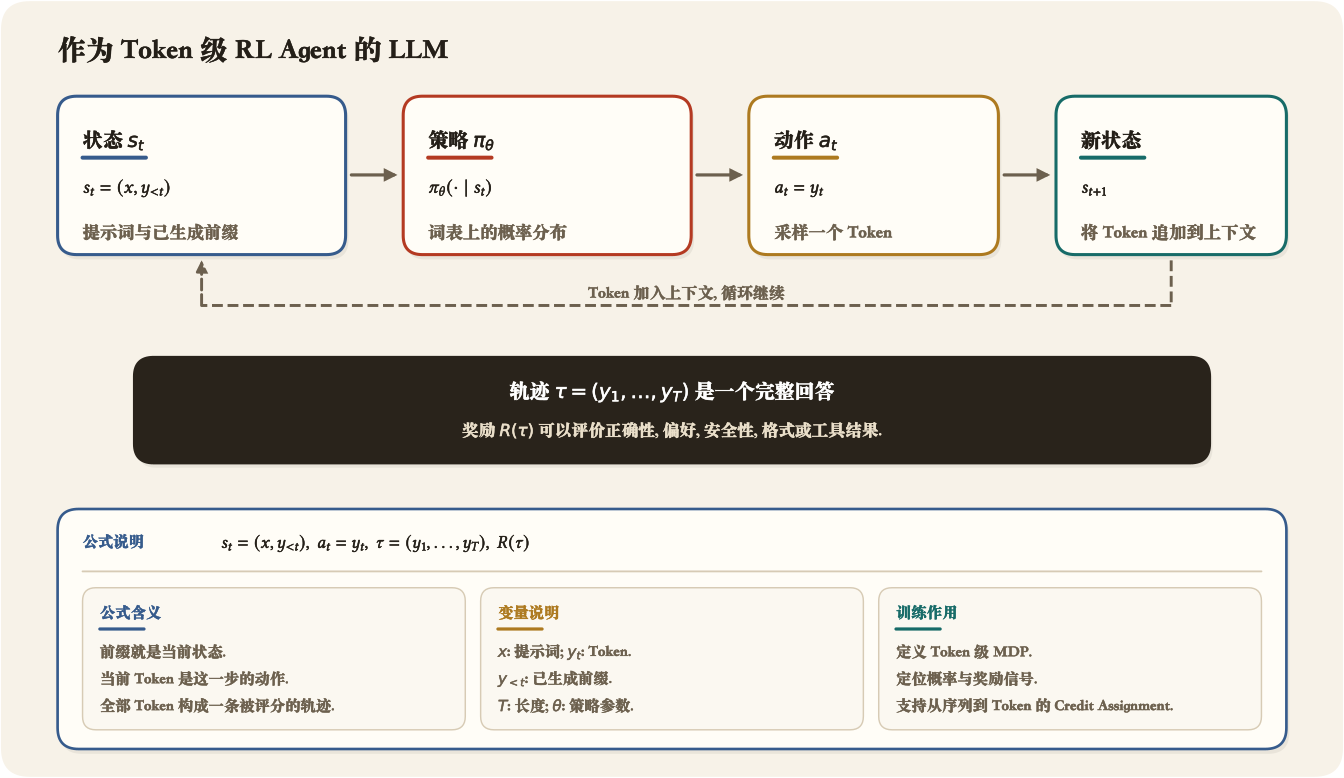
自回归模型生成整段回答的概率是每一步条件概率的乘积:
公式含义: 模型生成整段回答的概率, 等于每一步在已有上下文下生成当前 Token 的条件概率之积. 前面任何一步选择不同, 后续条件分布都会随之改变.
变量说明:
- $\pi_\theta$: 参数为 $\theta$ 的 Policy, 在这里就是待训练的 LLM.
- $x$: 输入 Prompt.
- $y$: 完整回答 $(y_1,\ldots,y_T)$.
- $y_t$: 第 $t$ 个 Token.
- $y_{<t}$: 第 $t$ 步之前的全部 Token, 即 $(y_1,\ldots,y_{t-1})$.
- $\pi_\theta(y_t\mid x,y_{<t})$: 给定 Prompt 和已有前缀时, 模型分配给 Token $y_t$ 的概率.
- $\prod_{t=1}^{T}$: 从第 $1$ 步到第 $T$ 步连续相乘.
在训练中的作用: 它定义了 Sequence Probability. PPO 和 GRPO 保存的 Old Log Probability, 以及 KL 和 Importance Ratio, 最终都来自这些逐 Token 条件概率.
取对数后, 乘积变成求和:
公式含义: 对 Sequence Probability 取对数后, Token 概率的连乘变成 Log Probability 的逐项相加. 很小的概率乘积不便数值计算, Log Space 则更稳定.
变量说明:
- $\log$: Natural Logarithm. 它保持大小关系, 并把乘法转换为加法.
- $\log\pi_\theta(y\mid x)$: 整个回答的 Sequence Log Probability.
- $\log\pi_\theta(y_t\mid x,y_{<t})$: 第 $t$ 个已生成 Token 的 Log Probability.
- $\sum_{t=1}^{T}$: 把所有 Token 的贡献累加起来.
在训练中的作用: 梯度可以对每个 Token 的 Log Probability 分别计算, 因而 Sequence-level Reward 能够乘到整条序列的 Token 梯度上. 实际实现通常也存储 Log Probability, 而不是直接存储容易下溢的 Probability.
这一步非常重要. 它说明即使 Reward 只在回答结束时出现, 我们仍然可以把它传回整段回答中的每个 Token.
RL 的总目标是最大化模型自己生成答案时得到的期望 Reward:
公式含义: 在许多 Prompt 和许多随机回答上取平均, 调整参数 $\theta$, 使模型长期获得的平均 Reward 尽可能高. 单个样本得分高并不够, 目标是整个 Sampling Distribution 的平均表现提高.
变量说明:
- $J(\theta)$: RL 要最大化的 Objective, 表示当前 Policy 的期望回报.
- $\theta$: Policy Model 的全部可训练参数.
- $\mathbb E$: Expectation, 表示对随机 Prompt 和随机回答求平均.
- $\mathcal D$: Prompt Dataset 或 Prompt Distribution.
- $x\sim\mathcal D$: 从数据分布中采样一个 Prompt.
- $y\sim\pi_\theta(\cdot\mid x)$: 根据当前 Policy 对 Prompt $x$ 进行随机 Rollout.
- $R(x,y)$: Judge 对 Prompt 与回答组合给出的标量 Reward.
- $\cdot$: 表示输出位置可以取任意可能回答, 即一整个条件分布.
在训练中的作用: 这是后续 REINFORCE, PPO 和 GRPO 共同想近似优化的总目标. 它也强调了训练数据会随 $\theta$ 改变, 因而 RL 是一个闭环过程.
注意期望中的 $y \sim \pi_\theta$. 数据不是固定答案, 而是当前模型自己采样出来的答案. 因此模型更新后, 下一轮看到的数据分布也会跟着改变. 这就是 LLM RL 与普通监督学习最根本的差别之一.
3. 一轮 LLM RL 到底发生了什么
一次典型训练迭代包含 5 步:
- 从 Prompt 数据集中抽取一批问题.
- 用当前 Policy 进行 Rollout, 为每个问题生成一个或多个回答.
- 用 Reward Model, Rule-based Verifier 或 Environment 给回答打分.
- 把 Reward 转成更适合优化的 Advantage.
- 用 PPO, GRPO 等算法更新 Policy, 然后重新 Rollout.
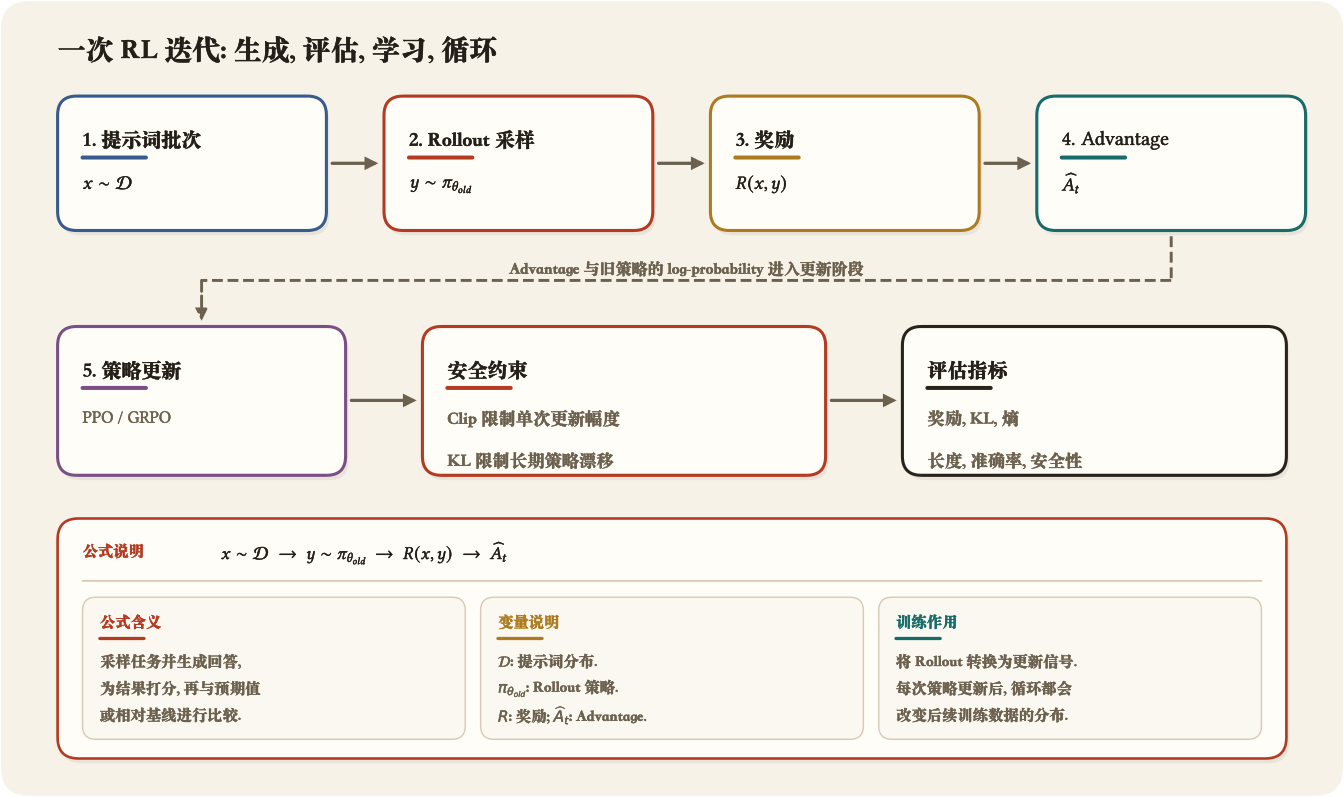
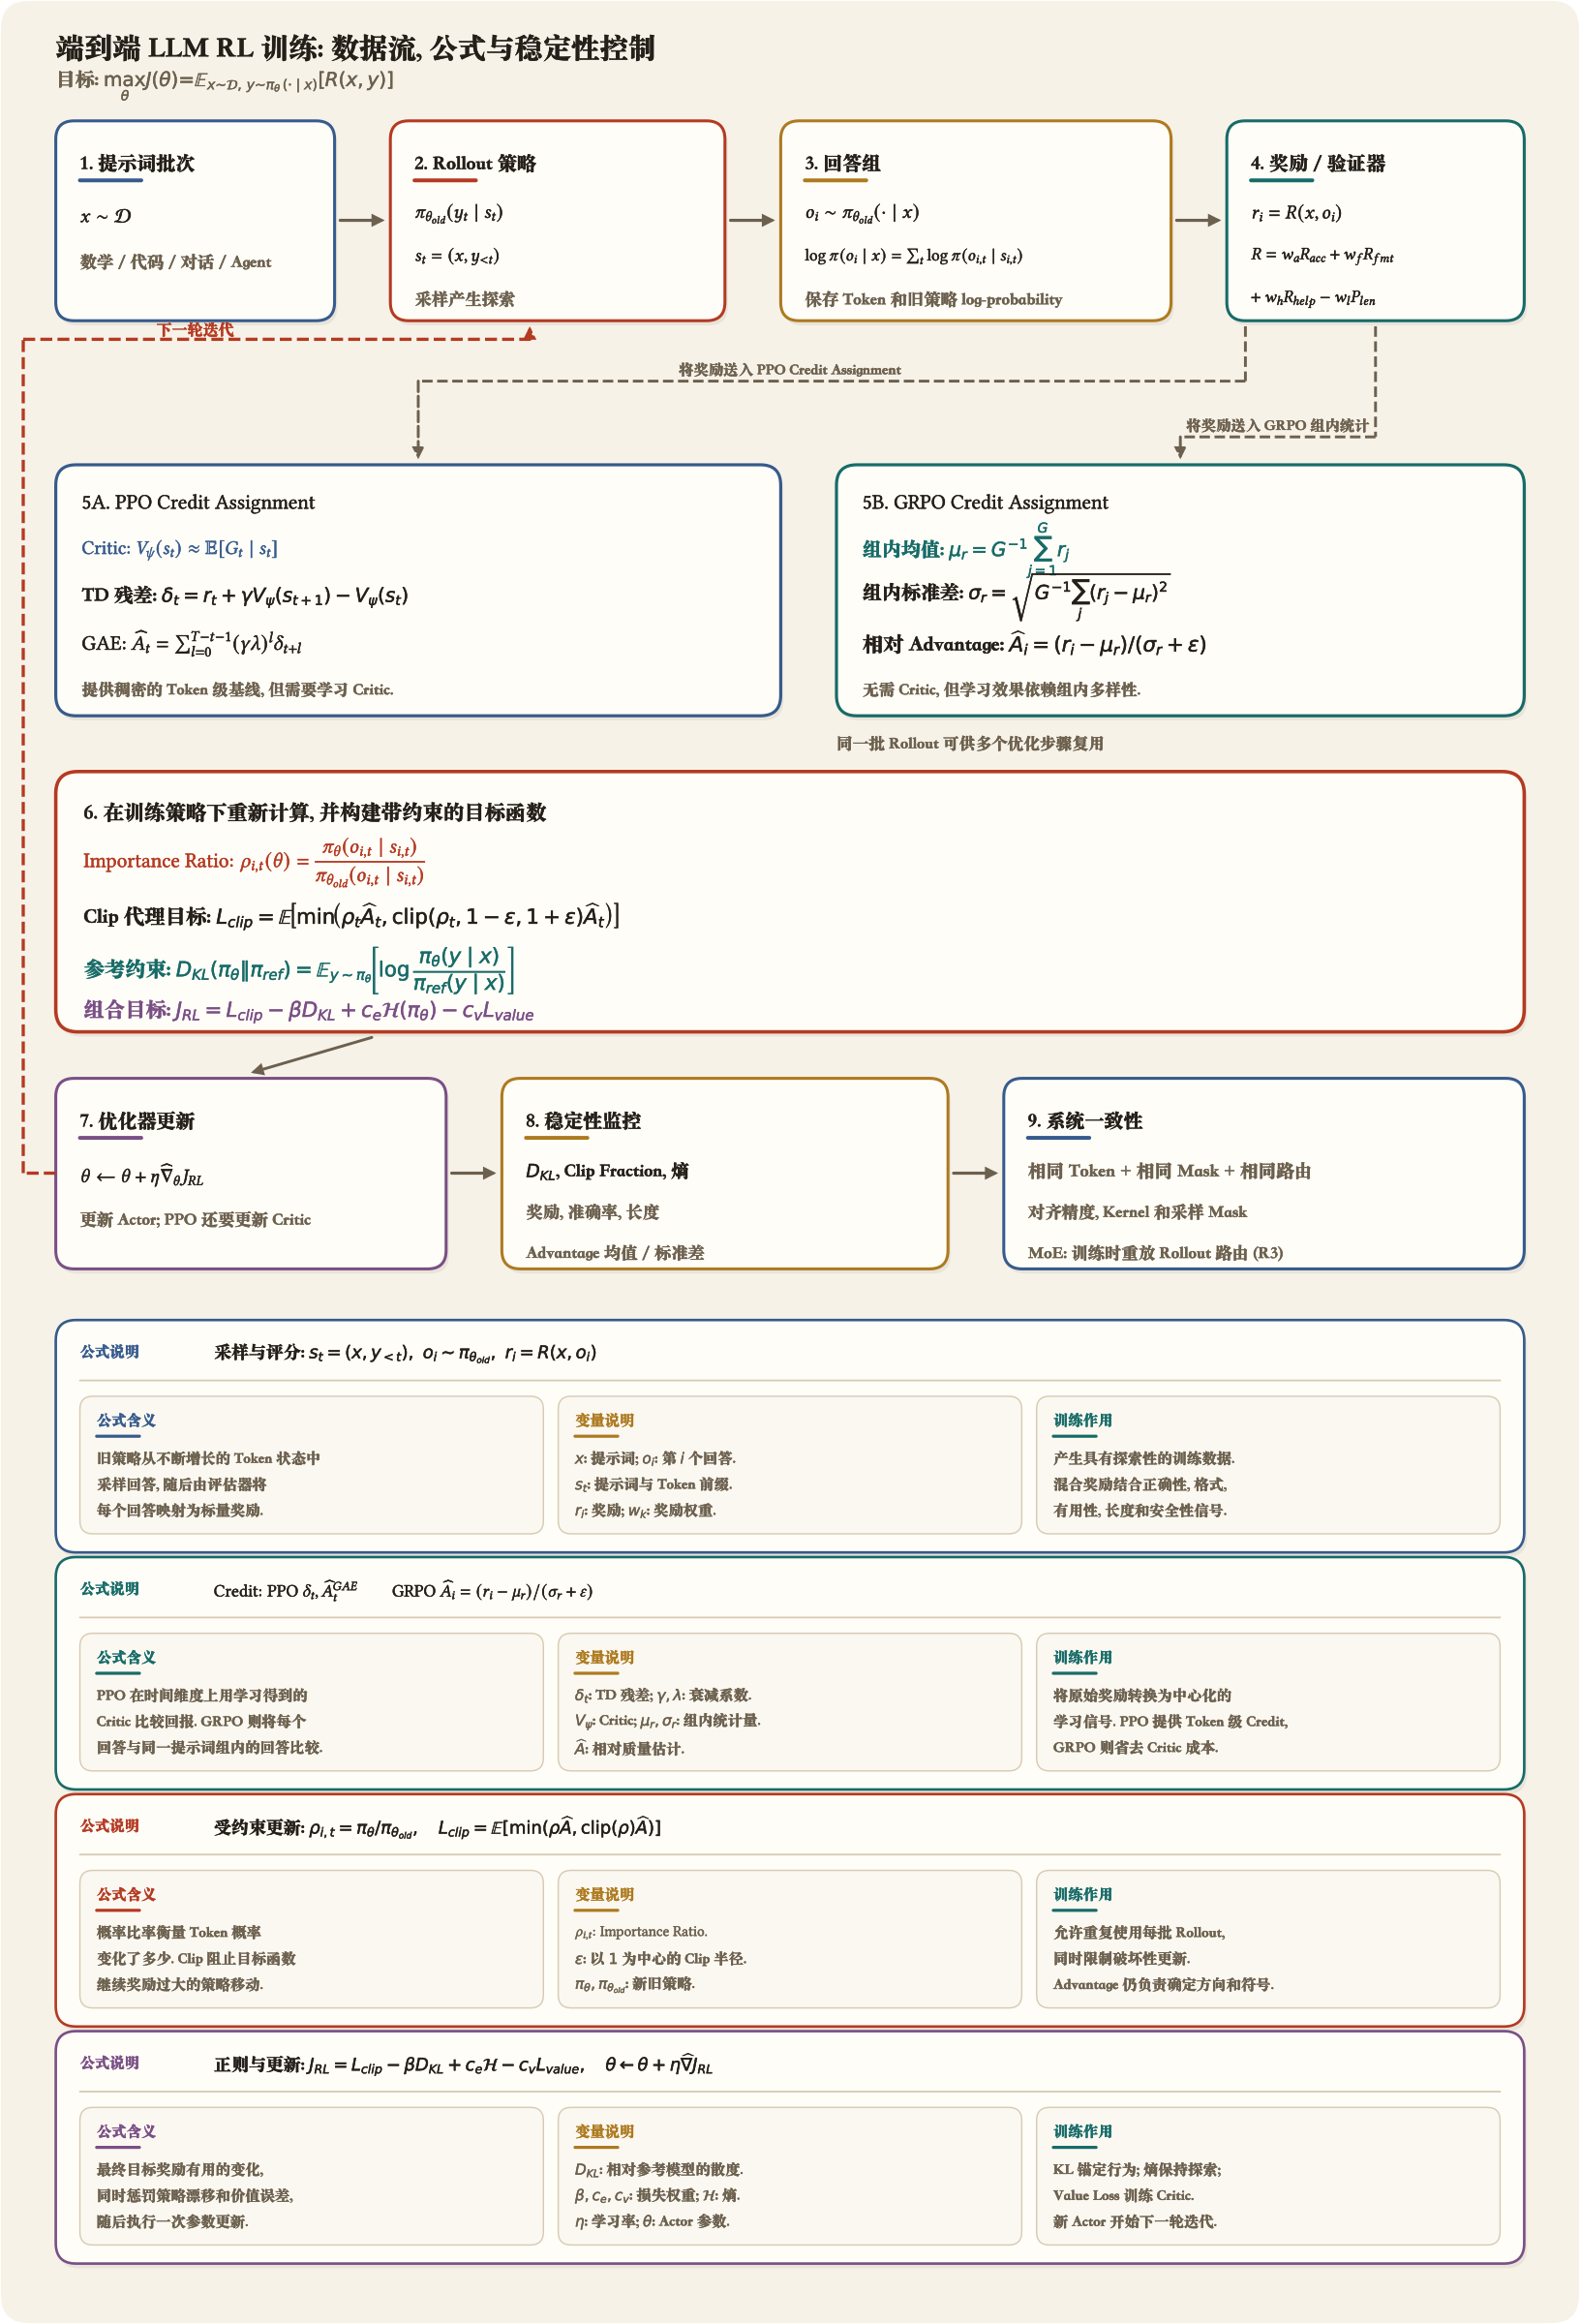
可以把它写成最简伪代码:
initialize policy pi_theta from an SFT model
initialize reference policy pi_ref

repeat:
    prompts = sample_prompt_batch()
    responses, old_logprobs = rollout(pi_theta, prompts)
    rewards = judge(prompts, responses)
    advantages = estimate_advantage(rewards, responses)

    for several optimization steps:
        new_logprobs = forward(pi_theta, prompts, responses)
        loss = clipped_policy_loss(
            new_logprobs,
            old_logprobs,
            advantages,
            pi_ref
        )
        update(theta, loss)

    evaluate reward, accuracy, KL, entropy, length, and safety
其中真正困难的并不是 update(theta, loss) 这一行, 而是下面 4 个问题:
- Reward 是否真的代表我们想要的行为?
- 最终 Reward 应该怎样归因到数千个 Token?
- 旧 Policy 生成的数据还能被新 Policy 使用多久?
- Rollout 系统和 Training 系统是否真的计算了同一个模型行为?
后面的所有算法, 几乎都在回答这 4 个问题.
4. RL 之前: Pretraining, SFT 和 Rejection Sampling
4.1 Pretraining 让模型会续写
Pretraining 的核心是 Next Token Prediction. 对语料中的 Token 序列, 最小化负对数似然:
公式含义: Pretraining 要让语料中真实出现的下一个 Token 获得更高概率. 因为训练过程最小化 Loss, 所以在 Log Likelihood 前加负号, 把 "最大化正确 Token 概率" 改写为 "最小化负对数似然".
变量说明:
- $\mathcal L_{\text{PT}}$: Pretraining Loss.
- $\theta$: Base Model 的可训练参数.
- $\mathcal D_{\text{text}}$: 大规模自然语言, 代码等预训练语料分布.
- $w_{1:T}$: 从语料中取出的一段长度为 $T$ 的真实 Token 序列.
- $w_t$: 语料中的第 $t$ 个目标 Token.
- $w_{<t}$: $w_t$ 之前的真实 Token 前缀.
- $\pi_\theta(w_t\mid w_{<t})$: 模型根据真实前缀预测正确下一个 Token 的概率.
- 前面的负号 $-$: 将 Maximum Likelihood 转换成可最小化的 Loss.
在训练中的作用: 它建立语言建模能力和知识底座, 但优化目标只是预测语料, 并没有直接表达 Helpfulness, Safety 或任务成功率.
它让模型学到语言, 知识和一定的推理模式, 但并不天然理解 "用户提问后应该直接回答" 这种交互规范.
4.2 SFT 让模型会遵循指令
SFT 使用人工编写, 众包或强模型蒸馏得到的高质量 $(x,y^*)$ 数据. 目标是最大化标准回答 $y^*$ 的概率:
公式含义: SFT 在给定 Prompt 和标准答案前缀时, 提高标准答案下一个 Token 的概率. 它与 Pretraining 都是 Cross-Entropy / Negative Log-Likelihood, 区别在于数据变成了高质量 Instruction-Response Pair.
变量说明:
- $\mathcal L_{\text{SFT}}$: Supervised Fine-Tuning Loss.
- $\mathcal D_{\text{SFT}}$: 由 Prompt 与标准回答组成的监督数据集.
- $x$: Instruction 或 Prompt.
- $y^*$: 数据集中提供的 Target Response, 星号表示它被当作参考答案.
- $y_t^*$: Target Response 的第 $t$ 个 Token.
- $y_{<t}^*$: Target Response 在第 $t$ 步之前的真实前缀.
- $\pi_\theta(y_t^*\mid x,y_{<t}^*)$: 模型在 Teacher Forcing 条件下给正确 Token 的概率.
- $T$: Target Response 的 Token 长度.
在训练中的作用: 它把 Base Model 转换成能遵循指令的初始 Policy, 通常也是后续 RL 的起点和 Reference Model 来源.
SFT 的优点是信号密集且稳定. 标准答案中的每个 Token 都告诉模型应该怎样写. 但它只能模仿数据里已经出现的行为. 如果示范不够好, 模型也很难凭空超过示范.
4.3 Rejection Sampling 是最朴素的自我改进
一个自然想法是:
- 对同一个 Prompt 采样很多候选回答.
- 让人类或程序挑出好回答.
- 只把好回答放回 SFT 数据集.
这就是 Rejection Sampling Fine-Tuning, 也常简称 RFT. 它比只使用人工示范更灵活, 但大量低分回答都被丢弃了. 这些失败样本明明包含信息, 却没有参与学习.
要利用所有样本, 我们需要把 "挑选" 变成连续分数, 再让分数直接控制梯度. 这就引出了 Reward Model 和 Policy Gradient.
5. Reward Model: 先让完整回答得到可计算的分数
开放式对话通常没有唯一标准答案. "这段回答是否有帮助" 很难写成规则, 但人类通常比较容易判断两个回答中哪个更好.
于是可以收集偏好对:
公式含义: 一条 Preference Data 不是单个标准答案, 而是同一 Prompt 下的一对候选回答及其相对顺序. 标注只要求判断 "哪个更好", 不要求给出绝对分数.
变量说明:
- $x$: 两个回答共同对应的 Prompt.
- $y_w$: Winner 或 Chosen Response, 即偏好排序中更好的回答.
- $y_l$: Loser 或 Rejected Response, 即偏好排序中较差的回答.
- 下标 $w$ 和 $l$: 分别来自 winner 与 loser.
在训练中的作用: 这种三元组是 Pairwise Reward Model 和 DPO 一类偏好优化方法的基础数据单位. 它把主观质量判断转换成可学习的二分类关系.
其中 $y_w$ 是 chosen response, $y_l$ 是 rejected response. Reward Model $r_\phi(x,y)$ 为每个回答输出一个标量. 常见的 Bradley-Terry 偏好概率是:
公式含义: Reward Model 先分别给两个回答打分, 再把分数差通过 Sigmoid 转成 "人类更偏好 $y_w$" 的概率. 两个回答分差越大, 模型对排序越有信心.
变量说明:
- $P_\phi(y_w\succ y_l\mid x)$: Reward Model 预测 $y_w$ 优于 $y_l$ 的概率.
- $\phi$: Reward Model 的参数, 与 Policy 参数 $\theta$ 区分.
- $\succ$: Preference Relation, 表示左侧回答优于右侧回答.
- $r_\phi(x,y)$: Reward Model 对回答 $y$ 给出的原始标量分数.
- $r_\phi(x,y_w)-r_\phi(x,y_l)$: 两个回答的 Reward Margin.
- $\sigma(z)=1/(1+e^{-z})$: Sigmoid Function, 把任意实数映射到 $(0,1)$.
在训练中的作用: Bradley-Terry 模型只关心分数差, 不关心 Reward 的绝对零点. 因而 Reward 值本身不能直接解释为真实效用, 主要用于排序和构造 RL 信号.
对应的训练损失为:
公式含义: 当 Reward Model 正确地让 Chosen Response 得分更高时, Sigmoid 概率接近 $1$, Loss 接近 $0$. 如果排序错误, 概率接近 $0$, 负对数会产生很大惩罚.
变量说明:
- $\mathcal L_{\text{RM}}(\phi)$: Reward Model 的 Pairwise Ranking Loss, 训练时对它做最小化.
- $\mathbb E_{(x,y_w,y_l)}$: 对 Preference Dataset 中的所有三元组取平均.
- $\log\sigma(\cdot)$: 被正确排序样本的 Log Likelihood.
- 外层负号 $-$: 将最大化正确排序概率转成最小化 Loss.
- $r_\phi(x,y_w)$ 和 $r_\phi(x,y_l)$: Reward Model 对 Winner 与 Loser 的分数.
在训练中的作用: 梯度会同时抬高 $y_w$ 的相对分数并压低 $y_l$ 的相对分数. 训练完成后, $r_\phi(x,y)$ 可为新 Rollout 自动提供 Reward, 但其可靠范围仍受 Preference Data 分布限制.
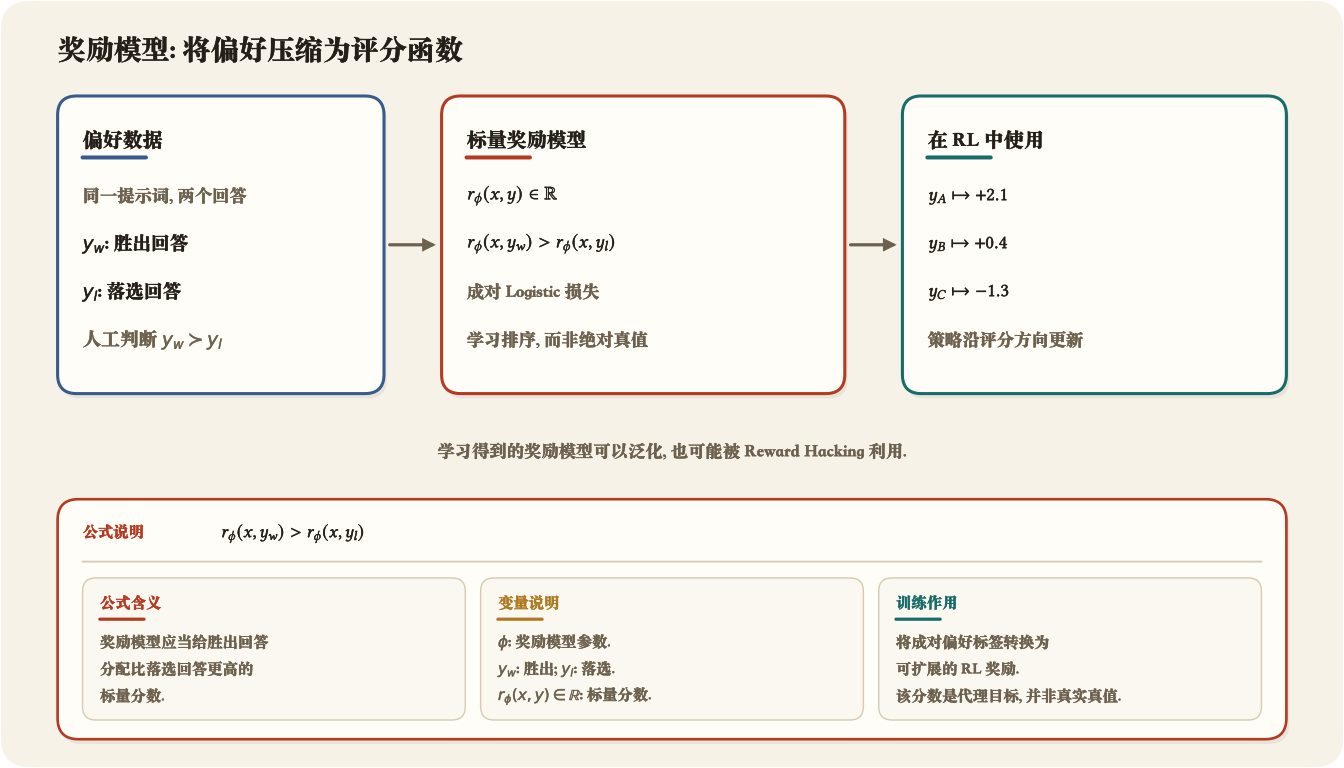
Reward Model 解决了人工逐条打分的吞吐问题, 但也制造了新的风险: Reward Hacking. Policy 可能找到一种回答, 它能骗过 Reward Model 得到高分, 却并不真正有用. 所以高 Reward 不能自动等价于高质量.
到这里, 我们只解决了 "完整回答实际得了多少分". Reward Model 像阅卷员, 在回答生成完毕后给出结果分数 $R(x,y)$. 它还没有回答另外两个问题:
- 对于这道 Prompt 和当前生成前缀, 这个分数相对模型的正常水平究竟算好还是差?
- 一条长回答得到终局分数后, 哪些 Token 应该被鼓励或抑制?
下一节先看最直接的做法: REINFORCE 把 Reward 原样乘到生成概率的梯度上. 正是观察这种做法为什么抖动很大, 我们才会自然地得到 Baseline, Critic 和 Advantage, 而不是凭空再添加一个模型.
6. REINFORCE: 用分数更新 Policy, 再看绝对 Reward 为什么不够
6.1 Reward 如何进入 LLM 的梯度
最基础的 Policy Gradient 方法是 REINFORCE. 目标仍然是:
公式含义: 对当前 Prompt $x$, Policy 会生成许多可能回答. $J(\theta)$ 是这些回答 Reward 的概率加权平均. 优化目标不是记住某个高分答案, 而是让高分回答在整个输出分布中更常出现.
变量说明:
- $J(\theta)$: Policy 的 Expected Return, 训练时希望最大化.
- $\theta$: 当前 LLM Policy 的参数.
- $x$: 当前固定的 Prompt. 完整训练中还会对 $x$ 的数据分布取期望.
- $y$: Policy 随机生成的完整回答.
- $y\sim\pi_\theta$: 回答由当前 Policy 采样, 而不是来自固定标签.
- $R(x,y)$: 该回答获得的 Sequence-level Reward.
- $\mathbb E$: 对所有可能回答及其采样概率求平均.
在训练中的作用: REINFORCE 要构造 $\nabla_\theta J(\theta)$ 的 Monte Carlo 估计, 从而只用采样到的回答和 Reward 就能更新模型.
利用 Log-Derivative Trick:
公式含义: 概率本身的梯度, 可以写成 "概率乘以 Log Probability 的梯度". 这是由 $\nabla\log p=(\nabla p)/p$ 直接变形得到的, 通常称为 Log-Derivative Trick 或 Score Function Identity.
变量说明:
- $\nabla_\theta$: 对参数 $\theta$ 求梯度, 表示参数微小变化会怎样改变目标.
- $\pi_\theta(y\mid x)$: 当前 Policy 生成回答 $y$ 的概率.
- $\log\pi_\theta(y\mid x)$: 回答的 Log Probability.
- $\nabla_\theta\log\pi_\theta(y\mid x)$: Score Function, 指向能提高回答 $y$ 概率的参数方向.
在训练中的作用: 这个恒等式把对一个巨大离散分布的求导, 转换成对已采样回答 Log Probability 的求导. 因此 Reward 不需要可微, 只要能够给样本打分即可.
可以得到:
公式含义: Policy Gradient 等于 Reward 加权后的 Score Function 期望. 高 Reward 回答的 Log Probability 梯度被正向放大, 低 Reward 或负 Reward 回答的梯度被减弱或反向推动.
变量说明:
- $\nabla_\theta J(\theta)$: 让期望 Reward 上升最快的参数方向.
- $y\sim\pi_\theta$: 用当前 Policy 进行 On-policy Sampling.
- $R(x,y)$: 回答的 Reward 权重.
- $\nabla_\theta\log\pi_\theta(y\mid x)$: 提高已采样回答概率的方向.
- $\mathbb E$: 理论上对全部回答取期望, 实际训练中用有限 Rollout 的 Batch Average 近似.
在训练中的作用: 它是 REINFORCE 的核心公式. Reward Model, Rule Verifier 或 Environment 只需提供标量 $R$, Autograd 就能通过 Log Probability 把信号传到 LLM 参数.
展开到 Token 级别:
公式含义: Sequence Log Probability 可以拆成 Token Log Probability 之和, 所以一个回答的 Reward 会乘到该回答所有 Token 的梯度上. 这使终局 Reward 能训练自回归模型, 也暴露了粗粒度 Credit Assignment 问题.
变量说明:
- $T$: 当前回答包含的 Token 数.
- $t$: Token 位置索引.
- $y_t$: 第 $t$ 个已采样 Token.
- $y_{<t}$: 生成 $y_t$ 时已经存在的回答前缀.
- $R(x,y)$: 整条回答共享的 Sequence Reward.
- $\sum_t\nabla_\theta\log\pi_\theta(y_t\mid x,y_{<t})$: 整段回答对参数的 Score Gradient.
在训练中的作用: 如果只使用一个终局 Reward, 正确和错误步骤会被同样鼓励或惩罚. Value Model, GAE 和 PRM 的价值, 正是在于为不同位置提供更细的 Credit Signal.
这个公式的直觉非常简单:
- $R>0$ 时, 梯度提高这条回答中已采样 Token 的概率.
- $R<0$ 时, 梯度降低这些 Token 的概率.
- $|R|$ 越大, 更新力度越大.
假设模型生成了两条答案:
- 回答 A 得分 $+2$. 训练后, A 中的 Token 组合更容易再次出现.
- 回答 B 得分 $-1$. 训练后, B 中的 Token 组合更不容易再次出现.
6.2 直接使用 Reward 的问题: 分数相同, 信息量却不同
这条规则虽然可行, 但 Reward 是绝对分数; 为了获得低方差且更有区分度的梯度估计, 训练更希望使用相对表现. 考虑两个答对并获得 $R=1$ 的数学 Rollout:
- 对容易题, 当前 Policy 原本就有约 $95\%$ 的概率答对. 这次成功并不意外.
- 对困难题, 当前 Policy 只有约 $20\%$ 的概率答对. 这次成功包含更有价值的新策略.
原始 REINFORCE 看到的都是 $R=1$, 会以相同权重强化两条回答. 在一个同时混合简单问答, 困难推理, 代码和 Agent 任务的 Batch 中, 这种绝对分数会带来两个问题:
- High Variance. Prompt 难度和采样随机性都会改变 Reward. 即使 Policy 只发生很小变化, Batch Gradient 也可能剧烈抖动.
- Coarse Credit Assignment. 一个终局 Reward 被广播到整条回答. 如果 4000 个 Token 的推理最后答错, 它没有直接指出错误从哪里开始.
6.3 从 Baseline 自然走向 Critic
先解决第一个问题. 我们希望先估计 "处在当前 State 时通常能得多少分", 再只学习实际结果与这个正常水平之间的差值. 为此, 可以从 Reward 中减去一个只依赖 State, 不依赖当前采样 Action 的 Baseline $b(s_t)$:
公式含义: Policy 不再根据绝对 Return 更新, 而是根据 "实际 Return 减去当前 State 的正常水平" 更新. 只要 $b(s_t)$ 在选择当前 Action 前已经确定, 减去它不会改变 Policy Gradient 的期望方向, 但能显著减小样本间波动.
变量说明:
- $G_t$: 当前 Rollout 从位置 $t$ 开始实际获得的累计 Return.
- $s_t$: 选择第 $t$ 个 Token 前的 State, 即 Prompt 与已生成前缀.
- $a_t$: 在 $s_t$ 下采样的 Token 或 Tool Call.
- $b(s_t)$: 只依赖 State 的 Baseline, 表示该位置的正常回报水平.
- $G_t-b(s_t)$: 当前 Rollout 相对于正常水平的超额表现.
在训练中的作用: Baseline 会把容易题答对产生的小惊喜与困难题答对产生的大惊喜区分开. 数学上, Baseline 项的期望梯度为 $b(s_t)\nabla_\theta\sum_a\pi_\theta(a\mid s_t)=0$, 所以它主要降低 Variance, 不改变理想情况下的优化目标.
那么 Baseline 应该取什么? 一个自然且常用的选择, 是当前 Policy 从 State $s_t$ 继续生成时的期望未来回报:
公式含义: 使用 State Value 近似 Baseline, 即估计在当前前缀下继续按 Policy 采样, 最终平均能获得的 Return. 它不是当前回答的实际得分, 而是回答生成之前的期望得分.
变量说明:
- $b(s_t)$: 实际训练中使用的 State-dependent Baseline.
- $V^\pi(s_t)$: Policy $\pi$ 在 State $s_t$ 下的真实 State Value.
- $G_t$: 从位置 $t$ 开始累计的实际 Return.
- $a_t,a_{t+1},\ldots\sim\pi$: 从当前前缀开始继续按 Policy 采样后续 Token.
在训练中的作用: 如果能够准确估计 $V^\pi(s_t)$, Reward 与它的差值就能衡量当前动作是否优于预期. 但 LLM 的 State 是任意 Prompt 加任意长度前缀, 数量近乎无限, 不可能靠查表保存每个 $V^\pi(s_t)$. 因此我们用一个神经网络 $V_\psi(s_t)$ 去逼近它. 这个学习 Baseline 的网络, 就是 Critic / Value Model.
因此 Critic 不是为了给回答再打一次分而额外添加的裁判. Reward Model 告诉我们 实际得分, Critic 预测 生成之前的预期得分. 二者相减得到相对表现, 也就是下一节的 Advantage. 对第二个问题, Critic 配合 TD 和 GAE 可以提供更细的 Token-level Credit Estimate; 如果需要直接判断某一步推理是否正确, 仍需 Process Reward 或更细粒度的环境反馈.
7. Critic 与 Advantage: 先预测正常水平, 再判断这次表现
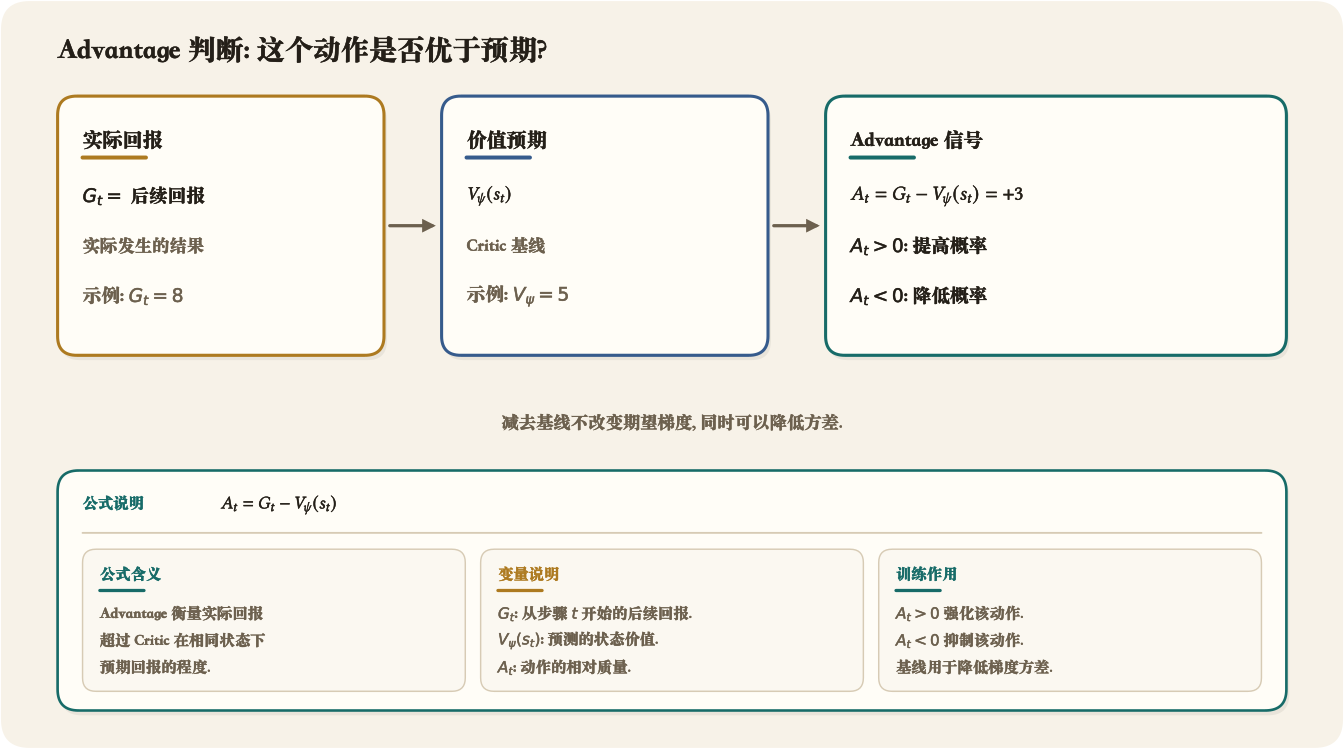
现在 Critic 的出现就顺理成章了. Section 5 的 Reward Model 给完整回答一个 实际分数, Section 6 说明直接用绝对分数做 REINFORCE 会产生很大方差, 因而需要一个随 State 变化的 预期分数. Critic 就负责预测这个预期分数, Advantage 则计算实际表现超出预期多少:
- Reward / Return: 这次 Rollout 实际发生了什么.
- Critic Value $V_\psi(s_t)$: 从这个前缀继续生成, 当前 Policy 通常会得到什么结果.
- Advantage: 实际结果减去预期结果, 决定这个 Action 应该被鼓励还是抑制.
如果一张试卷得了 80 分, 这个分数本身不能说明表现是否突出. 如果同类考生平均 50 分, 80 分是正向惊喜; 如果平均 95 分, 80 分反而低于预期. Critic 负责估计这里的 "平均分", Advantage 负责计算差值.
在理论定义中, Advantage 是 Action Value 与 State Value 的差:
公式含义: $Q(s_t,a_t)$ 表示选定 Action $a_t$ 后的预期回报, $V(s_t)$ 表示尚未选定当前 Action 时按 Policy 行动的平均预期回报. 二者之差就是该 Action 超过正常水平的程度. 实际 PPO 无法精确计算两个期望, 因而用 Rollout Return, Critic 预测和 GAE 构造 Sample Estimate $\hat A_t$.
变量说明:
- $s_t$: 第 $t$ 步 State, 在 LLM 中通常是 Prompt 加已生成前缀.
- $a_t$: 第 $t$ 步 Action, 即所选 Token 或 Tool Call.
- $Q(s_t,a_t)$: Action Value. 从 $s_t$ 执行 $a_t$ 后继续行动所能获得的期望累计回报.
- $V(s_t)$: State Value. 在 $s_t$ 按当前 Policy 行动时的平均期望累计回报.
- $A(s_t,a_t)$: Advantage Function, 表示动作相对于当前平均策略的额外价值.
如何解读符号: $A>0$ 时应提高 $a_t$ 的概率, $A<0$ 时应降低其概率, $A\approx0$ 时该动作与平均水平相近.
在训练中的作用: 使用 Advantage 替代原始 Reward 可消除不同 Prompt 难度造成的大幅度基线波动, 降低 Policy Gradient Variance.
7.1 Critic 如何从 Rollout 中学会预测正常水平
上一节说明了为什么需要 Critic, 这里再回答它如何得到. Critic 不是人工编写的评分规则, 也不是一个提前知道答案的 Oracle. 训练刚开始时并不存在准确的 Value 预测: 它通常先由已有模型初始化, 再依靠一批批真实 Rollout Return 逐渐学准.
Critic 通常是一个带 Value Head 的神经网络: 输入 LLM 当前看到的 State $s_t=(x,y_{<t})$, 输出一个标量 $V_\psi(s_t)$, 预测 "从这个前缀继续生成, 按当前 Policy 最终平均能获得多少 Reward".
在工程上, Critic 常按以下方式得到:
- 初始化 Backbone. 复制 SFT Model, Actor 或 Reward Model 的 Transformer Backbone, 再接一个随机初始化的 Scalar Value Head. 经典 PPO 往往让 Actor 与 Critic 使用两个独立模型, 避免两个目标相互干扰. 也有实现共享部分 Backbone 以节省显存.
- 让当前 Policy 生成 Rollout. 对每个 Prompt 采样完整回答, 同时保存每个 Token 位置的 State $s_t$.
- 获得真实训练目标. Reward Model, Rule Verifier 或 Environment 为 Rollout 提供 Reward. Trainer 从后向前计算每个位置实际得到的 Return.
- 训练 Critic 做回归. 让 $V_\psi(s_t)$ 逼近对应位置的 Return. 预测过高就下调, 预测过低就上调.
- 与 Actor 反复交替更新. Actor 改变后, Rollout 分布也会改变, 所以 Critic 必须持续用最新 Rollout 更新, 才能跟上当前 Policy.
这不存在 "必须先有准确 Critic 才能开始 RL" 的循环依赖. 第一批 Rollout 可以由尚未训练好的 Value Head 配合 Monte Carlo Return 启动, 也可以先用历史 Rollout 对 Critic 做 Warm-up. 随着 Actor 与 Critic 交替更新, Value 估计才逐步变得可靠.
最基础的 Return Target 和 Value Loss 可以写成:
公式含义: 先把从位置 $t$ 到序列结束的 Reward 累加成训练目标 $\hat G_t$, 再用 Mean Squared Error 训练 Critic, 使其预测值接近实际 Return. 在只有终局 Reward 的 LLM RL 中, 中间 $r_k$ 多数为 $0$, 最终验证结果会成为各前缀 Value 的主要监督信号.
变量说明:
- $\hat G_t$: 从 State $s_t$ 开始实际观察到的 Return Target.
- $r_k$: 第 $k$ 步的即时 Reward. 数学或代码 RLVR 常只在序列结束时出现非零值.
- $\gamma$: Discount Factor. LLM 生成中常取接近 $1$ 的值.
- $V_\psi(s_t)$: Critic 对当前前缀未来 Return 的预测.
- $\psi$: Critic 参数, 与 Actor 参数 $\theta$ 分开优化.
- $L_{\text{value}}$: Critic 的回归损失.
在训练中的作用: Reward 或 Verifier 负责产生监督目标, Value Loss 把这些 Rollout 结果蒸馏进 Critic. 训练好的 Critic 随后为每个 Token 前缀提供 Baseline, 用于计算 TD Residual 和 GAE. 实际 PPO 也常用 $\hat A_t+V_{\text{old}}(s_t)$ 作为 Value Target, 并对 Value 更新做 Clip, 但本质仍是用已发生的 Rollout 回报训练一个未来回报预测器.
Critic 与 Reward Model 容易混淆, 但二者职责不同:
| 模型 | 主要输入 | 预测什么 | 监督从哪里来 | RL 期间是否更新 |
|---|---|---|---|---|
| Reward Model / Verifier | Prompt + 完整回答 | 这个回答得多少分 | 人类偏好, 规则或环境结果 | 通常冻结 |
| Critic / Value Model | Prompt + 当前生成前缀 | 从这里继续生成的期望未来回报 | Policy Rollout 的实际 Return | 与 Actor 一起持续更新 |
例如, 当前 Policy 在一类容易题上采样 100 次并答对约 95 次, 在一类困难题上答对约 20 次. 经过大量类似 Rollout 的回归训练后, Critic 可能对两类题的初始 State 分别输出接近 $0.95$ 和 $0.20$. 这就是下一小节示例中 Value Baseline 的来源. 它们不是人工填写进模型的固定常数, 而是 Critic 从历史 Rollout 结果中学到的估计.
GRPO 的关键简化恰恰是取消这个 Learned Critic: 它用同一 Prompt 下多个回答的组内 Reward 均值代替 $V_\psi(s_t)$ 这类学习得到的 Baseline, 从而节省一套 Value Model 的训练与显存成本.
7.2 具体例子: 同样答对, Advantage 也可能完全不同
考虑一个使用规则验证器训练数学能力的 LLM. 验证器只检查最终答案, 答对给 Reward $R=1$, 答错给 $R=0$. 如果直接使用 Reward, 所有答对样本都会获得相同强度的正向更新. 但这忽略了 Prompt 难度: 模型答对一道本来就几乎必对的题, 与攻克一道通常会失败的题, 提供的信息量并不相同.
下面是假设性的 Critic 预测值, 用于展示 Advantage 的计算方式:
| LLM Rollout | 最终 Reward $R$ | Critic 预测 $V(s_0)$ | 近似 Advantage $R-V(s_0)$ | 对 Policy 的影响 |
|---|---|---|---|---|
| 容易题答对 | $1$ | $0.95$ | $+0.05$ | 轻微提高该回答的概率 |
| 困难题答对 | $1$ | $0.20$ | $+0.80$ | 明显提高该回答的概率 |
| 容易题答错 | $0$ | $0.95$ | $-0.95$ | 强烈抑制该回答 |
| 困难题答错 | $0$ | $0.20$ | $-0.20$ | 适度抑制该回答 |
这里的 $V(s_0)$ 正是上一小节中用历史 Rollout Return 训练得到的预测值, 不是题目的标准答案. 在 Reward 只有 $0/1$ 时, 它可以近似理解为 Critic 根据 Prompt 和当前 Policy 估计的平均成功概率. 因此, Advantage 实际回答的是: 这次 Rollout 相对于模型在这道题上的正常水平, 究竟是惊喜还是失误?
这个相对化非常适合 LLM RL. 一个 Batch 往往同时包含简单问答, 困难数学题, 长代码任务和 Tool Use 任务. 如果不扣除各自的 Baseline, 高 Reward 可能只是因为题目容易, 低 Reward 也可能只是因为题目本来就难. Advantage 让这些异质 Prompt 能够放在同一批次中更稳定地训练.
在 Actor-Critic 中:
- Actor 是需要训练的 LLM Policy $\pi_\theta$.
- Critic 是 Value Model $V_\psi(s_t)$.
常用的 Temporal Difference residual 是:
公式含义: TD Residual 比较 "实际的一步 Reward 加下一状态价值" 与 "Critic 原先对当前状态的预测". 它衡量这一步结果超出或低于预期多少.
变量说明:
- $\delta_t$: 第 $t$ 步 Temporal Difference Error, 也是一步 Advantage 的近似.
- $r_t$: 环境在第 $t$ 步给出的即时 Reward. 在只有终局奖励的 LLM 任务中, 大部分中间 $r_t$ 可能为 $0$.
- $\gamma\in[0,1]$: Discount Factor, 控制未来价值折算到当前时的重要程度.
- $V_\psi$: 参数为 $\psi$ 的 Critic / Value Model.
- $s_t$ 和 $s_{t+1}$: 当前 State 与执行动作后的下一 State.
- $V_\psi(s_{t+1})$: 从下一状态继续行动的预测价值.
在训练中的作用: $\delta_t>0$ 表示结果比 Critic 预期更好, $\delta_t<0$ 表示更差. GAE 会把多个未来 $\delta$ 汇总成更平滑的 Advantage.
Generalized Advantage Estimation, 即 GAE, 把未来多个 TD residual 按指数衰减相加:
公式含义: GAE 从当前时刻开始, 把后续 TD Residual 按 $(\gamma\lambda)^l$ 指数衰减后相加. 越远的反馈权重越小, 从而在短期 Critic 估计和完整 Episode 回报之间折中.
变量说明:
- $\hat A_t$: 对真实 Advantage 的 Sample Estimate, 帽子表示它是估计值而非精确期望.
- $\text{GAE}(\gamma,\lambda)$: Generalized Advantage Estimation 及其两个超参数.
- $l$: 从当前位置向未来看的偏移步数.
- $T-t-1$: 从当前 Token 到 Episode 结束可累加的最大偏移.
- $\delta_{t+l}$: 第 $t+l$ 步的 TD Residual.
- $\gamma$: Discount Factor, 决定未来 Reward 的时间折扣.
- $\lambda$: GAE Smoothing Parameter, 控制 Bias-Variance Trade-off.
- $(\gamma\lambda)^l$: 第 $l$ 个未来 TD Residual 的衰减权重.
如何选择: 较小 $\lambda$ 更依赖 Critic, 通常方差较低但 Bias 较大. 较大 $\lambda$ 更接近 Monte Carlo Return, 通常 Bias 较小但方差较高.
在训练中的作用: PPO 使用 $\hat A_t$ 决定每个 Token 的更新方向和强度, 同时避免把噪声很大的完整回报原样广播到所有位置.
7.3 把 GAE 落到一条 LLM 数学 Rollout
假设 Prompt 是: "一个袋中有 3 个红球和 2 个蓝球, 不放回抽 2 个球, 两球均为红色的概率是多少?" 模型生成正确推理: 先选择组合计数, 再写出 $\binom{3}{2}/\binom{5}{2}$, 最后得到 $3/10$.
真实模型可能生成几十个 Token. 为了便于计算, 下面把它聚合为 3 个关键决策位置. 假设只有最终答案通过验证器时获得 $r_3=1$, 中间即时 Reward 都是 $0$, 并取 $\gamma=1$, $\lambda=0.9$:
| 步骤 | 当前前缀后的 Action | $V_\psi(s_t)$ | $r_t$ | TD Residual $\delta_t$ | GAE $\hat A_t$ |
|---|---|---|---|---|---|
| $t=1$ | 选择组合计数思路 | $0.35$ | $0$ | $0.50-0.35=0.15$ | $0.15+0.9\times0.30+0.9^2\times0.20=0.582$ |
| $t=2$ | 写出 $\binom{3}{2}/\binom{5}{2}$ | $0.50$ | $0$ | $0.80-0.50=0.30$ | $0.30+0.9\times0.20=0.48$ |
| $t=3$ | 化简并输出 $3/10$ | $0.80$ | $1$ | $1-0.80=0.20$ | $0.20$ |
这些数值表达了一个重要现象: 中间步骤虽然没有直接 Reward, 最终成功仍会通过 GAE 向前传播. 因此, "选择组合计数" 和 "写出正确组合式" 对应的 Token 也能获得正向更新, 而不是只有最后的 3/10 被奖励.
如果最后答案错误, 终局 Reward 变成 $0$. 在其他 Value 预测不变的简化条件下, 最后一步会得到 $\delta_3=-0.80$, 并向前传播. 此时 $\hat A_2=0.30+0.9\times(-0.80)=-0.42$, $\hat A_1=0.15+0.9\times0.30+0.9^2\times(-0.80)=-0.228$. 这会抑制通向错误答案的前序决策.
表中的 $V_\psi(s_t)$ 就是 Critic 对三个前缀分别进行推理得到的输出. Value Model 读取 "Prompt + 当前生成前缀", 预测从该位置继续生成最终能获得多少回报; Rollout 结束后, Trainer 再用实际 Return 计算 Value Loss 并更新 Critic. 因此同一条回答既为 Actor 提供 Advantage, 也为 Critic 提供回归标签.
7.4 Advantage 最终如何改变 LLM 的 Token 概率
在一次 PPO 训练中, 上面的过程会落实为以下数据流:
- Rollout Engine 保存每个已采样 Token $y_t$, 对应前缀 $s_t$, 以及 Old Policy 的 $\log\pi_{\theta_{old}}(y_t\mid s_t)$.
- Reward Model 或规则验证器给完整回答打分. 对数学和代码 RLVR, 这个分数常常只在序列结束时出现.
- Critic 为每个 Token 前缀预测 $V_\psi(s_t)$, Trainer 从后向前计算 TD Residual 和 GAE.
- PPO 将每个 Token 的 Log Probability Gradient 乘以对应的 $\hat A_t$. 正 Advantage 提高该 Token 在相同前缀下再次出现的概率, 负 Advantage 则降低它.
- PPO Clip 和 KL Penalty 再限制更新幅度, 防止一次高 Advantage 样本把 Policy 拉得过远.
回到刚才的数学题, 如果 "选择组合计数" 附近的 Token 获得较大的正 Advantage, Policy 会更倾向于在相似状态下复用这种推理策略. 如果某个错误分支反复获得负 Advantage, 该分支中的 Token 概率会逐渐下降. 训练改变的不是一条可人工读取的规则, 而是这些 Token 在各自上下文中的条件概率.
但 Advantage 仍然只是 Credit Estimate, 不是严格的因果解释. 终局 Reward 稀疏, Critic 预测不准, 或一段推理中正确与错误步骤交错时, Credit 仍可能分配错误. 这也是 Process Reward Model, Step-level Verifier 和更细环境反馈仍然重要的原因.
减去一个与动作无关的 Baseline 不会改变期望梯度, 却能显著降低方差. 这就是 Actor-Critic 比原始 REINFORCE 更稳定的核心原因.
8. PPO: 为什么要给 Policy 更新装上限速器
8.1 旧样本与 Importance Sampling
生成 LLM Rollout 很昂贵. 如果每更新一次参数就丢弃所有样本并重新生成, 样本效率会很低. PPO 希望重复使用由旧策略 $\pi_{\theta_{\text{old}}}$ 生成的数据.
但数据来自旧策略, 优化的却是新策略. 因此定义 Probability Ratio:
公式含义: Importance Ratio 比较同一个已采样 Token 在 New Policy 与 Behavior / Old Policy 下的概率. 它修正 "数据由旧 Policy 产生, 梯度却用于新 Policy" 的分布差异.
变量说明:
- $r_t(\theta)$: 第 $t$ 个 Token 的 Importance Sampling Ratio. 注意这里的 $r_t$ 是 Ratio, 不是上一节 TD 公式里的即时 Reward.
- $\pi_\theta$: 当前正在更新的 New Policy.
- $\pi_{\theta_{\text{old}}}$: 生成这批 Rollout 时冻结的 Old Policy.
- $y_t$: Rollout 中实际采样到的 Token.
- $s_t$: 采样该 Token 时的 State.
- $\theta_{\text{old}}$: Rollout 时 Policy 参数的快照.
- $\exp(\cdot)$: 把 Log Probability Difference 还原为 Probability Ratio.
如何解读数值: $r_t=1$ 表示概率未变, $r_t>1$ 表示 New Policy 更偏爱该 Token, $r_t<1$ 表示 New Policy 降低了它的概率.
在训练中的作用: 只要新旧 Policy 没有相差太远, Ratio 就能让旧样本近似服务于当前 Policy. Ratio 过大或过小时估计会不稳定, 因而 PPO 还需要 Clip.
未经限制的 Surrogate Objective 是:
公式含义: 这是使用 Old Policy 数据构造的 Surrogate Policy Objective. Advantage 告诉模型方向, Importance Ratio 则把旧数据的贡献换算到 New Policy 下.
变量说明:
- $\mathcal L^{\text{PG}}(\theta)$: 未裁剪的 Policy Gradient Surrogate Objective, 通常被最大化.
- $\mathbb E_t$: 对 Batch 中所有有效 Token 位置取平均.
- $r_t(\theta)$: New Policy 与 Old Policy 对已采样 Token 的概率比.
- $\hat A_t$: 第 $t$ 个 Token 的 Advantage Estimate, 通常在求梯度时视为常数.
如何决定更新: 当 $\hat A_t>0$ 时, 增大 $r_t$ 会提高目标. 当 $\hat A_t<0$ 时, 减小 $r_t$ 会提高目标. 因此好动作概率上升, 坏动作概率下降.
在训练中的作用: 该目标允许一批 Rollout 被重复训练多个 Mini-batch Epoch. 但它本身没有限制 $r_t$ 的变化幅度, 所以还不是完整 PPO.
问题是, 同一批数据训练多轮后, $r_t$ 可能远离 1. 此时旧数据已经不能可靠代表新策略.
8.2 Clip 的作用
PPO 的 Clipped Objective 是:
公式含义: PPO 同时计算未裁剪收益和裁剪后的保守收益, 再取两者较小值. 一旦 New Policy 朝有利方向变化得过多, 目标就不再因继续远离 Old Policy 而增加.
变量说明:
- $\mathcal L^{\text{CLIP}}$: PPO Clipped Surrogate Objective, 通常被最大化.
- $r_t(\theta)$: New / Old Token Probability Ratio.
- $\hat A_t$: 当前 Token 的 Advantage Estimate.
- $\epsilon$: Clip Range 超参数, 常见含义是允许 Ratio 在 $1$ 附近小范围变化.
- $\operatorname{clip}(r_t,1-\epsilon,1+\epsilon)$: 把 Ratio 限制在区间 $[1-\epsilon,1+\epsilon]$.
- $\min$: 选择更保守的目标值, 构造 Pessimistic Bound.
- $\mathbb E_t$: 对有效 Token 和 Batch 样本求平均.
正负 Advantage 的区别: $\hat A_t>0$ 时主要限制概率上涨过多. $\hat A_t<0$ 时主要限制概率下降过多. Clip 不是直接截断参数或梯度, 而是截断继续扩大策略变化所带来的优化收益.
在训练中的作用: 它允许重用同一批 Rollout, 又降低一次更新把 Policy 推得过远的风险, 是 PPO 稳定性的核心机制.
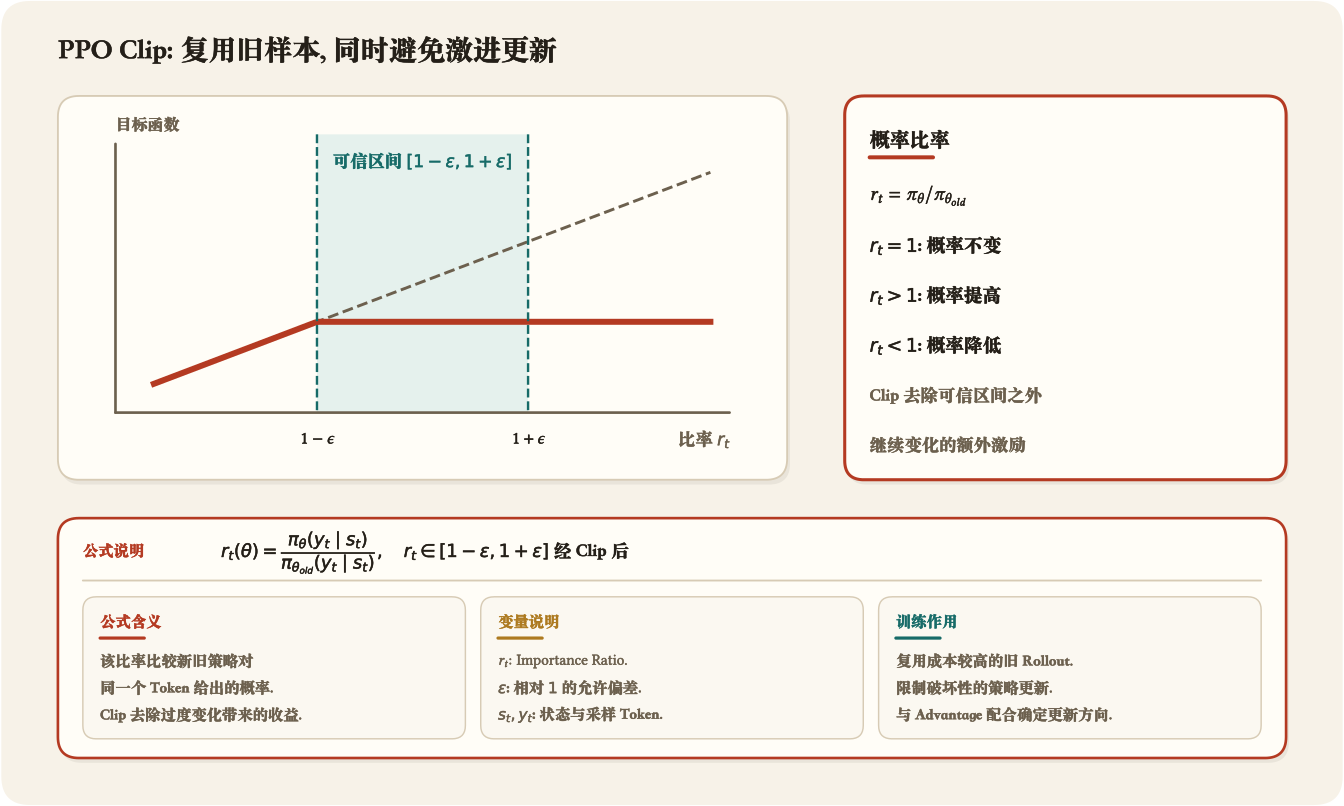
要特别注意正负 Advantage:
- 当 $\hat A_t>0$ 时, PPO 希望提高这个 Token 的概率, 但最多鼓励到 $1+\epsilon$ 附近.
- 当 $\hat A_t<0$ 时, PPO 希望降低这个 Token 的概率, 但最多惩罚到 $1-\epsilon$ 附近.
Clip 不是把参数变化硬截断. 它是在目标函数中移除 "继续走远还能获得更多收益" 的激励.
8.3 KL penalty 的作用
Clip 约束新旧 Policy 的单次变化. 另一个常用护栏是 Reference Model $\pi_{\text{ref}}$, 通常由初始 SFT 模型冻结得到.
Reverse KL 常写成:
公式含义: Reverse KL 衡量 Current Policy 生成的回答, 在 Reference Policy 看来有多不寻常. 两个分布完全相同时 KL 为 $0$, 差异越大时 KL 通常越大.
变量说明:
- $D_{\mathrm{KL}}(P\|Q)$: Kullback-Leibler Divergence, 是分布差异度量, 不是对称距离.
- $\pi_\theta$: 正在训练的 Current Policy.
- $\pi_{\text{ref}}$: 冻结的 Reference Policy, 通常来自 RL 开始前的 SFT Checkpoint.
- $y\sim\pi_\theta$: 期望在 Current Policy 生成的回答上计算, 因而这里是 Reverse KL 方向.
- $x$: 当前 Prompt.
- $\log[\pi_\theta(y\mid x)/\pi_{\text{ref}}(y\mid x)]$: 回答 $y$ 在两个 Policy 下的 Sequence Log Probability Difference.
- 符号 $\|$: 表示 KL 的方向. 一般 $D_{\mathrm{KL}}(P\|Q)\ne D_{\mathrm{KL}}(Q\|P)$.
在训练中的作用: KL 像连接 Current Policy 与 Reference Policy 的弹簧. 它抑制过快漂移, 但不会告诉模型应该朝哪个任务方向进步, 任务方向仍由 Reward 决定.
对自回归序列, Log Ratio 可按 Token 累加:
公式含义: 一个回答的 Sequence Log Ratio 可以拆成每个 Token 的 Log Ratio 之和. 因而不需要枚举全部回答, 只需让 Current 与 Reference Model 对已生成 Token 分别计算 Log Probability.
变量说明:
- $T$: 回答的 Token 总数.
- $s_t=(x,y_{<t})$: 第 $t$ 步的上下文状态.
- $\log\pi_\theta(y_t\mid s_t)$: Current Policy 对实际 Token 的 Log Probability.
- $\log\pi_{\text{ref}}(y_t\mid s_t)$: Reference Policy 对同一 Token 的 Log Probability.
- 方括号中的差值: 第 $t$ 个 Token 对总 Log Ratio 的贡献.
- $\sum_{t=1}^{T}$: 沿回答长度累加, 得到 Sequence-level Log Ratio.
在训练中的作用: 该分解让 KL Control 可以细化到 Token Level. 它也解释了为什么必须保证两个模型使用完全相同的 Token, Prefix 和 Mask 进行前向计算.
一种做法是把 KL 放进 Reward:
公式含义: Shaped Reward 等于任务 Reward 减去 Policy 偏离 Reference 的代价. 回答完成任务会加分, 但如果它只在 Current Policy 下很常见, 在 Reference 下极不常见, 就会被扣分.
变量说明:
- $R_{\text{shaped}}$: 最终送入 Return / Advantage 估计的 Shaped Reward.
- $R_{\text{task}}$: 由 Reward Model, Verifier 或 Environment 给出的原始任务 Reward.
- $\beta\ge0$: KL Coefficient, 控制 "追求任务分数" 与 "保持原有行为" 的权衡.
- $\pi_\theta$: Current Policy.
- $\pi_{\text{ref}}$: Frozen Reference Policy.
- Log Ratio: 当前回答相对 Reference 的偏移量 Sample Estimate.
如何调节: $\beta$ 太小可能导致 Policy Drift 或 Reward Hacking, 太大则会让模型几乎不敢离开 SFT Policy, 学不到新策略.
在训练中的作用: KL-in-Reward 会先改变 Reward, 再间接改变 Return 和 Advantage. 这与把 KL 直接放入 Loss 的 Gradient Path 不完全相同.
另一种做法是把 KL 直接作为 Loss regularization. 两者会以不同方式进入梯度和 Advantage 计算, 工程上不能视为完全相同.
直觉上, Reward 在拉模型向目标方向走, KL 则像一根弹簧, 防止模型忘记原有语言能力, 安全边界和回答习惯.
8.4 PPO 为什么需要 4 个模型
经典 RLHF PPO 通常同时涉及:
- Actor / Policy Model. 生成答案并被更新.
- Reward Model. 给完整答案打分.
- Critic / Value Model. 预测每个 State 的 Value.
- Reference Model. 提供 KL 约束基准.
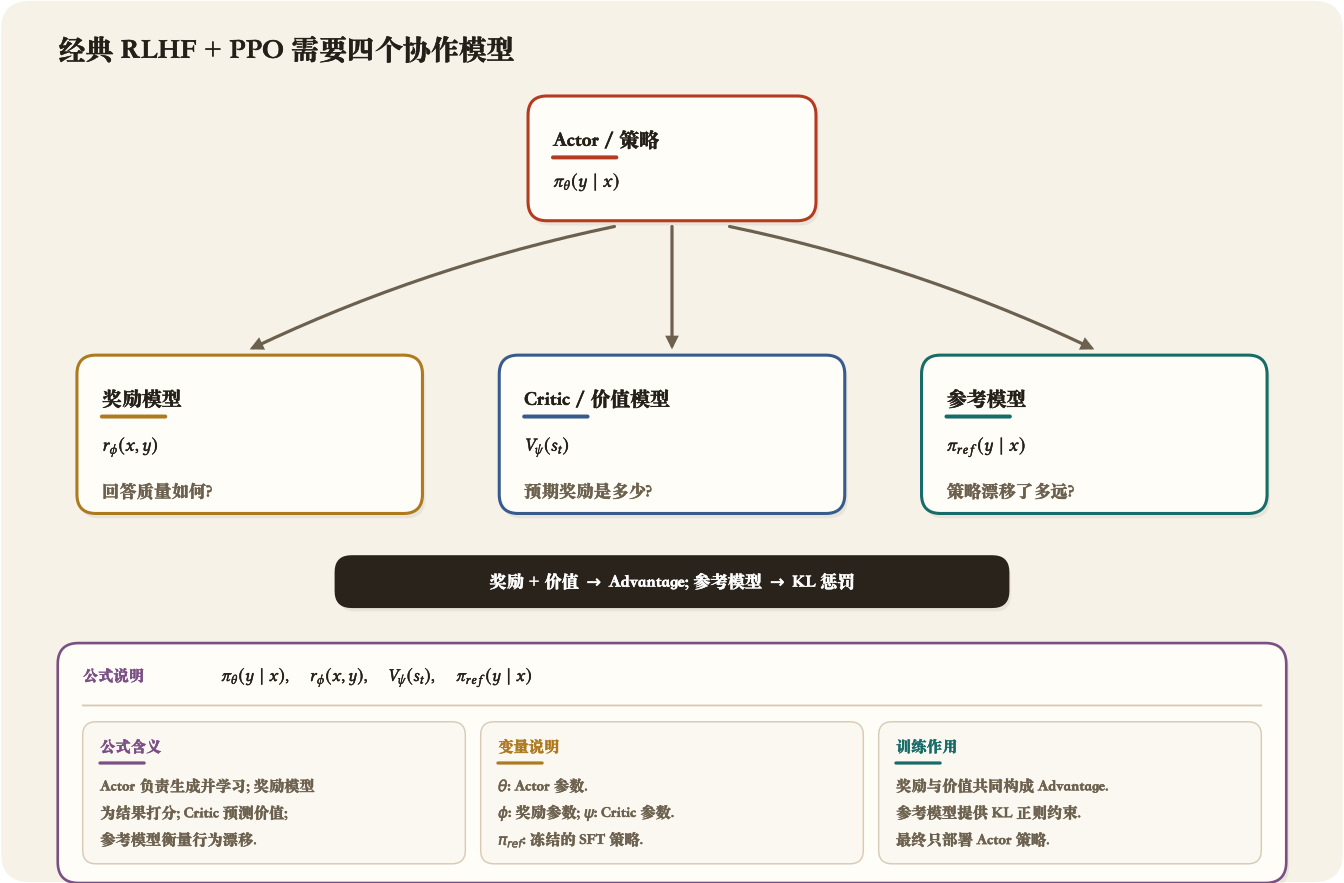
一个常见总损失可以抽象为:
公式含义: 这是一个按 Gradient Descent 最小化的 PPO 总损失. Policy Objective 本来要最大化, 所以前面加负号. Value Error 和 KL 要最小化, 因而为正号. Entropy 希望增大, 因而也以负号进入 Loss.
变量说明:
- $\mathcal L_{\text{total}}$: 一次 Backpropagation 使用的总 Loss.
- $\mathcal L^{\text{CLIP}}$: PPO Clipped Policy Objective.
- $\mathcal L_{\text{value}}$: Critic 的 Value Regression Loss, 常见形式是预测 Value 与 Target Return 的平方误差.
- $\mathcal H(\pi_\theta)$: Policy Entropy, 衡量输出分布的随机性和探索程度.
- $D_{\mathrm{KL}}(\pi_\theta\|\pi_{\text{ref}})$: Current Policy 对 Reference Policy 的偏离.
- $c_v$: Value Loss Coefficient.
- $c_e$: Entropy Bonus Coefficient.
- $\beta$: KL Penalty Coefficient.
在训练中的作用: 这个式子同时处理 Performance, Critic Accuracy, Exploration 和 Policy Drift. 不同框架会改变各项放置方式或省略某些项, 因而它是常见抽象而非唯一实现.
其中 $\mathcal{H}$ 是 Entropy bonus. 它鼓励 Policy 保留一定随机性, 避免过早塌缩到少数固定表达.
9. GRPO: 不训练 Critic, 让同组答案互相比较
PPO 的 Value Model 几乎和 Actor 一样大, 会增加显存, 计算和系统复杂度. GRPO, 即 Group Relative Policy Optimization, 用同一 Prompt 下的一组回答构造相对基线, 从而省去独立 Critic.
对问题 $q$ 采样 $G$ 个回答:
公式含义: 对同一个问题 $q$, Old Policy 独立采样 $G$ 个候选回答. GRPO 不把不同问题的原始 Reward 直接比较, 而是先在同题候选组内判断相对好坏.
变量说明:
- $q$: 当前 Question / Prompt.
- $G$: Group Size, 即同一 Prompt 的 Rollout 数量.
- $o_i$: 第 $i$ 个 Output / Response.
- $\{o_1,\ldots,o_G\}$: 同一 Prompt 对应的候选回答集合.
- $\pi_{\theta_{\text{old}}}$: 生成该组数据时冻结的 Old Policy.
- $\cdot\mid q$: 表示在给定 $q$ 后对完整回答分布进行采样.
在训练中的作用: 同题采样提供了天然 Baseline. 组内回答越多样, Relative Advantage 越有信息. 如果所有回答都对或都错, 该组能提供的区分信号会很弱.
得到 Reward $r_1,\ldots,r_G$ 后, 计算组内标准化 Advantage:
公式含义: 先减去同题回答的平均 Reward, 再除以组内标准差. 结果表示第 $i$ 个回答比同组平均水平高或低多少个 Standard Deviation.
变量说明:
- $\hat A_i$: 第 $i$ 个回答的 Group-relative Advantage Estimate.
- $r_i$: 第 $i$ 个回答获得的标量 Reward.
- $\mu_r$: 当前组 Reward Mean.
- $\sigma_r$: 当前组 Reward Standard Deviation. 公式中虽未展开, 它衡量组内分数分散程度.
- $G$: Group Size.
- $j$: 计算组均值时遍历回答的索引.
- $\varepsilon$: 很小的数值稳定项, 防止 $\sigma_r=0$ 时除零.
- $\qquad$: 仅用于公式排版留白, 没有数学含义.
如何解读: $\hat A_i>0$ 表示回答优于组均值, $\hat A_i<0$ 表示劣于组均值. 标准化后, 不同难度问题的 Reward Scale 更容易对齐.
在训练中的作用: 它以 Group Statistics 替代 Learned Critic. 代价是同一个回答的所有 Token 往往共享同一个 $\hat A_i$, Token-level Credit 仍较粗.
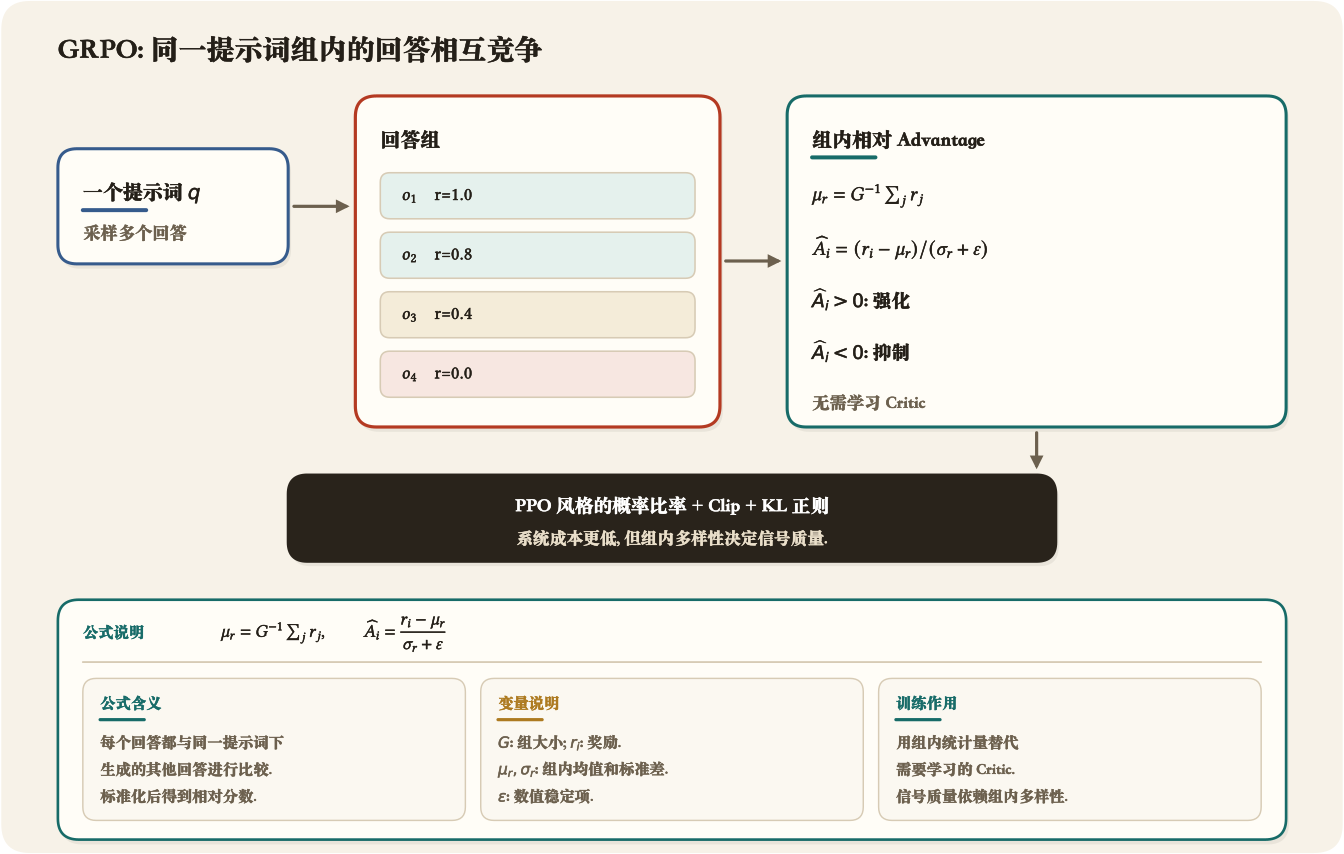
一个简化的 GRPO Objective 可以写成:
公式含义: GRPO 对每个 Prompt 的多个回答, 再对每个回答中的多个 Token 求平均. 每个 Token 使用 PPO-style Clipped Ratio, 但 Advantage 来自组内 Reward 标准化, 最后再减去 KL Penalty.
变量说明:
- $\mathcal J_{\text{GRPO}}(\theta)$: 要最大化的 GRPO Objective.
- $\mathbb E$: 对 Prompt Batch 和 Sampling Randomness 取期望.
- $G$: 每个 Prompt 的回答数量.
- $i$: 回答索引, $i=1,\ldots,G$.
- $o_i$: 第 $i$ 个完整回答.
- $|o_i|$: 第 $i$ 个回答的有效 Token 数.
- $t$: 回答内部的 Token 位置.
- $1/G$: 对组内回答求平均.
- $1/|o_i|$: 对每个回答的 Token 求平均, 避免长回答仅因 Token 多而占据更大权重.
- $r_{i,t}(\theta)$: 第 $i$ 个回答第 $t$ 个 Token 的 New / Old Probability Ratio.
- $\hat A_i$: 第 $i$ 个回答的 Group-relative Advantage, 在此简化式中广播到该回答全部 Token.
- $\epsilon$: PPO Clip Range.
- $\beta D_{\mathrm{KL}}$: 对 Reference Policy 偏移的惩罚.
在训练中的作用: 它保留 PPO 的样本重用和更新约束, 同时删除 Critic. 实际实现可能采用不同 KL Estimator, Token Mask, Length Normalization 或 Advantage 方案, 所以该式是便于理解的统一抽象.
这里:
公式含义: 这是 GRPO 在回答 $i$ 的 Token $t$ 上使用的 Importance Ratio. 分子和分母必须对同一 Prompt, 同一 Prefix 和同一已采样 Token 计算, 才能只反映 Policy 参数变化.
变量说明:
- $r_{i,t}(\theta)$: 回答 $i$ 的第 $t$ 个 Token 的 Probability Ratio.
- $o_{i,t}$: 第 $i$ 个回答中的第 $t$ 个 Token.
- $o_{i,<t}$: 该回答在 $t$ 之前的 Prefix.
- $q$: 生成这一组回答的 Prompt.
- $\pi_\theta$: 当前 Train Policy.
- $\pi_{\theta_{\text{old}}}$: 产生 Rollout 的 Behavior Policy.
在训练中的作用: Ratio 把固定 Rollout 上计算出的 Advantage 转换为对 Current Policy 的更新权重. 若 Rollout 与 Training 的 Token Mask, Precision 或 MoE Route 不一致, Ratio 还会混入系统误差.
GRPO 的优点:
- 不需要训练大规模 Critic, 系统更简单.
- 同题比较与很多 Reward Model 的偏好数据形式一致.
- 特别适合一个 Prompt 能采样多个答案的场景.
GRPO 的局限:
- 如果一组答案 Reward 全都相同, 组内标准差很小, 学习信号会消失或变得敏感.
- 组内 Advantage 只表达相对好坏, 不代表绝对质量.
- 若整段回答共享一个 Outcome Reward, Token-level Credit Assignment 仍然粗糙.
- Clip, KL 和 Sampling Policy 的不一致问题依然存在.
所以 GRPO 不是 "更正确的 PPO", 而是用组内统计替代 Critic 的一种工程权衡.
10. Reward 从哪里来: RLHF, ORM, PRM, RLAIF 和 RLVR
RL 算法只负责追逐 Reward. 真正定义模型会学成什么样的, 是 Reward 本身.
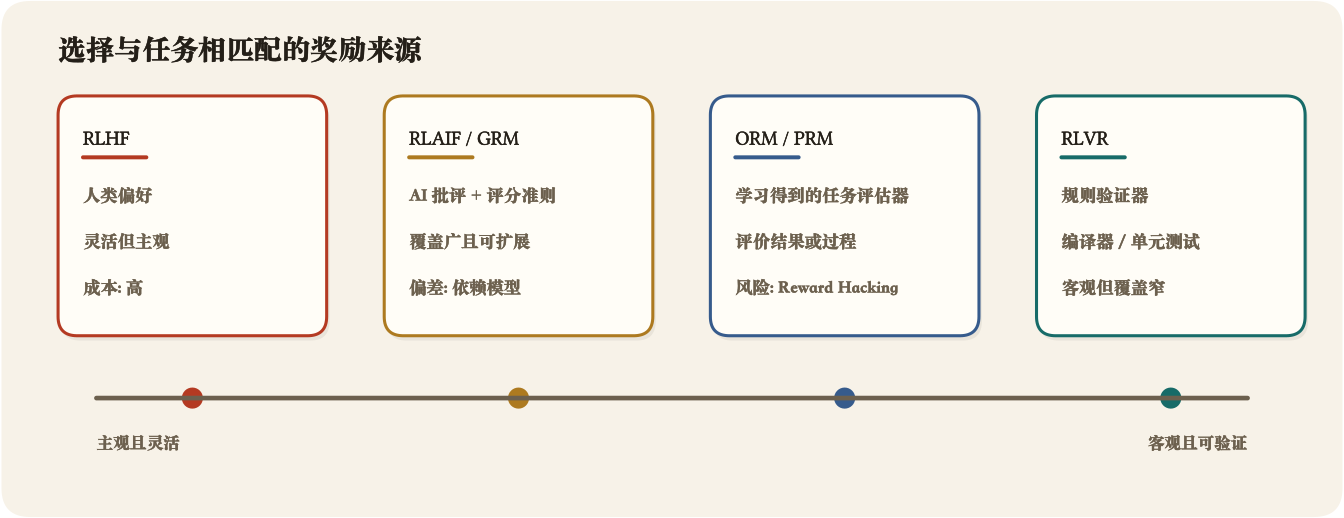
10.1 RLHF: Human Feedback
RLHF 使用人类偏好训练 Reward Model. 它适合评价 Helpful, Honest, Harmless, 语气, 风格等难以形式化的目标.
优点是贴近真实用户. 缺点是成本高, 标注者之间存在差异, Reward Model 也可能学到人类偏见或表面模式.
10.2 ORM: 只看最终结果
Outcome Reward Model, 即 ORM, 只对完整答案打分:
公式含义: ORM 读入 Prompt 和完整回答, 最终只输出一个 Sequence-level Score. 它不显式说明中间哪一步正确或错误.
变量说明:
- $R_{\text{ORM}}$: Outcome Reward Model 给整条回答的最终 Reward.
- $r(\cdot)$: 已训练好的 Outcome Scoring Function.
- $x$: Prompt.
- $y_{1:T}$: 从第 $1$ 个到第 $T$ 个 Token 的完整回答.
- $T$: 回答结束位置.
在训练中的作用: 这个标量通常被广播给整条回答或用于计算 Sequence Advantage. 它实现简单, 但会产生 Sparse Reward 和 Credit Assignment 困难.
它简单, 但 Reward 非常稀疏. 一道 20 步数学题如果第 2 步已经错了, 模型直到结尾才收到 0 分. 它不知道究竟错在哪里.
10.3 PRM: 给推理过程逐步打分
Process Reward Model, 即 PRM, 对中间推理状态给分:
公式含义: PRM 在推理进行到第 $t$ 步时, 根据 Prompt 和当前完整前缀评估这一步是否正确, 或从这里继续最终成功的可能性.
变量说明:
- $r_t$: 第 $t$ 个推理步骤的 Process Reward. 注意这里的 $r_t$ 表示 Reward, 不是 PPO 章节中的 Importance Ratio.
- $r_{\text{PRM}}$: Process Reward Model 的 Scoring Function.
- $x$: 原始问题.
- $y_{\le t}$: 从回答开始到第 $t$ 步为止的全部推理内容.
- $\le t$: 表示包含当前位置 $t$, 与只含历史的 $<t$ 不同.
在训练中的作用: Step-level Score 可以更早定位错误, 构造细粒度 Advantage, 也可以在 Test-Time Search 中充当 Heuristic, 及时剪掉低质量分支.
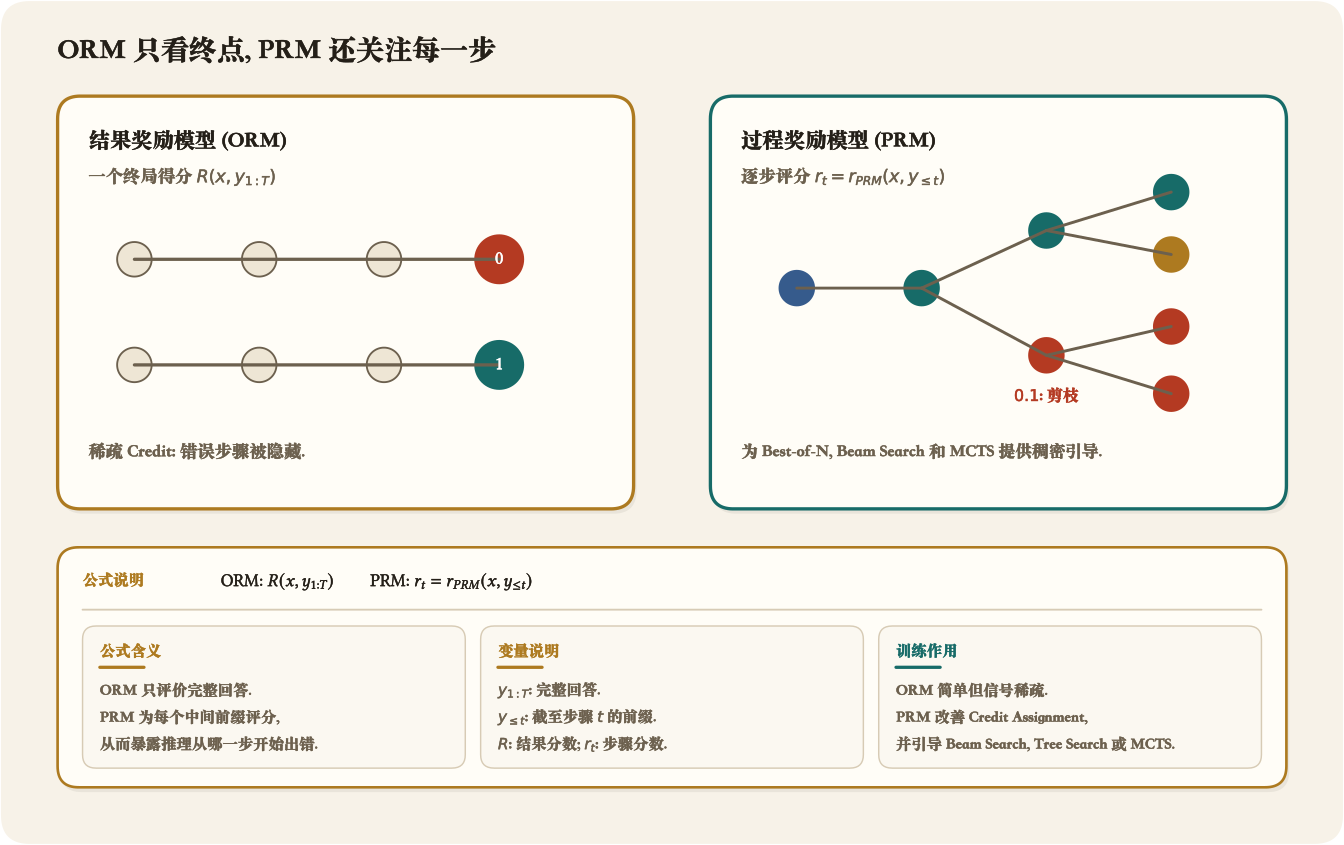
PRM 不仅能用于训练, 也能用于 Test-Time Compute. 可以把推理系统统一看成:
- Proposer. 负责产生候选步骤或完整答案.
- Verifier. 负责评价候选是否值得继续.
- Search. 决定广泛采样, 深度修正, 剪枝或回溯.
简单题可能只需 Self-Refine. 中等题可以使用 Beam Search. 难题可能需要 Best-of-N, Tree Search 或 MCTS. 因此推理算力的分配本质上仍然是 Exploration 与 Exploitation 的平衡.
PRM 的弱点是它仍然是一个 Learned Proxy. 过程写得像正确答案, 不代表逻辑一定正确. 一旦 Policy 学会迎合 PRM 的偏好, 仍然可能发生 Reward Hacking.
10.4 RLAIF: 用 AI Feedback 扩展主观评价
Reinforcement Learning from AI Feedback, 即 RLAIF, 用强模型按照 Rubric 或原则评价回答. Generative Reward Model, 即 GRM, 还可以先生成 Critique 和评分理由, 再输出结论.
RLAIF 降低了人类标注成本, 适合扩展到开放任务. 但 AI Judge 可能继承基础模型的偏差, 也可能在陌生领域自信地给出错误评价. Meta-verification 和多 Judge 集成可以降低风险, 但无法保证绝对正确.
10.5 RLVR: 用可验证结果提供客观 Reward
Reinforcement Learning from Verifiable Rewards, 即 RLVR, 使用确定性或近似确定性的 Verifier:
- 数学题: 检查最终数值或符号答案.
- 代码题: 编译, 运行 Unit Tests, 检查时间和内存.
- 形式化证明: 使用 Proof Checker 验证.
- Agent 任务: 检查 Environment State 是否达到目标.
最简单的二元 Reward 是:
公式含义: Verifier 通过时 Reward 为 $1$, 不通过时 Reward 为 $0$. 这是最简单的 Binary Verifiable Reward.
变量说明:
- $R_{\text{RLVR}}(x,y)$: RLVR 为回答给出的 Reward.
- $x$: 待解决的问题或任务描述.
- $y$: 模型生成的答案, 代码或证明.
- $V(x,y)$: Deterministic Verifier, 例如答案检查器, Compiler, Unit Test 或 Proof Checker.
- $\text{pass}$: Verifier 接受该输出.
- $\mathbf 1\{\cdot\}$: Indicator Function. 条件为真时等于 $1$, 否则等于 $0$.
在训练中的作用: 它提供客观且可大规模生成的信号, 但只有 Pass / Fail 时仍然很稀疏. 更复杂系统会加入 Partial Credit, Format Check 或 Test Coverage.
RLVR 的信号客观, 可扩展, 不容易被语言表面形式欺骗. 但它只适用于能可靠验证的任务. 写作是否优美, 建议是否贴心, 不能靠编译器判断.
现实系统通常采用 Mixed Reward:
公式含义: Mixed Reward 把多个训练目标线性组合成一个标量. 正向 Reward 鼓励正确, 合规和有帮助的输出, Penalty 则抑制无效超长或不安全行为.
变量说明:
- $R$: 最终用于 Policy Optimization 的总 Reward.
- $R_{\text{accuracy}}$: Accuracy Reward, 衡量答案或任务结果是否正确.
- $R_{\text{format}}$: Format Reward, 衡量输出是否满足指定结构.
- $R_{\text{helpfulness}}$: Helpfulness Reward, 常来自 Human 或 AI Judge.
- $P_{\text{length}}$: Length Penalty, 防止无意义地拉长回答.
- $P_{\text{safety}}$: Safety Penalty, 惩罚违反安全要求的行为.
- $w_{\text{acc}},w_{\text{fmt}},w_{\text{help}},w_{\text{len}},w_{\text{safe}}$: 各 Reward / Penalty 的非负权重.
在训练中的作用: 权重决定优化优先级和 Pareto Trade-off. 各分量量纲和取值范围若不匹配, 数值较大的分量会支配训练, 所以通常需要 Normalization, Clipping 和独立监控.
每多一个 Reward 分量, 就多一个模型可能钻空子的方向. 因此 Reward Design 本身就是最重要的系统设计工作之一.
11. DeepSeek-R1: 为什么只奖励答案也能长出推理
DeepSeek-R1-Zero 展示了一个非常直接的实验:
- 从 Base Model 开始, 跳过传统 Reasoning SFT.
- 使用 GRPO 进行大规模 RL.
- 主要使用 Accuracy Reward 和 Format Reward.
- 不强制模型模仿某条人类 Chain-of-Thought.
Reward 可以抽象为:
公式含义: 这个抽象式把 R1-Zero 的主要激励概括为 "答案必须正确" 和 "输出必须遵循规定格式". 它尽量少规定推理内容, 给 Policy 留出探索策略的空间.
变量说明:
- $R(x,y)$: 当前 Prompt 与回答的总 Reward.
- $x$: 数学, Coding 或逻辑推理问题.
- $y$: 模型生成的推理过程和最终答案.
- $R_{\text{accuracy}}(x,y)$: 使用规则, 标准答案或测试用例判断正确性的 Reward.
- $R_{\text{format}}(y)$: 检查思考与答案标签等结构要求的 Reward.
- 两项之间的加号: 表示此处采用等权抽象. 实际系统也可以为它们设置不同权重.
在训练中的作用: Accuracy 提供任务方向, Format 提供可解析的输出容器. 极简 Reward 能减少 Learned Judge 被欺骗的风险, 但 Binary Accuracy 仍可能带来 Sparse Credit.
其中 Accuracy Reward 判断答案或程序是否通过验证, Format Reward 约束思考和最终答案放在指定结构中.
当模型只有通过正确答案才能稳定获得 Reward 时, 它可能逐步发现更长的推导, 自我检查, 回溯和替代方案探索能够提高成功率. 这些行为不是被逐字示范出来的, 而是在策略空间中通过 Selection Pressure 被保留下来的.
但 R1-Zero 也暴露出纯探索的代价, 例如可读性差, 语言混用, 通用对话能力不足. 因此完整的 DeepSeek-R1 使用多阶段流程.
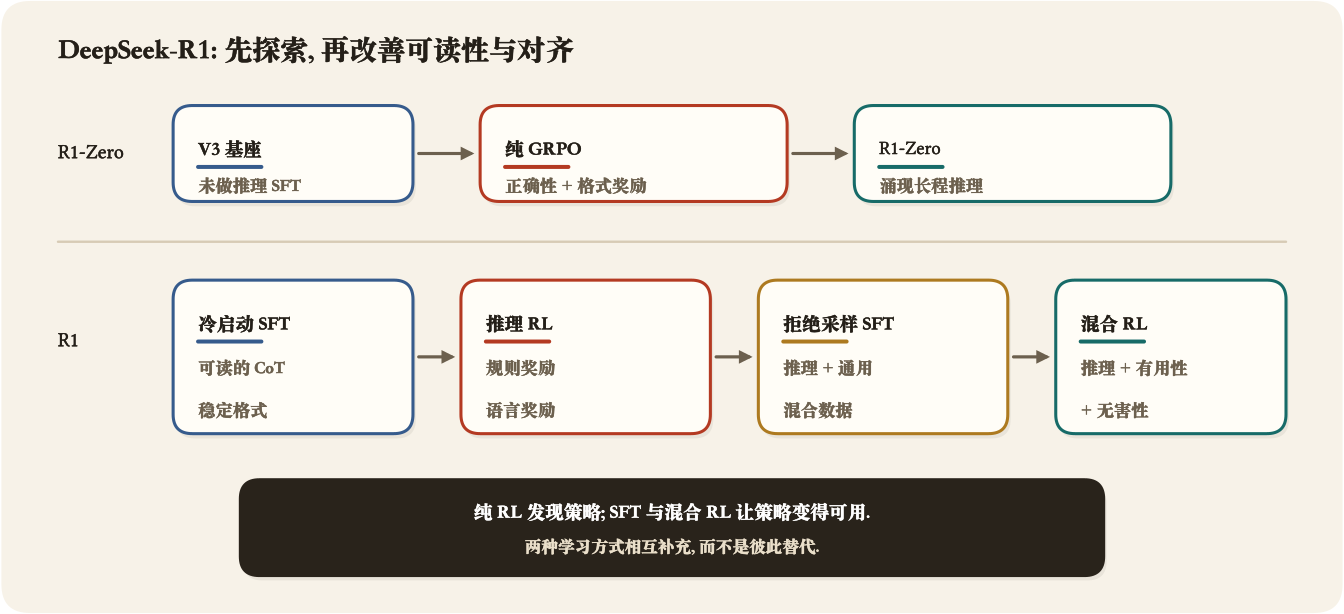
一个容易理解的版本是:
- Cold-start SFT. 用少量高质量推理数据建立清晰格式和可读表达.
- Reasoning RL. 用 Rule-based Reward 强化数学和代码推理.
- Rejection Sampling + SFT. 从强模型生成结果中筛选高质量推理数据, 再混入通用任务数据.
- Mixed RL. 同时优化推理, Helpfulness 和 Harmlessness.
DeepSeek-V3.2 进一步采用 Specialist Distillation 和 Mixed RL. 先训练数学, Coding, Reasoning, Agent 等领域专家, 再把高质量轨迹蒸馏回统一模型, 最后在同一个 RL 阶段平衡多个领域. 这种设计也有助于缓解多阶段训练中的 Catastrophic Forgetting.
最重要的结论不是 "SFT 已经不需要了". 更准确的说法是:
SFT 擅长建立语言和行为先验, RL 擅长在可评价的目标上探索. 强系统往往需要两者交替配合.
12. RL 为什么不稳定
LLM RL 的脆弱性来自 3 层不同问题.
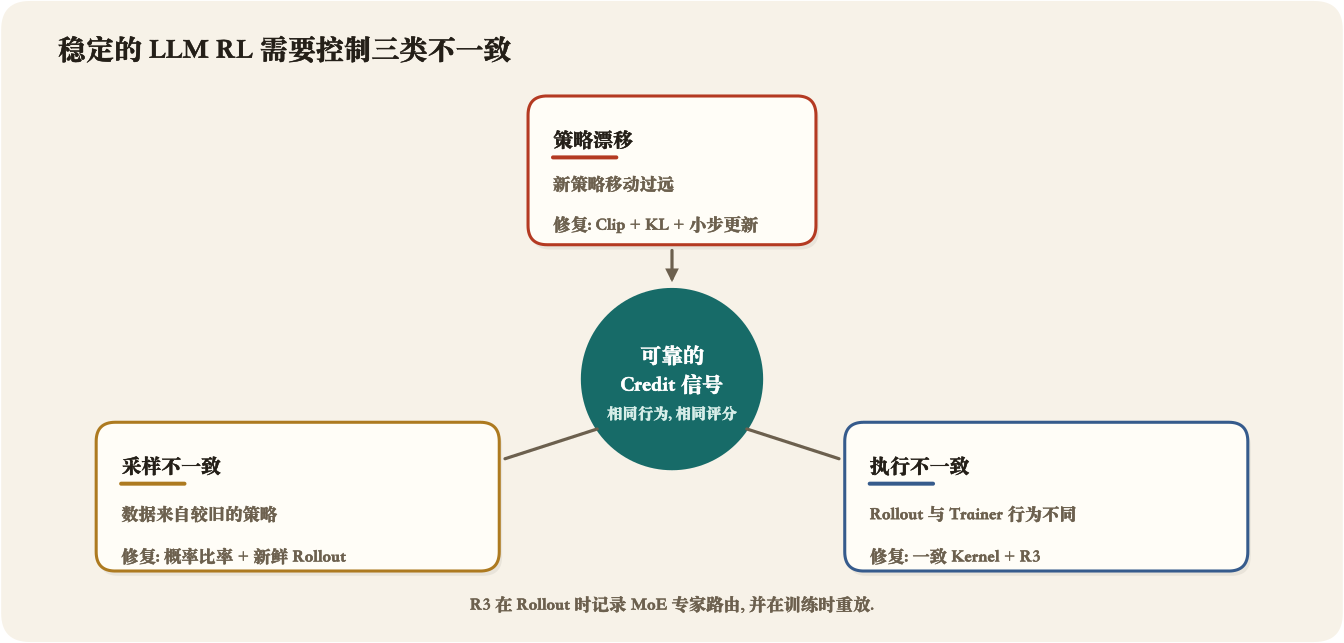
12.1 Reward 层: 模型优化了分数, 却没有优化真实目标
典型问题包括:
- Reward Hacking. 找到评分器漏洞.
- Length Hacking. 靠写得更长获得更高过程分.
- Format Hacking. 只满足格式, 内容并不正确.
- Judge Bias. 学会迎合 AI Judge 的固定偏好.
常见治理手段包括 Rule-based check, 多 Judge 交叉验证, Holdout Verifier, Adversarial Evaluation 和 Reward 分量审计.
12.2 算法层: Policy 更新太快或数据太旧
Rollout 由旧 Policy 生成, 训练时参数已经改变, 这形成 Off-policy mismatch. Ratio, Clip 和 KL 都是在控制这种偏移.
需要同时监控:
- Approx KL. 新旧 Policy 相差多远.
- Clip Fraction. 有多少 Token 已经进入裁剪区.
- Entropy. Policy 是否过早失去多样性.
- Advantage mean/std. 学习信号是否退化.
- Reward 分布. 是否出现整体抬升但真实质量下降.
- Response Length. 是否通过变长投机.
如果一个训练 Run 的 Reward 持续上涨, 但准确率不涨, KL 激增, Entropy 快速下降, 通常不是模型突然变聪明, 而是训练正在走向 Collapse 或 Reward Hacking.
12.3 系统层: Rollout 和 Training 计算的不是同一条轨迹
大规模 LLM RL 往往把 Rollout Engine 和 Training Engine 分开. 两侧可能使用不同的 Attention kernel, Quantization, Sampling 实现, 并行方式或数值精度. 即使输入 Token 完全相同, Log Probability 也可能存在偏差.
对于 Mixture-of-Experts, 即 MoE, 问题更严重. 很小的数值误差可能改变 Top-k Router 选择, 使 Rollout 和 Training 激活不同 Expert. 这时 Importance Ratio 比较的已经不只是两个版本的 Policy, 还混入了不同计算路径.
Rollout Routing Replay, 即 R3, 的核心方法是:
- Rollout 时记录每层选中的 Expert route 或 mask.
- Training 前向时强制重放相同 route.
- 让同一条 Trajectory 在两侧经过同一组 Active Parameters.
R3 解决的是 Execution Consistency. 它不能替代 PPO Clip 或 KL, 因为后两者解决的是 Policy Optimization 层的变化. 这几种机制彼此正交.
13. PPO 和 GRPO 应该怎样选择
可以用下面的简化判断:
| 问题 | PPO | GRPO |
|---|---|---|
| Advantage 来源 | Learned Critic + GAE | 同一 Prompt 的组内 Reward |
| 模型数量 | Actor, Critic, Reward, Reference | Actor, Reward/Verifier, Reference |
| 显存和系统复杂度 | 较高 | 较低 |
| Token-level Credit | 可由 Value 细化 | 常由 Sequence Reward 广播 |
| 对多样本组的依赖 | 较低 | 很高 |
| 典型场景 | 通用 RLHF, 长期回报 | 数学, Coding, RLVR |
选择算法时, 不要只看公式是否更短. 更应该问:
- 一个 Prompt 能否高效采样多个回答?
- Reward 是否足够可靠?
- 回答之间是否有足够方差?
- 是否需要细粒度 Token Credit Assignment?
- Critic 的额外成本是否能换来更稳定的训练?
- Rollout 与 Training 基础设施是否支持一致的 Log Probability?
14. 5 个常见误解
误解 1: RL 会把知识直接写进模型
RL 更擅长改变行为策略, 即在已有能力中选择哪些路径. 它也可能带来新能力, 但如果 Base Model 完全没有相关知识和表示能力, 仅靠稀疏 Reward 很难凭空学会.
误解 2: Reward 越高, 模型就越好
模型只会优化你给它的 Reward, 不会自动理解你的真实意图. Reward 指标必须和外部 Evaluation 一起看.
误解 3: CoT 越长, 推理越强
长 CoT 可能代表更充分的探索, 也可能只是啰嗦或 Length Hacking. 应关注单位 Token 带来的正确率提升和实际验证结果.
误解 4: GRPO 完全解决了 PPO 的问题
GRPO 省去了 Critic, 但仍然需要 Rollout, Importance Ratio, Clip, KL 和可靠 Reward. 它还引入了组内方差和相对排名的新依赖.
误解 5: 有了 RLVR 就不需要人类反馈
数学答案和代码可以自动验证, 但开放问答, 写作, 价值判断和安全边界仍然需要人类定义目标. 可验证 Reward 扩大了客观训练的范围, 没有消灭主观目标.
15. 用一张心智地图记住全部公式
整个 LLM RL 可以压缩成 6 个对象:
- Policy 生成:
公式含义: 给定 Prompt $x$, 从 Policy 定义的回答分布中随机采样一个完整回答 $y$. 这里不是永远选择概率最大的 Token, 而是让不同 Rollout 有机会探索不同路径.
变量说明:
- $x$: Prompt 或任务输入.
- $y$: 一次完整 Rollout.
- $\pi_\theta(\cdot\mid x)$: 参数为 $\theta$ 的条件输出分布.
- $\sim$: "采样自" 的意思, 不表示两边数值相等.
- $\cdot$: 代表所有可能回答构成的输出空间.
在训练中的作用: Sampling 决定模型能探索到哪些行为. Temperature, Top-p 等策略会改变探索范围, 进而改变后续 Reward 和梯度的数据分布.
- Judge 打分:
公式含义: Judge 把 Prompt 与模型回答映射成一个标量 Reward. 无论评价过程多复杂, Policy Optimizer 最终看到的通常都是一个或一组数值信号.
变量说明:
- $R$: 当前样本最终获得的标量 Reward.
- $R(\cdot)$: Reward Function 或 Judge, 可以是 Reward Model, Rule Verifier, AI Judge 或 Environment.
- $x$: 输入问题.
- $y$: 模型生成的回答或行动轨迹.
在训练中的作用: Reward 决定优化方向. 如果 $R$ 与真实目标不一致, Optimizer 仍会忠实地提高它, 从而产生 Reward Hacking.
- Baseline 或组内统计产生 Advantage:
公式含义: 从原始 Reward 中减去一个参考水平, 得到相对表现. 同样是 $0.8$ 分, 在平均分 $0.3$ 的组里是正 Advantage, 在平均分 $0.9$ 的组里则是负 Advantage.
变量说明:
- $\hat A$: Advantage Estimate. 帽子表示它由有限样本估计得到.
- $R$: 当前回答或步骤的 Reward / Return.
- $\text{baseline}$: 不依赖当前 Action 的参考值, 可以是 Critic 的 $V(s_t)$, Group Mean, Leave-one-out Mean 等.
在训练中的作用: Baseline 主要降低梯度方差并对齐不同 Prompt 的难度尺度. 它通常不改变 Policy Gradient 的期望方向, 但会显著改善训练稳定性.
- Importance Ratio 对齐新旧 Policy:
公式含义: 比较 New Policy 与生成数据的 Old Policy 对同一个 Token 的概率. 它告诉 Optimizer, 当前模型相对 Rollout 时已经把该动作概率改变了多少.
变量说明:
- $r_t(\theta)$: 第 $t$ 步 Importance Ratio.
- $\pi_\theta$: Current / Train Policy.
- $\pi_{\theta_{\text{old}}}$: Behavior / Rollout Policy.
- $y_t$: 实际采样的 Token.
- $s_t$: 采样 $y_t$ 时的上下文.
- $\theta$ 和 $\theta_{\text{old}}$: 当前参数与生成 Rollout 时的参数快照.
在训练中的作用: Ratio 使 Old Policy 数据可以被 Current Policy 近似重用. 若 Ratio 远离 $1$, 说明样本已经过旧, 方差和优化风险都会增加.
- Clip 限制单次更新:
公式含义: 在原始策略收益与裁剪后的保守收益之间取较小值. 当概率变化仍在可信范围内时正常学习, 超出范围后停止奖励更激进的变化.
变量说明:
- $r_t$: Token-level New / Old Probability Ratio.
- $\hat A_t$: 第 $t$ 步 Advantage Estimate.
- $\epsilon$: 允许 Ratio 偏离 $1$ 的范围.
- $\operatorname{clip}$: 将 Ratio 压到 $[1-\epsilon,1+\epsilon]$.
- $\min$: 实现 Conservative Objective, 避免挑选对 Policy 过度乐观的一支.
在训练中的作用: Clip 是 PPO 的局部安全带. 它控制一次 Batch Reuse 期间的更新幅度, 但不能替代长期 KL 约束或数据新鲜度管理.
- KL 约束长期漂移:
公式含义: 在要最大化的 Objective 中减去 KL Divergence. Current Policy 离 Reference 越远, 扣分越多.
变量说明:
- $D_{\mathrm{KL}}$: Current Policy 与 Reference Policy 的分布差异.
- $\pi_\theta$: 正在训练的 Policy.
- $\pi_{\text{ref}}$: 冻结的 Reference Policy.
- $\beta$: KL Penalty 强度.
- 前面的负号 $-$: 表示偏离 Reference 会降低最大化目标.
在训练中的作用: KL 提供长期 Behavior Anchor, 防止模型为了 Reward 丢失语言质量或安全能力. 它约束偏移, 但不产生任务改进方向.
因此, 不论算法名叫 PPO, GRPO 或其他变体, 都可以沿着下面 4 个问题去理解:
- Sample. 数据由谁生成?
- Score. Reward 由谁给出?
- Credit. Reward 怎样分配给 Token?
- Constrain. 如何防止 Policy 一次走得太远?
只要这 4 个问题回答清楚, 大部分 LLM RL 论文的主干就已经清楚了.
16. 从 Chatbot 到 Agent RL
当 LLM 只回答一次问题时, 一段 Response 就是一条 Episode. 到 Agent RL 中, 模型会多轮调用搜索, 浏览器, 代码执行器, 数据库和其他工具. 此时:
- State 不再只是文本前缀, 还包含 Environment Observation.
- Action 不再只是自然语言 Token, 还包含 Tool Call 和结构化参数.
- Reward 不再只看最终答案, 还要看任务是否完成, 成本, 时延, 安全和恢复能力.
- Credit Assignment 跨越更长时间, 一个早期决策可能在几十步后才显出后果.
Agent RL 的目标可以写成长期回报:
公式含义: Agent Policy 产生完整交互轨迹 $\tau$, 每一步都可能收到 Reward. 将各步 Reward 按时间折扣后累加, 再对可能轨迹求平均, 就得到要最大化的长期回报.
变量说明:
- $J(\theta)$: Agent Policy 的 Expected Discounted Return.
- $\theta$: Agent Policy 参数.
- $\tau$: 完整 Trajectory, 包括 Observation, Reasoning, Tool Call, Environment Transition 和 Response.
- $\tau\sim\pi_\theta$: 轨迹由当前 Policy 与 Environment 交互产生.
- $t$: 交互步骤索引, 从 $0$ 到终止步 $T$.
- $T$: Episode Horizon 或实际终止时间.
- $r_t$: 第 $t$ 步即时 Reward. 此处是环境奖励, 不是 Importance Ratio.
- $\gamma\in[0,1]$: Discount Factor.
- $\gamma^t$: 第 $t$ 步 Reward 折算到初始时刻的权重.
- $\sum_{t=0}^{T}$: 累积整条轨迹上的 Discounted Reward.
- $\mathbb E$: 对不同任务, Sampling 和 Environment Randomness 取平均.
如何解读 $\gamma$: $\gamma$ 接近 $0$ 时更看重立即收益, 接近 $1$ 时更重视长期任务成功. 对有限长度且只在结尾给分的任务, 常把最终 Reward 传播回之前的所有关键决策.
在训练中的作用: 这是从 Single-turn Chatbot 走向 Agent RL 的标准目标. 难点随 Horizon 增长而加剧, 包括 Credit Assignment, Exploration, Tool Error Recovery 和 Off-policy Drift.
这时 LLM RL 又重新接近传统 RL 的完整形态: 模型不只是生成一个答案, 而是在环境中持续观察, 决策, 行动, 接收反馈并修正计划.
结语
LLM RL 的本质并不神秘. 它是在概率模型上建立一个试错闭环:
- 用 SFT 建立可用的行为先验.
- 用 Rollout 让模型亲自尝试.
- 用 Human, AI, Reward Model 或 Verifier 把结果变成 Reward.
- 用 Advantage 判断哪些行为比预期更好.
- 用 PPO 或 GRPO 提高好行为的概率.
- 用 Clip, KL 和系统一致性机制控制更新风险.
- 不断重复, 并用独立 Evaluation 检查模型是否真的变好.
从 RLHF 到 RLVR, 从 PPO 到 GRPO, 从 Chatbot 到 Agent, 变化的是 Reward 的来源, Credit 的粒度和 Environment 的复杂度. 不变的是同一个原则:
模型不会自动追求我们心里的目标. 它只会追求我们真正交给它的优化信号.
延伸阅读
本文的内容基于同目录下的四篇系列文章整理: